Decyzje architektoniczne (ADR)
Każdy zapis podaje decyzję, kontekst, w którym ją podjęto, to, ile nas kosztuje, i to, co odrzuciliśmy. Zapisów nigdy nie edytuje się po przyjęciu. Zmiana zdania oznacza nowy ADR, który zastępuje stary.
| ADR | Decyzja | Stan |
|---|---|---|
| 001 | TypeScript dla silnika | Przyjęty |
| 002 | web-tree-sitter (WASM), a nie natywne wiązania | Przyjęty |
| 003 | Dystrybucja jako jednoplikowy program wykonywalny Buna | Przyjęty, budowany z --bytecode od #39 |
| 004 | Parsuj szkielet importów, potwierdzaj pełnym parsowaniem | Przyjęty, moduły w baseline'ie pomijają parsowanie potwierdzające od #108 |
| 005 | Konfiguracja mieszka w pyproject.toml |
Przyjęty |
| 006 | Silnik nie wykonuje operacji wejścia-wyjścia | Przyjęty, od #44 adapter dostarcza indeks modułów przez port ProjectFiles |
| 007 | Wersjonowany kontrakt wyjścia z krokami naprawy jako danymi | Przyjęty |
| 008 | Serwer języka na Node wewnątrz rozszerzenia, na razie | Zastąpiony przez 041; nazwę inwards server i jego miejsce obok daemona hooków ustala 039 |
| 009 | Sprawdzaj importy, gdziekolwiek się pojawią | Przyjęty |
| 010 | Dokumentacja budowana Zensicalem, serwowana przez Cloudflare Workers | Hosting zastąpiony przez 012 |
| 011 | Zmiana nazwy ze Stratum na Inwards | Przyjęty |
| 012 | Publikuj dokumentację na GitHub Pages, na razie | Przyjęty, wdrażana z develop od 019 |
| 013 | Rzeczywiste ścieżki dla granicy, ścieżki importu dla nazw modułów | Przyjęty, dowiązania symboliczne w warstwach ukrywające kod zgłaszane od #83 i #84 |
| 014 | Zgłaszaj pliki, których zadeklarowane kodowanie może ukryć importy | Przyjęty |
| 015 | Sprawdzaj dosłowne importy dynamiczne jako INW011 | Przyjęty, niesprawdzalne cele zgłaszane od 026 |
| 016 | Wersje i wydania wynikają z typów commitów, przez release PR | Model gałęzi zastąpiony przez 019 |
| 017 | Scalanie przez squash z tytułami PR w formacie Conventional Commits | Przyjęty, squash do develop od 019 |
| 018 | Selektory pakietów przyjmują globy od początku; monorepo podąża za workspace'ami uv | Przyjęty |
| 019 | Gałąź integracyjna develop; main przesuwa się tylko przy wydaniach |
Przyjęty |
| 020 | Kreator w init używa @clack/prompts, ładowanego z osobnego fragmentu |
Przyjęty |
| 021 | Publikuj wheele wydań na PyPI z osobnego workflow, przez trusted publishing | Przyjęty, włączany przez właściciela |
| 022 | Decyzja „go/no-go” po M2: kontynuujemy warunkowo, do czasu danych od partnerów | Przyjęty, tymczasowo do czasu danych od partnerów |
| 023 | Biblioteki w warstwach, z domyślną listą zakazów dla najbardziej wewnętrznej warstwy | Przyjęty, od #155 extend-deny-libraries dopisuje wpisy do listy domyślnej |
| 024 | Polskie tłumaczenie jako drugi build, tłumaczone w tym samym PR | Przyjęty |
| 025 | INW010 sonduje dysk, żeby ustalić, czy moduł istnieje, i sprawdza tylko część importu będącą modułem | Przyjęty, moduły generowane przechodzą, gdy ich brakuje, od 029 |
| 026 | Zgłaszaj nieczytelne cele importów dynamicznych w warstwach wewnętrznych | Przyjęty |
| 027 | select, ignore i severity dla każdej reguły w tabeli [tool.inwards.rules] |
Przyjęty, serwer języka czyta tabelę ponownie bez restartu od #163 |
| 028 | Wyciszenie w linii wymaga powodu, a agent domyślnie nie może go dodać | Przyjęty |
| 029 | Moduły generowane przechodzą INW010, domyślnie moduły z protoc i moduły wersji | Przyjęty |
| 030 | Konteksty ograniczone jako tabela contexts z dosłownymi prefiksami |
Przyjęty |
| 031 | Pamięć podręczna ekstrakcji kluczowana treścią, której hooki nigdy nie czytają | Przyjęty |
| 032 | Cykle importów przy sprawdzaniu całego projektu, z importów, które sprawdzenie i tak czyta | Przyjęty |
| 033 | OpenCode przez plugin, który uruchamia hook Claude Code | Przyjęty |
| 034 | Selektory warstw zakotwiczone w pakiecie najwyższego poziomu, ze sprawdzaniem wycinków w sesji | Przyjęty |
| 035 | inwards check idzie za członkami workspace'u uv, każdy z własną konfiguracją |
Przyjęty |
| 036 | Szablony pakietów rozwijają się w konfigurację, którą użytkownik mógłby napisać ręcznie | Przyjęty |
| 037 | Rodziny reguł dla frameworków, opt-in, z własnym prefiksem | Przyjęty |
| 038 | Kopia startu sesji poza projektem, przeciw odtworzonemu SessionStart | Przyjęty |
| 039 | Daemon hooków dla każdego projektu, osobno od serwera języka | Przyjęty |
| 040 | Wątki robocze parsują duże pełne sprawdzenie; wątek główny podejmuje każdą decyzję | Przyjęty |
| 041 | inwards server używa kodu inwards check; serwer Node rozszerzenia zostaje do jego przełączenia |
Przyjęty, rozszerzenie przełączone w 043 |
| 042 | inwards mcp odpowiada sprawdzeniem inwards check, na tekstach nałożonych na dysk |
Przyjęty |
| 043 | Rozszerzenie VS Code zawiera plik binarny, jeden VSIX na platformę | Przyjęty |
| 044 | Copilot przez punkt wejścia inwards hook copilot i zacommitowany plik hooków |
Przyjęty, budowany po nagraniu danych wejściowych w #320 |
| 045 | Diagramy architektury są sprawdzane względem [tool.inwards], a nigdy nie są czytane jako konfiguracja |
Przyjęty, INW017 od #344, INW018 i import-diagram od #345 |
| 046 | Porty strukturalne, linie zgodności i moduły prywatne to reguły opt-in, a wycinki CQRS to szablon | Przyjęty, #407 |
| 047 | TypeScript w pionowych wycinkach, przenoszony małymi PR-ami | Przyjęty |
ADR-001: TypeScript dla silnika
Stan: Przyjęty · 2026-09-25
Kontekst. Każdy szybki linter, któremu się przyjrzeliśmy (Ruff, ty, Biome, nowy rdzeń grimp, Tach), jest napisany w Ruście. Rust daje najlepszą surową szybkość i najmniejsze pliki binarne. Ale trudnym problemem Inwards nie jest szybkość parsowania. Jest nim powierzchnia produktu: semantyka reguł, tekst poprawek, integracje z agentami i rozszerzenie edytora. Ta powierzchnia wymaga szybkiej iteracji. Proces rozszerzeń VS Code uruchamia JavaScript, więc silnik w TypeScripcie działa tam w tym samym procesie, bez drugiego buildu.
Decyzja. Napisać silnik w TypeScripcie i traktować szybkość jako problem architektury (co parsujemy i kiedy), a nie problem języka.
Konsekwencje.
- Jeden język w silniku, CLI, serwerze języka i rozszerzeniu. Osoba, która poprawia regułę, widzi efekt we wszystkich trzech.
- Duża pula programistów TypeScriptu i szybkie prototypowanie funkcji dla agentów.
- Plik binarny Buna jest duży (82 MB dla Linuksa x64, zmierzone) w porównaniu z plikiem z Rusta.
- Parsowanie jest wolniejsze. Tree-sitter w WASM osiąga w naszym benchmarku około 1,3 MB/s na rdzeń. ADR-004 istnieje właśnie z tego powodu.
- Jeśli hipoteza techniczna upadnie na prawdziwych repozytoriach, planem awaryjnym jest przeniesienie prescanu i grafu do modułu WASM w Ruście albo Zigu, który wywołuje silnik w TypeScripcie. Reszta zostaje.
Alternatywy. Rust: najlepsza wydajność, ale zestaw dla agentów, reguły i rozszerzenie rozwijałyby się wolniej, a konkurowalibyśmy z Astral na jego terenie. Python: tak robią import-linter i pytest-archon. Wymaga środowiska użytkownika, a grimp i tak musiał przejść na Rusta dla szybkości.
ADR-002: web-tree-sitter (WASM), a nie natywne wiązania
Stan: Przyjęty · 2026-09-25
Kontekst. tree-sitter ma dwa wiązania dla JavaScriptu. Natywny dodatek dla Node (tree-sitter 0.25.1) jest szybszy, ale zgłoszenie tree-sittera #5939 dokumentuje, że nie działa pod bun run i bun build --compile („To load Node-API modules, use require()…”). Nie potrafi też rozwiązać ścieżek do swoich prebuildów wewnątrz skompilowanego pliku binarnego. Kompilacja skrośna oznaczałaby dostarczanie jednego prebuildu .node na platformę, a tree-sitter-python nie publikuje żadnego dla musl. Wiązanie WASM (web-tree-sitter 0.27.0) jest przenośne, a tree-sitter-python dostarcza gramatykę .wasm w swoim pakiecie npm.
Decyzja. Używać web-tree-sitter z tree-sitter-python.wasm. CLI osadza oba pliki .wasm w pliku binarnym przez import … with { type: "file" }. Silnik dostaje bajty przez port GrammarBinaries i nigdy nie szuka ich na dysku. To omija też znaną pułapkę, w której web-tree-sitter szuka swojego .wasm obok swojego pliku JS.
Konsekwencje.
- Jeden runner linuksowy kompiluje skrośnie wszystkie sześć platform. Potok CD udowadnia to przy każdym tagu, uruchamiając każdy plik binarny na jego natywnym systemie.
- Te same bajty działają w Bunie, w Node, a później w przeglądarkowym playgroundzie.
- Parsowanie w WASM jest wolniejsze niż natywne. Sami jeszcze nie zmierzyliśmy tej różnicy.
- Drzewa żyją w pamięci WASM i trzeba je zwalniać ręcznie (
tree.delete()). Silnik robi to w blokufinally.
Alternatywy. Natywny dodatek: zablokowany przez problem z Bunem i przez kompilację skrośną. Ręcznie napisany lekser importów: szybki, ale musiałby odtworzyć reguły Pythona dotyczące napisów, nawiasów i kontynuacji linii. Prescan z ADR-004 bierze tanią część tego pomysłu i oddaje wszystko, co trudne, z powrotem tree-sitterowi.
ADR-003: Dystrybucja jako jednoplikowy program wykonywalny Buna
Stan: Przyjęty · 2026-09-25
Kontekst. Użytkownicy oczekują uv add --dev <linter> i pliku binarnego, który startuje natychmiast, tak jak Ruff i ty. Proszenie zespołów pythonowych o instalację Node nie wchodzi w grę. --compile w Bunie obsługuje Linuksa (glibc i musl), macOS i Windows na x64 i arm64 oraz osadza zasoby.
Decyzja. Dystrybuować inwards jako jeden plik wykonywalny na platformę, budowany przez bun build --compile (zobacz scripts/build-binaries.ts). Później opakować każdy plik binarny w wheel platformowy publikowany jako inwards na PyPI (nazwę opisuje ADR-011).
Konsekwencje.
- Bez wymagań co do środowiska. Zmierzone: około 25 ms czasu rzeczywistego na sprawdzenie jednego pliku, łącznie ze startem procesu.
- Tagi automatycznie produkują zweryfikowane pliki binarne (
cd.yml). - 82 MB na plik binarny, a każdy wheel platformowy będzie zawierał jeden taki plik. Flaga
--bytecodeBuna i minifikacja to pierwsze rzeczy do wypróbowania, jeśli chodzi o start i rozmiar. - Zależymy od rytmu wydań Buna i od tego, że jego funkcja kompilacji pozostanie stabilna.
Alternatywy. Pakiet npm: wymaga Node na maszynie użytkownika. Node SEA (single executable applications): wykonalne, ale Bun daje nam kompilację skrośną, osadzanie zasobów, bundler i test runner w jednym narzędziu. Deno compile: realne, ale test runner, bundler i menedżer pakietów Buna w jednym narzędziu utrzymują monorepo prostszym.
ADR-004: Parsuj szkielet importów, potwierdzaj pełnym parsowaniem
Stan: Przyjęty · 2026-09-25
Kontekst. Nasza pierwsza implementacja parsowała w całości każdy plik. Na syntetycznym repozytorium z 2100 plikami i 496 tys. linii (8 MB) zimne uruchomienie trwało 7,5 s, z czego 6,1 s zajmowało parsowanie tree-sitterem. Reguły architektury potrzebują tylko importów, a w prawdziwym kodzie importy stoją we własnych liniach logicznych. Parsowanie samych linii importów w tym samym repozytorium trwało 0,27 s.
Decyzja. Przed parsowaniem zbudować szkielet importów: zachować linie, które zaczynają instrukcję importu (łącznie z kontynuacjami w nawiasach i po ukośniku wstecznym), usunąć im wcięcie, a każdą inną linię wyczyścić, żeby numery linii pozostały poprawne. Sparsować szkielet i uruchomić reguły. Jeśli prescan napotka słowo import w miejscu, którego nie umie wyjaśnić (x = 1; import os, if a: import b, linia docstringa), odmawia przetworzenia pliku, a silnik parsuje go w całości. Linie komentarzy są pomijane, bo komentarz nie może ukryć importu. Jeśli szkielet daje naruszenie, silnik potwierdza je pełnym parsowaniem przed zgłoszeniem, co usuwa fałszywe alarmy z tekstu wyglądającego jak import wewnątrz napisów.
Konsekwencje.
- Zimne pełne uruchomienie na tym samym repozytorium: 0,63 do 0,96 s, około 8 do 12 razy szybciej, nadal na jednym rdzeniu.
- Poprawność jest zakotwiczona w pełnym parsowaniu i to testujemy, zamiast zakładać.
src/core/scripts/prescan-diff.tswyciąga importy z każdego pliku korpusu na oba sposoby i kończy się błędem, jeśli szkielet któryś pominie. Na bibliotece standardowej CPythona 3.14 (1921 plików) nie pomija żadnego, znajduje 33 dodatkowe, które parsowanie potwierdzające odrzuca, i odmawia 8,3 % plików, które dostają wtedy pełne parsowanie. CI uruchamia go przy każdym pushu na pełnej bibliotece standardowej CPythona 3.14 (2273 pliki) i kończy się błędem, jeśli ten korpus ma mniej niż 1500 plików. Testy jednostkowe obejmują przypadki zagnieżdżone, w nawiasach, ze średnikami i w docstringach.
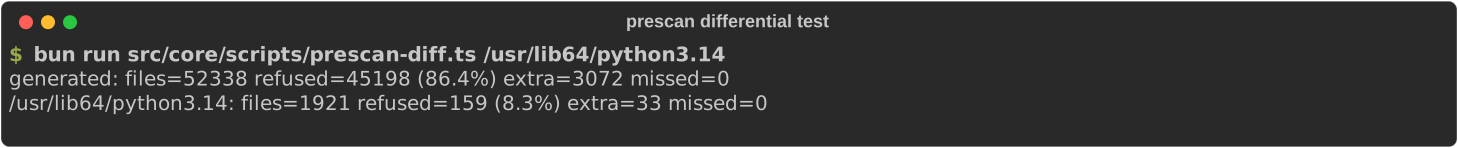
- Przegląd znalazł prawdziwą lukę, której korpus nigdy nie pokazał:
from shop.infrastructure \zimport sql_ordersw następnej linii było odczytywane jakoimport sql_orders, a naruszenie nie było zgłaszane. Prescan odmawia teraz każdego pliku, w którym linia wspominającaimportnastępuje po kontynuacji ukośnikiem wstecznym. Biblioteka standardowa nie ma takich zapisów, więcprescan-diffgeneruje teraz także własny korpus: 58 zapisów importów (kontynuacje, średniki, jednolinijkoweif/try, napisy i komentarze wokół importów, spacje w nazwach z kropkami, tabulatory, CRLF, BOM), łączonych w pary oraz w trójki z kontekstem napisów: 52 338 plików w mniej niż 1 s. Jego pierwsze uruchomienie znalazło drugą lukę: napis zawierającyfrom a import (doklejał następujący po nim prawdziwy kod do fałszywego importu. Silnik odrzuca teraz każdy szkielet, który nie parsuje się czysto, i wraca do pełnego parsowania. Kolejny przegląd znalazł tę samą sztuczkę z czystym parsowaniem:import a; t = '''wewnątrz jednego napisu otwiera w szkielecie nowy napis, który połyka prawdziwy import pod nim. Dlatego szkielet jest też odrzucany, jeśli zawiera cokolwiek poza instrukcjami importu i komentarzami. Oba zapisy są teraz w generatorze (972 przeoczenia bez drugiego zabezpieczenia, zero z nim), a odsetek odmów na bibliotece standardowej się nie zmienił. - Samotne
\rkończy linię w Pythonie, ale nie w tree-sitterze, więc# note\rimport xukrywało prawdziwy import wewnątrz komentarza nawet przed pełnym parsowaniem. Silnik zamienia samotne\rna\nprzed parsowaniem. Test różnicowy nie widzi tej klasy błędów, bo obie strony dzielą parser, więc pilnuje tego test jednostkowy. - Pliki z naruszeniami płacą za dwa parsowania. W starszym repozytorium z wieloma naruszeniami zbliża się to do kosztu naiwnego podejścia, dopóki baseline (UC6) nie pozwoli silnikowi pomijać ponownego potwierdzania znanych naruszeń.
- Przyszłe reguły, które potrzebują czegoś więcej niż importów (na przykład „żadnych dekoratorów frameworków w domenie”), nie mogą używać szkieletu i będą potrzebowały własnej szybkiej ścieżki albo pełnego parsowania.
Alternatywy. Pełne parsowanie z pamięcią podręczną po hashu zawartości: i tak dodamy pamięć podręczną, ale nie pomaga ona zimnym uruchomieniom w CI ani pierwszemu uruchomieniu. Przyrostowe parsowanie tree-sittera: przydatne w edytorze, gdzie trzymamy stare drzewo, i bezużyteczne dla świeżego procesu CLI. ruff analyze graph jako źródło importów: szybkie i oparte na Ruście, ale robi z Ruffa twardą zależność, zgłasza krawędzie plik–plik bez linii i kolumny (więc bez precyzyjnych diagnostyk) i zaczynało jako polecenie w wersji preview.
ADR-005: Konfiguracja mieszka w pyproject.toml
Stan: Przyjęty · 2026-09-25
Kontekst. Narzędzia pythonowe ujednoliciły się wokół [tool.<name>] w pyproject.toml (Ruff, pytest, mypy, uv). import-linter używa też .importlinter albo setup.cfg.
Decyzja. Czytać [tool.inwards] z najbliższego pyproject.toml, idąc w górę od katalogu roboczego, albo z --config. Warstwy to uporządkowana lista, od najbardziej wewnętrznej. Moduł może importować własną warstwę i każdą warstwę wymienioną przed nią.
Konsekwencje.
- Żadnego nowego pliku i jedno oczywiste miejsce, w którym trzeba szukać.
- Uporządkowane warstwy sprawiają, że typowy przypadek (ścisła cebula) to konfiguracja na cztery linie.
- Konfiguracja siedzi w pliku, który agenci często edytują ze względu na zależności. Jej ochrona wymaga hooka albo CODEOWNERS zamiast osobnego pliku z osobnymi uprawnieniami. Config guard opisuje rozdział 4.
- Reguły nieliniowe (wycinki, które nie mogą się nawzajem widzieć, „tylko przez
api.py”) będą później wymagały więcej składni. Będą to osobne tabele, więc prosty przypadek pozostanie prosty.
Alternatywy. inwards.toml: łatwiej go zablokować, ale to jeszcze jeden plik. Możemy go jeszcze obsłużyć jako opcję. Konfiguracja w Pythonie (jak w pytest-archon): wymagałaby wykonywania kodu użytkownika, co kłóci się z ADR-006.
ADR-006: Silnik nie wykonuje operacji wejścia-wyjścia
Stan: Przyjęty · 2026-09-25
Kontekst. Silnik działa w dwóch hostach z różnym wejściem-wyjściem: w pliku binarnym Buna z osadzonymi plikami i w serwerze języka na Node z plikami na dysku i niezapisanymi buforami w pamięci. Później będzie działał w testach, w serwerze MCP, a może w przeglądarce.
Decyzja. @inwards/core przyjmuje zwykłe dane (SourceFile[], tekst konfiguracji, GrammarBinaries) i zwraca zwykłe dane. Znajdowanie plików, ich czytanie, osadzanie gramatyk i wybór miejsca, do którego trafia wyjście, należą do adapterów. biome.json pilnuje strony środowiska uruchomieniowego, zakazując globalnych Bun i Deno w src/core/src.
Konsekwencje.
- Edytor sprawdza niezapisany bufor, a CLI plik na dysku, tą samą funkcją.
- Testy nie potrzebują katalogów tymczasowych. Przekazują napisy.
- Reguły międzyplikowe (cykle, nieznane moduły) wymagają, żeby adapter dostarczył indeks modułów. API silnika dostanie wejście „project”, gdy te reguły się pojawią.
Alternatywy. Silnik sam czyta pliki: prostsze na początku, ale przywiązałoby silnik do API plików jednego środowiska i skomplikowało przypadek edytora.
ADR-007: Wersjonowany kontrakt wyjścia z krokami naprawy jako danymi
Stan: Przyjęty · 2026-09-25
Kontekst. Agenci i skrypty parsują nasze wyjście. Każda niezapowiedziana zmiana psuje komuś hook. SARIF to standard dla interfejsów code scanning, a GitHub przyjmuje go przez github/codeql-action/upload-sarif.
Decyzja. Wyjście JSON zawiera "schema": "inwards/diagnostics@1". W ramach głównej wersji pola można dodawać, ale nigdy nie zmieniać ich nazw ani ich nie usuwać. Każda diagnostyka ma fix.summary i fix.steps[], zbudowane z faktycznych nazw importu i warstw. SARIF 2.1.0 niesie te same kroki w message.text i properties.fix. Gdy stdout nie jest terminalem, wyjście jest zwięzłe.
Konsekwencje.
- Hooki i agenci mogą polegać na tej strukturze.
- Jakość poprawek staje się testowalna: testy sprawdzają kroki.
- Tekst poprawek jest teraz API. Przeredagowanie go nie szkodzi modelom, ale może zepsuć testy snapshotowe, które ludzie piszą przeciwko nam.
Alternatywy. Niewersjonowany JSON: częsty wybór (Biome oznacza swój reporter JSON jako eksperymentalny), ale przerzuca ryzyko na integracje, na których nam najbardziej zależy.
ADR-008: Serwer języka na Node wewnątrz rozszerzenia, na razie
Stan: Zastąpiony przez ADR-041 · 2026-09-25 · ADR-039 zostawia inwards server dla serwera języka i daje hookom osobny inwards daemon
Kontekst. Ruff i ty dostarczają swój serwer języka w tym samym pliku binarnym (ruff server). Dzięki temu każdy edytor obsługujący LSP (Neovim, Zed, Helix) dostaje serwer za darmo. Scaffold Inwards zamiast tego dołącza serwer LSP na Node do rozszerzenia VS Code, obok plików gramatyk.
Decyzja. Trzymać serwer na Node w rozszerzeniu, dopóki CLI nie będzie miał stabilnego podpolecenia inwards server. Wtedy rozszerzenie stanie się cienkim klientem, który uruchamia plik binarny, a serwer na Node zostanie usunięty.
Konsekwencje.
- Działa już dziś, bez pobierania pliku binarnego przez rozszerzenie.
- Silnik jest pakowany na dwa sposoby. Zgodność obu wariantów pilnują zabezpieczenie środowiska uruchomieniowego (ADR-006) i build rozszerzenia w CI.
- Inne edytory czekają na
inwards server.
Alternatywy. inwards server już teraz: lepszy stan docelowy, ale wymaga obsługi LSP przez stdio w pliku binarnym i kroku pobierania w rozszerzeniu. To więcej, niż powinien dźwigać scaffold.
ADR-009: Sprawdzaj importy, gdziekolwiek się pojawią
Stan: Przyjęty · 2026-09-25
Kontekst. pytest-archon pozwala użytkownikom pomijać importy z TYPE_CHECKING i patrzeć tylko na importy najwyższego poziomu. Dla ludzi to rozsądne opcje. Dla agentów to furtki: przeniesienie importu do ciała funkcji albo do bloku TYPE_CHECKING to najtańszy sposób, żeby uciszyć narzędzie, które je ignoruje.
Decyzja. INW001 sprawdza każdy import w pliku: na najwyższym poziomie, zagnieżdżony w funkcjach albo klasach i pod if TYPE_CHECKING:. Importy względne i from package import submodule są najpierw rozwiązywane.
Konsekwencje.
- Typowe obejścia nie działają, a tekst poprawki mówi o tym z góry.
- Zespoły, które celowo dopuszczają odwołania do warstw zewnętrznych tylko na potrzeby typów, będą chciały opcji wyłączenia. Jeśli ją dodamy, będzie ustawiana dla pary warstw i domyślnie wyłączona.
Alternatywy. Tylko importy najwyższego poziomu: szybciej się to wyjaśnia i łatwo to obejść.
ADR-010: Dokumentacja budowana Zensicalem, serwowana przez Cloudflare Workers
Stan: Przyjęty · 2026-09-25 · część dotycząca hostingu zastąpiona przez ADR-012
Kontekst. Dokumentacja to Markdown z diagramami Mermaid i ikonami. Zensical, od zespołu Material for MkDocs, czyta zensical.toml, natywnie renderuje Mermaid i dołącza zestawy ikon Material. Jeśli chodzi o hosting, aktualna dokumentacja Cloudflare kieruje nowe strony statyczne do statycznych zasobów Workers, konfigurowanych blokiem assets w wrangler.jsonc.
Decyzja. docs/zensical.toml buduje docs/chapters/ do docs/site/. docs/wrangler.jsonc deklaruje Workera złożonego wyłącznie z zasobów (inwards-docs). .github/workflows/docs.yml buduje z --clean --strict i wdraża przez cloudflare/wrangler-action@v4 przy pushach do main. CI buduje dokumentację przy każdym pull requeście, więc zepsuta strona oblewa sprawdzenie przed scaleniem.
Konsekwencje.
- Żadnego kodu Workera do utrzymania. Cloudflare serwuje pliki bezpośrednio, z prawdziwą stroną 404.
- Zensical jest młody (0.0.x). Jego dokumentacja na razie odradza pamięć podręczną buildu w CI, stąd
--clean. - Wymaga dwóch sekretów repozytorium:
CLOUDFLARE_API_TOKENiCLOUDFLARE_ACCOUNT_ID.
Alternatywy. GitHub Pages: prostsze uwierzytelnianie, ale bez funkcji na brzegu sieci, gdybyśmy później chcieli przekierowań albo API do przeszukiwania reguł. Cloudflare Pages: nadal działa. Wybraliśmy Workers, żeby iść za aktualnymi zaleceniami Cloudflare i zostawić miejsce na małego Workera w przyszłości (przekierowania, endpoint wyszukiwania reguł).
ADR-011: Zmiana nazwy ze Stratum na Inwards
Stan: Przyjęty · 2026-09-25
Kontekst. Robocza nazwa „Stratum” była zajęta na PyPI, npm i crates.io. Gorzej, w świecie Pythona nazywa protokół pul wydobywczych Bitcoina: pakiet stratum na PyPI to serwer wydobywczy oparty na Twisted, a najpopularniejsze repozytoria pythonowe na GitHubie o nazwie „stratum” to serwery i proxy wydobywcze. Programista szukający lintera trafiłby na oprogramowanie do kopania kryptowalut. Dnia 2026-09-25 sprawdziliśmy około tuzina alternatyw na PyPI i npm.
Decyzja. Projekt, polecenie i tabela konfiguracji nazywają się Inwards: inwards check, [tool.inwards], pakiet inwards na PyPI i npm (oba wolne tego dnia) oraz kody reguł od INW001 w górę. Nazwa wyraża regułę, której narzędzie pilnuje: zależności wskazują do środka (inwards).
Konsekwencje.
- Jedna nazwa wszędzie: repozytorium, plik binarny, wheel na PyPI, tabela konfiguracji i prefiks reguł.
- Brak kolizji w naszym obszarze. Wyszukiwanie na GitHubie 2026-09-25 znalazło tylko małe, niezwiązane projekty o nazwie Inwards (panel z danymi o wodzie, widżet Fluttera, gra), żaden z nich nie jest narzędziem dla Pythona.
- „Inwards” to zwykłe angielskie słowo, więc wyszukiwania wymagają dopisku „linter” albo „python”.
- Identyfikator schematu JSON zmienił się na
inwards/diagnostics@1przed jakimkolwiek wydaniem, więc nic poza tym repozytorium nie zależało od starego.
Alternatywy. Zostawić Stratum i publikować jako stratum-lint: bez pracy nad zmianą nazwy, ale kolizja z protokołem wydobywczym zostaje na zawsze. strataguard, layerly, onion-lint, tierlint: wszystkie wolne, żadna nie mówi tak bezpośrednio, co robi narzędzie.
ADR-012: Publikuj dokumentację na GitHub Pages, na razie
Stan: Przyjęty · 2026-09-25 · zastępuje część dotyczącą hostingu z ADR-010
Kontekst. Pierwsze wdrożenie na Cloudflare się nie udało: jedyny dostępny token API był ograniczony do Cloudflare Tunnel, a API Workers odpowiadało „No access to the specified resource”. Dokumentacja nie powinna czekać na nowy token.
Decyzja. .github/workflows/docs.yml buduje Zensicalem i publikuje docs/site/ przez actions/upload-pages-artifact i actions/deploy-pages. Ścieżka Cloudflare zostaje gotowa, ale uśpiona: docs/wrangler.jsonc jest bez zmian, a .github/workflows/docs-cloudflare.yml wdraża ją przy ręcznym uruchomieniu, gdy pojawi się token z uprawnieniem Workers Scripts: Edit.
Konsekwencje.
- Żadnych poświadczeń od stron trzecich. Pages używa własnego tokena OIDC workflow.
- Powrót to jeden sekret i jedno uruchomienie workflow. Nic na stronie nie zależy od hosta.
- Strona żyje pod ścieżką (
/inwards/), więc przy zmianie hostasite_urlwzensical.tomliDOCS_BASEw silniku muszą się zmienić razem. - GitHub Pages dla prywatnego repozytorium wymaga płatnego planu GitHub.
Alternatywy. Poczekać na token Cloudflare: dokumentacja byłaby niedostępna bez powodu technicznego. Wdrażać z lokalnej maszyny: nieodtwarzalne i pomija ścisły build w CI.
ADR-013: Rzeczywiste ścieżki dla granicy, ścieżki importu dla nazw modułów
Stan: Przyjęty · 2026-09-25
Kontekst. Dane wejściowe hooka pochodzą od agenta, więc każda ścieżka w nich jest niezaufana. Dwa przeglądy w M0 pokazały, że jeden rodzaj ścieżki nie może służyć obu celom. Sprawdzanie zawierania i nazywanie modułów na ścieżkach leksykalnych pozwala dowiązaniu symbolicznemu sięgnąć poza projekt. Robienie obu rzeczy na ścieżkach rzeczywistych (pierwsza poprawka) zmieniało nazwę dowiązanego shop/domain/order.py na shared.order, które nie należy do żadnej warstwy. Późniejsza wersja pomijała prawdziwy pakiet, gdy przejrzano już jego alias-dowiązanie, więc ln -s shop/domain aaa ukrywało całą warstwę domeny. Dwa szczegóły platform pogarszały sprawę. Na macOS /var to dowiązanie do /private/var. A realpath w Bunie składa dlink/.. jako tekst, podczas gdy system operacyjny najpierw rozwiązuje dlink.
Decyzja.
- O zawieraniu decydują ścieżki rzeczywiste. Granicą jest
CLAUDE_PROJECT_DIRalbo katalog, w którym host uruchamia hook, nigdycwdz danych wejściowych...jest rozwiązywane tak, jak robi to system operacyjny, jedna ścieżka rzeczywista naraz. - Nazwy modułów są zgodne z Pythonem: moduł nazywa się według ścieżki, przez którą jest importowany. Plik osiągalny pod kilkoma nazwami (alias i jego ścieżka rzeczywista) jest sprawdzany pod każdą nazwą, która mieści się pod katalogiem głównym konfiguracji, raz na plik.
- Przeglądanie plików podąża za dowiązaniami symbolicznymi tylko wtedy, gdy ich cel zostaje wewnątrz przeglądanego katalogu. Zatrzymuje się tylko na prawdziwym cyklu, znalezionym w łańcuchu katalogów nadrzędnych.
- Wyszukiwanie konfiguracji decyduje na podstawie sparsowanego TOML, a w hooku ignoruje każdy
pyproject.toml, którego ścieżka rzeczywista leży poza projektem.
Konsekwencje.
- Alias nie może wyprowadzić pliku z jego warstwy, a dowiązanie nie może wciągnąć plików spoza projektu do sprawdzenia ani do wyjścia hooka.
- Kod współdzielony przez dowiązanie do katalogu poza projektem nie jest sprawdzany. Sprawdzenie go oznaczałoby czytanie poza projektem.
- Plik, który naprawdę ma dwie nazwy modułu, może zostać zgłoszony dwa razy, raz dla każdej nazwy. Obie są prawdziwymi ścieżkami importu, więc oba zgłoszenia są prawdziwe.
Alternatywy. Tylko ścieżki rzeczywiste: zmienia nazwy dowiązanych plików i ukrywa warstwy. Tylko ścieżki leksykalne: pozwala dowiązaniu sięgnąć poza projekt. Brak obsługi dowiązań symbolicznych: pakiety dowiązane do projektu pozostawałyby niesprawdzone bez żadnego ostrzeżenia.
Poprawka · 2026-09-28 · #83, #84. Dwa rodzaje dowiązań ukrywały kod przed regułami. ln -s /outside/dir shop/domain/ext daje importowalny shop.domain.ext.leak, którego walker, zgodnie z decyzją wyżej, nigdy nie czyta. ln -s ../infrastructure shop/domain/infra_alias daje shop.domain.infra_alias.db, kod infrastruktury, który INW001 po nazwie bierze za kod domeny, więc from shop.domain.infra_alias import db przechodzi.
- Dowiązanie symboliczne w warstwie to błąd INW006 w miejscu dowiązania, gdy jego rzeczywisty cel leży poza katalogiem
root, w innej warstwie albo nad warstwami (w pakiecie, który je zawiera, albo wroot). Dowiązanie w obrębie własnej warstwy przechodzi, podobnie jak dowiązanie do kodu poza wszystkimi warstwami: ten kod jest sprawdzany pod nazwą dowiązania. Dowiązanie nad warstwami, pod którym może leżeć kod warstwy (shop/paymentsprzyshop.*.domain), jest błędem, gdy wychodzi pozaroot, chyba że jego nazwa nie jest identyfikatorem Pythona (static-assets). Cel zawierający rzeczywisty katalog pakietu warstwy, który sam jest dowiązaniem (packagesprzyshop -> packages/shop), też zawiera warstwy. Liczą się dowiązania do katalogu albo do pliku.pylub.pyi; wiszące dowiązania nie. - Walker wypisuje dowiązania pod ścieżką, przez którą importuje je Python. Obejmuje pakiet najwyższego poziomu każdej warstwy (
layerPackages, ADR-034) i sam ten pakiet, gdy jest dowiązaniem, więc katalogrootzłożony z dowiązań do członków workspace'u uv nazywa każde z nich. Podąża za dowiązaniami, które zostają wroot(z ochroną przed cyklami), a nigdy za tymi, które z niego wychodzą, więc łańcuch przez kod poza wszystkimi warstwami (shop/domain/a -> ../miscishop/misc/y -> ../infrastructure) pojawia się jakoshop/domain/a/y. Cel pod pakietem warstwy, który sam jest dowiązaniem wroot(shop -> packages/shop), jest nazywany przez ten pakiet (shop.infrastructure), a nie przez rzeczywistą ścieżkę. Silnik dostaje nazwy względemrooti rozstrzyga. - Zapis startu sesji zawiera dowiązania: ścieżkę dowiązania i jego rzeczywisty cel. Przy Stop blokuje diagnostyka nowa od startu (nowe dowiązanie albo takie, które wskazuje gdzie indziej), a
[tool.inwards.rules]nie ma tu zastosowania, tak jak przy przeniesieniu warstwy (ADR-027). Dowiązanie, które było na starcie, nie blokuje, jak stare naruszenie w nietkniętym pliku. Zapis startu bez dowiązań, ze starszej wersji, sprawia, że każde takie dowiązanie liczy się jako nowe.
Konsekwencje: kod za dowiązaniem spoza root nadal nie jest czytany; diagnostyka mówi, że tam jest. Katalog z plikami danych dowiązany do pakietu warstwy spoza root też jest zgłaszany. Serwer języka i inwards check ze ścieżkami jako argumentami nie zgłaszają dowiązań, tak jak nie zgłaszają martwych prefiksów.
Alternatywy: rozwiązywać każdy import do pliku, który ładuje Python, i brać warstwę z każdej nazwy tego pliku: dokładne dla #84, ale każdy import wymagałby sprawdzenia rzeczywistej ścieżki przez nowy port silnika, a #83 nic by nie dało. Sprawdzać cel tylko do odczytu: czytałoby pliki spoza projektu, co wyklucza decyzja wyżej. Zgłaszać każde dowiązanie w warstwie: oznacza aliasy w obrębie warstwy, które ADR-013 celowo wspiera.
ADR-014: Zgłaszaj pliki, których zadeklarowane kodowanie może ukryć importy
Stan: Przyjęty · 2026-09-25
Kontekst. CPython respektuje deklarację PEP 263, taką jak # coding: unicode_escape w linii 1 albo 2. Przy tym kodeku tekst #\u000aimport shop.infrastructure.db jest komentarzem dla każdego czytnika, który traktuje plik jako UTF-8, a prawdziwym importem dla CPythona. Adaptery czytają pliki jako UTF-8, a silnik nie wykonuje operacji wejścia-wyjścia i nie zawiera tablic kodeków.
Decyzja. Silnik znajduje deklarację według reguł tokenizera CPythona: linia 1 albo linia 2, gdy linia 1 jest pusta albo jest komentarzem, z obsługą CRLF i U+2028. Warianty UTF-8 i jednobajtowe kodeki zgodne z ASCII (ASCII, Latin-1, ISO-8859-*, cp125x) są czytane jak zwykle, bo żaden z ich bajtów nie może zamienić się w znak końca linii albo cudzysłów. Każdy inny zadeklarowany kodek daje jedną diagnostykę INW000 w linii 1 dla pliku w warstwie, a importy tego pliku nie są sprawdzane.
Konsekwencje.
- Plik, którego kodowanie może ukryć import, jest zgłaszany, zamiast przechodzić.
- Prawidłowe pliki w kodekach takich jak Shift_JIS albo EUC-JP też dostają INW000. To ostrożne podejście, bo bajt wiodący Shift_JIS może połknąć ukośnik wsteczny. Poprawka to zapisanie pliku w UTF-8.
Alternatywy. Dekodować każdy kodek obsługiwany przez Pythona: wymaga tablic kodeków w silniku i wciąż musi zgadzać się z CPythonem co do bajtu. Ignorować deklarację: ciche obejście.
ADR-015: Sprawdzaj dosłowne importy dynamiczne jako INW011
Stan: Przyjęty · 2026-09-25
Kontekst. Skoro INW001 wyłapuje importy w funkcjach i pod TYPE_CHECKING (ADR-009), następnym najtańszym obejściem jest wywołanie: importlib.import_module("shop.infrastructure.db"), __import__(...), runpy.run_module(...) albo exec("from shop.infrastructure import db"). Inwards nigdy nie uruchamia kodu użytkownika (C4), więc może czytać tylko cele, które są zapisane wprost. Szkielet importów (ADR-004) zachowuje wyłącznie instrukcje importu: plik, którego jedyną zależnością na zewnątrz jest wywołanie, przeszedłby szybką ścieżkę bez żadnych importów.
Decyzja.
- Cel w postaci literału napisowego w
importlib.import_module,__import__(także jakobuiltins.__import__iimportlib.__import__) alborunpy.run_moduleoraz każdy import wewnątrz dosłownego kodu dlaexec,evalalbocompilejest sprawdzany jak import. Dosłowny kod jest parsowany tą samą gramatyką, a jego importy (także dynamiczne) są zgłaszane w miejscu wywołania. - Jest zgłaszany jako osobna reguła, INW011
dynamic-import, a nie jako INW001. Poprawka wskazuje loader jako problem: usuń wywołanie i użyj portu, bo odbudowanie nazwy w czasie działania albo przeniesienie jej do innego loadera tylko ukrywa zależność. - Loadery są rozpoznawane przez aliasy importów (
from importlib import import_module as im,import builtins as b,from importlib import *), zwykłe przypisania (load = importlib.import_module),getattr(m, "name"),m["name"],m.__dict__["name"],vars(m)["name"]i__import__("importlib"). Zasięgi są ignorowane, aexec,eval,compilei__import__zawsze są traktowane jak funkcje wbudowane, więc rozwiązywanie może dodać wyniki, ale nie może żadnego usunąć. Zaakceptowanym kosztem jest fałszywy alarm: pofrom re import compilewywołaniecompile("from shop.infrastructure import x")zostaje zgłoszone. - Wiązania niewymienione wyżej nie są śledzone. #79 dodało operator morsa, przypisanie krotek, z gwiazdką i łańcuchowe, atrybuty klasy i instancji,
functools.partial, nazwy związane wewnątrz dosłownegoexec, funkcje wbudowane osiągnięte przez__self__,__globals__,globals()isys.modulesoraz API ładującepkgutil.resolve_name,importlib.util.find_spec,spec_from_file_locationiSourceFileLoader. Rozdział 3 wymienia to, co nadal jest przeoczane. - Cel to stały napis: literały, niejawna konkatenacja,
+między stałymi i f-stringi, których pola są stałymi napisami. #79 dodało%z%s,*,str.join,str.format, wycinki,!si tekstowe specyfikacje formatu oraz nazwy na poziomie modułu związane raz ze stałą w pliku bezexec,eval, funkcji zapisującej przestrzeń nazw i importu z gwiazdką. - Bajty przekazane do
execalbocompilesą dekodowane tak, jak robi to CPython. Deklaracja PEP 263 się liczy, a kodek, którego Inwards nie umie czytać (reguły INW000, ADR-014), daje w każdej warstwie diagnostykę INW011 mówiącą, że kodu nie da się sprawdzić. Źródło typustrignoruje deklarację, tak jak w CPythonie. - Cele względne są rozwiązywane tak jak w czasie działania:
import_module(".x", package=...)z dosłownym pakietem,__package__albo__name__oraz__import__z dosłownymlevelwzględem pakietu pliku. - Przed prescanem sprawdzenie tekstu szuka nazw, które każde wywołanie ładujące musi zapisać:
importlib,runpy,pkgutil,builtins,__import__,__self__alboexec,evallubcompilebez poprzedzającej kropki, w tekście po normalizacji NFKC. Plik w warstwie, który pasuje, pomija szkielet i dostaje pełne parsowanie.prescan-diffsprawdza tę wskazówkę na obu korpusach: import dynamiczny w pliku, który wskazówka odrzuca, to przeoczenie.
Konsekwencje.
- Typowe dynamiczne obejścia są zgłaszane z poprawką wymierzoną właśnie w nie. Testy obejmują każdą formę wywołania i każdy alias.
- INW011 nie jest kompletne. Drogi, które rozdział 3 wymienia jako znane luki, są fałszywie negatywnymi wynikami; wyliczane cele są zgłaszane w warstwach wewnętrznych jako niesprawdzalne (ADR-026).
- Wskazówka wysyła do pełnego parsowania 209 z 1921 plików biblioteki standardowej CPythona 3.14, a płacą za to tylko pliki w warstwie.
re.compilejej nie wyzwala. - Wyliczane cele (
import_module(name), f-stringi z polami), względneimport_modulebez czytelnego pakietu i literały z sekwencją\N{...}nie są czytane. Wyliczane cele wymagają osobnej decyzji: oznaczania każdego niedosłownego wywołania loadera w warstwie wewnętrznej (#46). -
prescan-diffparsuje teraz każdy plik, którego nie może wykluczyć, więc wygenerowany korpus (65 262 pliki) zajmuje około 4 s zamiast 1 s. - Indeks modułów (
importersOf) wciąż czyta tylko importy statyczne, więc moduł, który importuje inny dynamicznie, nie jest wymieniany wśród modułów, które go importują.
Alternatywy. Zgłaszać jako INW001: agent przeczytałby „usuń import” i szukałby instrukcji importu, której nie ma. Skanować nazwy wywołań w szkielecie: szkielet musiałby zachowywać dowolne linie z wyrażeniami, co jest pełnym parsowaniem pod inną nazwą. Oznaczać każde wywołanie loadera w warstwie wewnętrznej: wyłapuje też wyliczane cele, ale zgłasza importlib.import_module("json"); zostawione na późniejsze zgłoszenie.
ADR-016: Wersje i wydania wynikają z typów commitów, przez release PR
Stan: Przyjęty · 2026-09-26
Kontekst. Do v0.1.0-rc.1 wydanie oznaczało ręczne podbijanie VERSION w pięciu plikach (meta.ts, trzy pliki package.json, pyproject.toml), wypchnięcie tagu v* i ręczne pisanie informacji o wydaniu. Ręcznie wpisywane tagi są żmudne i łatwo o błąd, a błędny tag drogo kosztuje: cd.yml odrzuca tag, który nie zgadza się z VERSION, a PyPI nigdy nie przyjmuje tej samej wersji dwa razy. Właściciel poprosił o wersje, które ustawiają się same, i changelog, którego nikt nie pisze. Inwards jest przed wersją 1.0 i w fazie pre-alpha. required-version (przypinane przez inwards init) ma oznaczać „najstarsze wydanie z funkcjami, których używa ta konfiguracja”.
Decyzja.
- release-please utrzymuje otwarty release PR (
chore: release X.Y.Z) z następną wersją, wersją wpisaną do każdego pliku i nową sekcjąCHANGELOG.md. Scalenie go jest wydaniem: tagujevX.Y.Z, tworzy szkic GitHub Release i uruchamiacd.yml. Nikt nie wpisuje tagu ani wpisu w changelogu. - Wersja wynika z typu commitu każdego PR scalonego przez squash (ADR-017). Przed 1.0
featifixpodbijają wersję poprawki (patch), a zmiana niekompatybilna (feat!,BREAKING CHANGE:) podbija wersję pomniejszą (minor), jak w Cargo. Po 1.0 obowiązują zwykłe reguły SemVer. - Wersje kamieni milowych są ustawiane celowo. Zamknięcie kamienia milowego N ustawia
Release-As: 0.N.0jako ostatni akapit opisu PR, żeby wydania zgadzały się z nazwami kamieni milowych (M2 to v0.2). - Jest jedno źródło wersji:
.release-please-manifest.json. CI oblewa każdy PR, w którym inne pole wersji się z nim nie zgadza. - Model gałęzi jest oparty na pniu (trunk-based). Jest tylko
main, z krótko żyjącymi gałęziami, bez gałęzidevelop. - Kandydat do wydania to opcjonalny, ręcznie wypychany tag (
v0.2.0-rc.1) na gałęzi release PR,release-please--branches--main--components--inwards.maintrzyma starą wersję, dopóki release PR nie zostanie scalony, więc tag tam nie przeszedłby sprawdzenia wersji. To ten sam przepływ co przy v0.1.0-rc.1. - Buildy deweloperskie z
main(0.2.1-dev.N+g<sha>dla plików binarnych,0.2.1.devNdla wheeli) zostają na później, aż design partnerzy będą potrzebowali nightly. - Nie ma jeszcze wydania v0.1.0. v0.1.0-rc.1 pozostaje opublikowaną wersją przedpremierową, a release PR czeka, aż któryś kamień milowy będzie wart pokazania.
- Kompatybilność przed 1.0:
- Wydanie poprawkowe (patch) dodaje albo naprawia; nigdy nie psuje konfiguracji, która działała.
- Wydanie pomniejsze (minor) może zepsuć konfigurację albo CLI i mówi o tym w notce o zmianach niekompatybilnych w CHANGELOG.
- Wyjście
inwards/diagnostics@1tylko zyskuje pola (ADR-007). required-versionoznacza „najstarsze wydanie z funkcjami, których używa ta konfiguracja”.
Konsekwencje.
- Wydanie to jedno scalenie, a release PR pokazuje dokładnie, co zostanie dostarczone, zanim to nastąpi.
- Numery wersji pozostają znaczące dla użytkowników i dla
required-version. - Changelog jest tak dobry, jak tytuły PR (ADR-017).
- Dopóki repozytorium jest prywatne i używa domyślnego
GITHUB_TOKEN, release PR nie dostaje własnego uruchomienia CI. Jego diff to tylko wpisane wersje i changelog, acd.ymlponownie uruchamia testy na tagu. Token GitHub App naprawi to, gdy repozytorium stanie się publiczne. - Wydanie z release-please uruchamia
cd.ymlprzezworkflow_dispatch, bo tag wypchnięty zGITHUB_TOKENnie uruchamia żadnego workflow. Przejście później na token aplikacji oznacza usunięcie tego kroku, inaczej każde wydanie będzie budowane dwa razy. - Pierwszym wydaniem będzie v0.1.1 albo późniejsze (wybiera je
Release-As), nigdy v0.1.0. Link porównawczy w jego changelogu wskazuje tag v0.1.0, który nie istnieje.
Alternatywy.
- Podbijanie według gałęzi: minor przy każdym scaleniu do
main, major przy każdym wydaniu i gałąźdeveloppublikująca buildydev+sha. To był pierwszy pomysł właściciela, a jego cel (brak ręcznego tagowania) został zachowany. Minor przy każdym scaleniu doszedłby do 0.40 w ciągu kilku tygodni, spalałby na każdy PR numer wersji, którego nikt nie instaluje, i psułbyrequired-version: kolega z zespołu jedno scalenie w tyle ciągle dostawałby „requires Inwards X or newer”. Major przy każdym wydaniu łamie SemVer, bo major oznacza niekompatybilność. Gałąźdevelopdokłada scalenia wsteczne i podwójne CI dla jednego opiekuna, który scala jeden PR naraz. - semantic-release: wydaje przy każdym pushu, bez kroku przeglądu, i nie obsługuje wersji 0.x.
- python-semantic-release: commituje i taguje prosto na
mainprzy każdym pushu i oddaje narzędziu w Pythonie kontrolę nad repozytorium opartym na Bunie. - git-cliff plus własne zadanie tagujące: najlepszy generator changelogów, ale podbijanie, wpisywanie wersji i tagowanie byłyby w całości własnej roboty.
- changesets: wymaga ręcznie pisanego pliku changeset w każdym PR, a tego właśnie właściciel chciał uniknąć.
ADR-017: Scalanie przez squash z tytułami PR w formacie Conventional Commits
Stan: Przyjęty · 2026-09-26
Kontekst. Automatyczne wersje i changelogi (ADR-016) czytają wiadomości commitów na main. Do 2026-09-25 PR-y były scalane commitami scalającymi, które przenosiły do main każdy commit z gałęzi: rundy „poprawek po przeglądzie”, commity z pracą w toku i commity fix:, które poprawiały pracę nigdy niewydaną. Tylko 19% tych commitów było zgodnych z Conventional Commits.
Decyzja.
- Repozytorium pozwala tylko na scalanie przez squash. Tytuł commitu squash to tytuł PR, a jego wiadomość to opis PR. Scalone gałęzie są usuwane automatycznie.
- Każdy tytuł PR to Conventional Commit,
type(scope): summary, sprawdzany w CI przezpr-title.yml. feat,fix,perf,deps,revertidocspojawiają się w changelogu.refactor,test,build,ciichoresą ukryte.- Zmiana niekompatybilna jest oznaczana w tytule i wyjaśniana w opisie:
feat!:w tytule oraz akapitBREAKING CHANGE: <what to do>w opisie PR. - Commity wewnątrz gałęzi mogą mówić cokolwiek. Nigdy nie trafiają do
main.
Konsekwencje.
- Jeden PR to jeden commit i jedna linia w changelogu.
- Linię changelogu można poprawić po scaleniu, edytując opis PR, blokiem
BEGIN_COMMIT_OVERRIDE. -
git bisectnamainzatrzymuje się na całym PR, a nie na pojedynczym commicie w nim. - Gałąź scalona przez squash nie jest przodkiem
main, więc worktree sprząta się przezgit branch -Dpo sprawdzeniu, że PR jest scalony.
Alternatywy.
- Zostawić commity scalające i lintować każdy commit: każdy commit z poprawkami po przeglądzie potrzebowałby typu, a poprawki wewnątrz gałęzi i tak trafiałyby do changelogu.
- Scalanie przez rebase: ten sam problem, z jednym commitem na linię.
- Ręcznie pisane wpisy w changelogu: odrzucone w ADR-016.
ADR-018: Selektory pakietów przyjmują globy od początku; monorepo podąża za workspace'ami uv
Stan: Przyjęty · 2026-09-26
Kontekst. Kształt pakietu (#95) i jego następcy (szablony #97, reguły ról #98) wybierają pakiety po nazwie. Układy takie jak fastapi-best-practices dodają pakiet na każdą domenę biznesową, a Inwards musi obsłużyć zarówno jednopakietowy monolit, jak i monorepo z kilkoma projektami.
Decyzja.
- Selektory przyjmują globy od v1, w gramatyce import-lintera:
a.bto dokładne dopasowanie,a.*to jeden segment, aa.**to dowolna głębokość poniżeja. Wygrywa pierwszy pasujący wpis, a dokładny wpis przesłonięty przez wcześniejszy glob to błąd konfiguracji. Schemat konfiguracji v2 (#51) używa tej samej gramatyki. - Monorepo podąża za workspace'ami uv (
[tool.uv.workspace] members = [...]). - Każdy członek workspace ma własne
[tool.inwards], a dla każdego pliku obowiązuje najbliższa konfiguracja, tak jak dziś. - Późniejsza konfiguracja na poziomie workspace może stosować jeden kształt albo szablon do każdego członka, korzystając z globów
membersz uv, żeby lista projektów nie powtarzała się w konfiguracji Inwards (#57).
Konsekwencje.
- Selektor
src.*obejmuje nową domenę (src/payments/) w chwili, gdy powstaje. Agent nie może obejść kształtu, dodając pakiet, którego konfiguracja jeszcze nie wymienia. - Użytkownicy monorepo opisują swoje projekty raz, w miejscu, które uv już czyta.
- Pierwszeństwo globów trzeba wyjaśnić i przetestować. Glob może pasować do pakietów, o które użytkownikowi nie chodziło, więc selektor, który do niczego nie pasuje, jest zgłaszany, podobnie jak selektor przesłonięty przez wcześniejszy wpis.
Alternatywy.
- W v1 tylko jawne nazwy pakietów, globy później: prostsze na początku, ale każda nowa domena wymagałaby zmiany konfiguracji. Config guard (#23) zabrania agentom takiej zmiany, więc każda nowa domena musiałaby się zatrzymać i czekać na użytkownika.
- Własna składnia workspace: powielałaby to, co uv już definiuje, i by się z tym rozjeżdżała.
ADR-019: Gałąź integracyjna develop; main przesuwa się tylko przy wydaniach
Stan: Przyjęty · 2026-09-26 · Zastępuje punkt o gałęziach z ADR-016
Kontekst. ADR-016 wybrał rozwój oparty na pniu, bo jeden opiekun scalał jeden PR naraz. To się zmieniło: właściciel chce, żeby agenci z innych środowisk (Codex, Cursor i inne) otwierali własne PR-y, podczas gdy pracuje agent koordynujący. Kilku autorów potrzebuje jednej chronionej gałęzi integracyjnej, a main powinien pokazywać tylko wydany kod. Wcześniej żadna z gałęzi nie miała żadnej ochrony.
Decyzja. Właściciel wybrał ten model 2026-09-26:
developjest gałęzią domyślną. Każdy PR, od dowolnego agenta albo człowieka, celuje w nią i jest scalany przez squash z tytułem w formacie Conventional Commits (ADR-017). GitHub nie ma osobnego ustawienia „domyślnej bazy dla PR”, więc to gałąź domyślna sprawia, że PR z dowolnego narzędzia trafia dodevelopbez dodatkowej konfiguracji.mainprzesuwa się tylko przy wydaniu. PR promującydevelop→mainjest scalany commitem scalającym, nigdy przez squash, więc release-please namainwciąż widzi przez to scalenie jeden commit na każdy PR z funkcją. Potem właściciel scala release PR z release-please domain(target-branch: mainjest ustawione jawnie, bo inaczej release-please celowałby w gałąź domyślną).- Wydanie odbywa się za jednym posiedzeniem, przy zamrożonym
develop: promocja, aktualizacja PR przez release-please, jego scalenie, a potem ponowne otwarciedevelop. release-please czyta historięmainw kolejności dat commitów i zatrzymuje się na ostatnim commicie wydania. Data commitu squash to czas scalenia, więc PR scalony dodevelopprzed scaleniem release PR, ale wypromowany po nim, znalazłby się za punktem zatrzymania i nigdy nie trafiłby do changelogu. Promowanie tylko przy wydaniu i wydawanie zaraz po promocji zamyka to okno. - Commit wydania zostaje na
main; nic nie jest scalane z powrotem dodevelop. release-please wpisuje wersje tylko w liniach, których agenci nigdy nie edytują:CHANGELOG.md, manifest,meta.ts(osobna, oznaczona linia), polaversionw trzech plikachpackage.json,pyproject.tomliuv.lock. Przy następnej promocji git bierze te linie zmainbez konfliktu. README i dokumentacja nie zawierają już wpisywanej wersji w akapitach o stanie projektu, bo agenci edytują te zdania, a wtedy każda promocja kończyłaby się konfliktem. Nadeveloppola wersji zostają na zawsze na0.1.0; są ze sobą zgodne, więc sprawdzenie wersji nadal przechodzi. - Rulesety wymuszają ten przepływ.
- Obie gałęzie: bez bezpośrednich pushy, bez force pushy, bez usuwania, a sprawdzenia CI i sprawdzenie tytułu PR muszą przejść. Gałęzie nie muszą być aktualne względem bazy, bo inaczej równolegli agenci bez końca rebase'owaliby się nawzajem. Zatwierdzenia nie są wymagane: każdy agent korzysta z konta właściciela i nie może zatwierdzić własnego PR.
developprzyjmuje tylko scalanie przez squash i nikt nie może ominąć jego rulesetu.mainprzyjmuje tylko commity scalające, zarówno dla promocji, jak i dla release PR: promocja przez squash ukryłaby każdy commit z funkcją za jednym commitemchore:. Właściciel może ominąć sprawdzenia w PR, bo PR z release-please jest otwierany zGITHUB_TOKENi nie dostaje uruchomienia CI. Każdy agent działa jako właściciel, więc agent też mógłby skorzystać z tego obejścia; AGENTS.md zabrania tego poza krokiem 3 wydania.- CI uruchamia się przy pushach do obu gałęzi. Strona z dokumentacją wdraża się z
develop, bo rozdziały opisują kod takim, jaki jest, amainmoże być opóźniony o cały kamień milowy. - Worktree leżą w
~/Documents/GitHub/worktrees/<repo>/<worktree>, poza każdym checkoutem, więc agenci z różnych środowisk znajdują je w jednym miejscu i żaden nie jest zagnieżdżony w innym repozytorium.
Konsekwencje.
- Dowolna liczba agentów może otwierać PR-y jednocześnie; to rulesety, a nie dyscyplina agentów, utrzymują
developna zielono, amainwyłącznie dla wydań. -
mainpokazuje dokładnie to, co użytkownicy mogą zainstalować. Strona repozytorium pokazujedevelop, gałąź domyślną. - Wydanie to teraz trzy kroki (promocja, scalenie release PR, publikacja szkicu) zamiast dwóch.
-
git log mainznowu zawiera commity scalające. Nie wpływa to na changelog: własny tytuł promocji to ukrytechore:, a jej opis nie może zaczynać akapitu od typu commitu. - Plik binarny zbudowany z
developzawsze zgłasza0.1.0, niezależnie od najnowszego wydania. - Wydanie zamraża
developna kilka minut, a release PR nie może czekać otwarty tygodniami, jak planował ADR-016: kandydaci do wydania są tagowani za tym samym posiedzeniem albo na gałęzi wydzielonej specjalnie dla nich. - Strona z dokumentacją może opisywać funkcje, których nie ma jeszcze w żadnym wydaniu. Rozdziały już oznaczają zaplanowaną pracę, a przewodnik instalacji podaje wydanie, którego dotyczy.
Alternatywy.
- Zostać przy rozwoju opartym na pniu i chronić
main: najprostsza opcja, ale wtedy PR każdego agenta trafia prosto do gałęzi wydań, a właściciel chciał gałęzi pośredniej między agentami a wydaniami. mainjako gałąź domyślna plus workflow, który przestawia PR-y nadevelop: strona repozytorium pokazywałaby wydany kod. Ale każdy PR otwierałby się najpierw namain, jego pierwsze uruchomienie CI i benchmarku porównywałoby się ze złą bazą, a do tego dochodzi workflow do utrzymania. Właściciel wybrałdevelopjako gałąź domyślną.- release-please na
develop: wydania powstawałyby z niewypromowanego kodu, amainstraciłby jakąkolwiek rolę. - Automatyczne scalanie wsteczne
maindodeveloppo każdym wydaniu: w repozytorium należącym do konta osobistego GitHub Actions nie może być aktorem omijającym ruleset, więc push wymagałby sekretu z PAT albo GitHub App. Zrobienie tego przez PR wymaga z kolei obejścia administratora nadevelop, bo PR otwarty zGITHUB_TOKENnie dostaje CI, a to obejście pozwoliłoby też dowolnemu agentowi na koncie właściciela scalić czerwony PR. Skoro bez tego nic nie jest w konflikcie, właściciel zdecydował, że nie będzie scalania wstecznego.
ADR-020: Kreator w init używa @clack/prompts, ładowanego z osobnego fragmentu
Stan: Przyjęty · 2026-09-26 · #92
Kontekst. inwards init w terminalu, bez --style i --agent, pyta o styl architektury, przykładowy pakiet i agenta (#92). Biblioteka do zadawania pytań jest dostarczana wewnątrz jednego pliku binarnego (ADR-003), ale check i hooki startują przy każdej edycji agenta i nie mogą płacić za pytania, których nigdy nie pokazują. Budżet w #92 to 3 ms startu.
Decyzja.
- @clack/prompts, przypięte do dokładnej wersji (1.8.1). Analiza w #92 zmierzyła je na około 61 KB w skompilowanym pliku binarnym. Ink z Reactem dodaje około 496 KB i od 10 do 29 ms startu, wysypuje się przy starcie pod
bun build --compile, chyba że wtyczka zaślepireact-devtools-core, i ma świeże regresje renderowania na Windows. @inquirer/prompts ma otwarty błąd z wyborem na Windows. - Ładowane dynamicznym
import()wewnątrz kreatora i tylko wtedy, gdy stdin i stdout są TTY, aCInie jest ustawione. Bez terminala init od razu kończy się kodem 2 z flagami; nigdy nie czeka na dane. -
splitting: truewscripts/build-binaries.ts. Bez tego Bun wkleja dynamicznie importowany moduł do jednej paczki: jego kod wykonuje się dopiero przy imporcie, ale każdy start i tak go wczytuje. Zmierzone na Linuksie x64 względemdevelopzbudowanego z tymi samymi flagami, od 150 do 300 naprzemiennych uruchomień każde, mediana różnic w parach:Build --versionmały checkuruchomienie hooka Bez bajtkodu, bez podziału +5,2 ms +5,9 ms +5,2 ms Bajtkod (#118), bez podziału +1,7 ms +1,7 ms +1,1 ms Bajtkod i podział (przyjęte) -0,1 ms +0,0 ms -0,1 ms Z podziałem biblioteka jest osobnym fragmentem wewnątrz pliku binarnego, czytanym tylko wtedy, gdy uruchamia się kreator. Benchmark z #29 się zgadza: hook -0,0%, pełne sprawdzenie -1,8%.
Konsekwencje.
-
checki hooki zachowują swój czas startu; koszt kreatora spada na jedyne polecenie, które go pokazuje. - Późniejsza leniwie ładowana funkcja dostaje to samo za darmo.
- Build zapisuje
chunk-*.js.mapobok każdego pliku binarnego wdist/. Wysyłka wydania i tak bierze tylko plikiinwards-*. - Kreatora nie da się przetestować w CI, które nie ma TTY. Sterowano nim przez pseudoterminal na Linuksie; Windows Terminal, PowerShell i Terminal w macOS wciąż wymagają ręcznego sprawdzenia (#92).
Alternatywy.
- Ink: bogatsze układy, ale zobacz liczby wyżej.
- Ręcznie napisane pytania na surowym stdin: bez zależności, ale obsługa kursora, zmiany rozmiaru i konsoli Windows to właśnie to, co biblioteka już robi dobrze.
- Sam bajtkod: zmniejsza koszt biblioteki z około 5 ms do 1–2 ms, ale przy 10 ms startu wciąż trzeba go płacić przy każdym wywołaniu hooka za pytania, których hook nigdy nie pokazuje.
ADR-021: Publikuj wheele wydań na PyPI z osobnego workflow, przez trusted publishing
Stan: Przyjęty · 2026-09-26 · #32
Kontekst. Design partnerzy powinni instalować przez uv add --dev inwards. cd.yml już buduje pięć wheeli platformowych, uruchamia każdy plik binarny i instaluje każdy wheel na jego własnym runnerze, a potem dołącza je do szkicu GitHub Release (ADR-016). Właściciel publikuje ten szkic ręcznie. PyPI nigdy nie przyjmuje tej samej nazwy pliku dwa razy, więc błędnej wysyłki nie da się cofnąć, a właściciel nie chce żadnej przypadkowej wysyłki na PyPI. Repozytorium jest na razie prywatne, a każdy agent pracuje na koncie GitHub właściciela.
Decyzja.
- Trusted publishing (OIDC) z
pypa/gh-action-pypi-publish, przypiętym do SHA commitu. Nigdzie nie jest przechowywany token PyPI. - Osobny workflow,
pypi.yml, a nie zadanie wcd.yml. Uruchamia się, gdy wydanie zostaje opublikowane, nigdy na szkicu, albo ręcznie z tagiem i indeksem.cd.ymlkończy się na szkicu i nie widzi, kiedy właściciel go publikuje. PyPI ufa tylkopypi.yml, który nie uruchamia żadnego kodu budującego ani testowego. - Wysyła własne wheele wydania, czyli pliki, które właściciel właśnie opublikował, po sprawdzeniu ich względem
SHA256SUMSwydania, a gdy repozytorium będzie publiczne, także względem pochodzenia buildu. Nigdy ich nie przebudowuje. - Najpierw TestPyPI, potem PyPI, każde we własnym środowisku GitHuba (
testpypi,pypi), z którym związany jest publisher na danym indeksie. Tylko dwa zadania wysyłające dostająid-token: write. - Wersja przedpremierowa trafia tylko na TestPyPI, niezależnie od tego, czy wydanie jest tak oznaczone, czy jego tag ma przyrostek (
-rc.1). Na PyPI jest już finalna wersja-zaślepka 0.0.0, więc uv i tak wybrałby ją zamiast każdej wersji przedpremierowej. Kandydat do wydania może wciąż trafić na PyPI przez ręczne uruchomienie z jego tagu. - Prawdziwą bramką jest konto właściciela na pypi.org. Każdy agent pracuje na koncie GitHub właściciela, więc zmienna, środowiska, tagi i ręczne uruchomienia są w zasięgu agenta, a PyPI nie sprawdza refu ani commitu uruchomienia. Publisher PyPI jest więc rejestrowany na końcu, przy uruchomieniu produkcyjnym, a jego usunięcie zatrzymuje każdą wysyłkę na PyPI. Po stronie GitHuba zmienna repozytorium
PYPI_PUBLISHmusi mieć wartośćtruedla każdej wysyłki na PyPI, z wydania albo z ręcznego uruchomienia; środowiskopypiwdraża tylko z tagówv*; a gdy GitHub na to pozwoli (publiczne repozytorium albo Enterprise), dostaje właściciela jako wymaganego recenzenta. To chroni przed pomyłkami, a nie przed agentem. - Żadnych atestacji PEP 740, dopóki repozytorium jest prywatne. Są podpisywane przez publiczny rejestr przejrzystości Sigstore i zawierają repozytorium, workflow i commit.
Konsekwencje.
- Wydanie trafia na PyPI z dokładnie tymi bajtami, które użytkownicy mogli już pobrać z GitHuba i które zostały uruchomione na każdej platformie.
- Trusted publishing działa z prywatnego repozytorium: PyPI sprawdza właściciela, repozytorium, plik workflow i środowisko, a nie widoczność.
- Gdy publisher PyPI już istnieje, agent działający jako właściciel może ustawić
PYPI_PUBLISH, wypchnąć tagv*(żaden ruleset nie chroni tagów) i rozpocząć wysyłkę; nawet wymaganego recenzenta można zatwierdzić przez API jako właściciel. Agentów powstrzymuje wtedy tylkoAGENTS.md, a właściciel może usuwać publishera między wydaniami. - Wheele i
SHA256SUMSszkicu można ręcznie podmienić przed publikacją. Dopóki repozytorium jest prywatne, sprawdzenie sum kontrolnych dowodzi tylko, że są ze sobą zgodne. - Pięć wheeli v0.1.0-rc.1 waży razem 170 MB, przy domyślnym limicie PyPI 10 GB na projekt: to mniej więcej 60 wydań, zanim trzeba będzie prosić PyPI o więcej.
- Wydanie zbudowane, gdy repozytorium było prywatne, nie ma informacji o pochodzeniu. Gdy repozytorium stanie się publiczne,
pypi.ymlodmówi jego wysłania.
Alternatywy.
- Wysyłka z
cd.ymlzaraz po zadaniach weryfikujących: PyPI dostałoby wersję, zanim właściciel obejrzałby szkic, a zaufany workflow uruchamiałby teżbun installi build. - Pobranie artefaktu buildu z uruchomienia
cd.yml: wygasa po 90 dniach, trzeba go szukać po identyfikatorze uruchomienia i nie jest tym, co opublikował właściciel. - Token API ograniczony do projektu jako sekret środowiska: długo żyjące poświadczenie do rotowania, które działa na każdej maszynie, na którą wycieknie.
- Workflow wielokrotnego użytku wywoływany z
cd.yml: PyPI nie może używać workflow wielokrotnego użytku jako zaufanego publishera.
ADR-022: Decyzja „go/no-go” po M2: kontynuujemy warunkowo, do czasu danych od partnerów
Stan: Przyjęty, tymczasowy · 2026-09-26 · #42 · Do ponownej oceny z danymi od partnerów (#132)
Kontekst. M2 kończy się punktem kontrolnym: czy liczby z hipotezy biznesowej trzymają się na tyle dobrze, żeby poświęcić na nią M3–M6? Hipoteza miała być mierzona w repozytoriach design partnerów, ale właściciel przeniósł rekrutację partnerów na koniec planu rozwoju, więc danych od partnerów nie ma. Dowody dostępne 2026-09-26:
| Zakład (rozdział 2) | Próg | Dowody | Odczyt |
|---|---|---|---|
| Kroki naprawy sprawdzają się u modeli | ≥ 80 % naprawionych w ramach jednej ponownej próby | Ewaluacja agentów (#101, eval/README.md): 11 fixture'ów, po jednym uruchomieniu na Sonnecie i Haiku, pełny zestaw hooków. inwards stats: 5 z 7 (71 %). 2 nienaprawione to zadanie „poluzuj konfigurację”, w którym agent słusznie się zatrzymał i zapytał użytkownika. Z 5 naprawionych 3 zakończyły się niewykonanym zadaniem (2 wycofały zmianę i zapytały użytkownika), więc tylko 2 były czystymi poprawkami z wykonanym zadaniem |
Wskazuje we właściwą stronę (żadne naruszenie nie zostało, żadnych obejść), ale 7 podłożonych naruszeń niczego nie rozstrzyga |
| Agenci łamią podział na warstwy na tyle często | ≥ 1 naruszenie na 1000 linii napisanych przez agenta | 25,5 na 1000 linii w ewaluacji, ale jej fixture'y są zbudowane tak, żeby kusiły do naruszenia | Brak dowodów w żadną stronę |
| Szybkość to fosa | p50 hooka < 100 ms | Ewaluacja: p50 21 ms, p95 28 ms, na przykładowej aplikacji z 10 plikami. Lokalnie p50 hooka około 32 ms po przejściu na bajtkod (#39). Pięć prawdziwych serwisów (#36): od 55 do 83 ms na plik lokalnie; jeden plik z 4500 liniami trwał 280 ms na runnerze GitHuba przed przejściem na bajtkod (#122) | Trzyma się, z jednym znanym odstępstwem |
| Hooki to kanał | ≥ 60 % instalacji zachowuje hook | Tylko dane od partnerów; na razie brak | Nieznane |
| Obok Astral jest miejsce | Wdrażany obok Ruffa i ty | Nic nowego od M0 | Nieznane |
Ewaluacja pokazała też to, czego sprawdzenia nie są w stanie pokazać: w żadnym końcowym diffie nie było obejścia; config guard, reguły deny i Stop gate wytrzymały za każdym razem, gdy agent próbował poluzować reguły albo wyłączyć hooki. I jedną słabość: bez baseline'u Stop gate kazał agentom pracować, dopóki nie zniknęły naruszenia, które już były w edytowanych przez nich plikach, i we wszystkich 6 takich uruchomieniach przepisali kod, o którego zmianę nikt ich nie prosił (#134).
Decyzja. Właściciel zdecydował kontynuować warunkowo:
- Kontynuować M3 zgodnie z planem, z #134 (Stop gate blokuje tylko na naruszeniach nowych w każdym edytowanym pliku) przeniesionym na P0 na początku M3: agent przepisujący niezwiązany kod to najbardziej prawdopodobny powód, dla którego zespół wyłączy hooki, a to jest zakład o kanał.
- Decyzja jest tymczasowa. Zostanie ponownie oceniona na danych od partnerów w ramach #132: ta sama tabela, wypełniona wynikami
inwards statsz repozytoriów partnerów. Jeśli „naprawione w ramach jednej ponownej próby” zostanie poniżej 50 % albo hooki zostaną wyłączone w większości instalacji, plan dla M4–M6 zostanie otwarty na nowo. - Ewaluacja pozostaje miarą tymczasową. Przed przeglądem z partnerami zostanie powtórzona z 3 uruchomieniami na przypadek dla każdego modelu (
bun run eval/run.ts --runs 3), co #101 zostawiło otwarte, żeby ograniczyć wydatki.
Konsekwencje.
- Praca trwa nad tą częścią hipotezy, którą wspierają dowody (szybkość, kroki naprawy, odporność na obejścia), bez czekania miesiącami na partnerów.
- Kryteria, które otworzyłyby plan na nowo, są zapisane teraz, zanim dane mogłyby na nie wpłynąć.
- Dwa zakłady (częstość naruszeń, adopcja hooków) nie mają żadnych dowodów; M3–M6 mogą zostać zbudowane dla problemu, którego partnerzy nie mają.
- Fixture'y ewaluacji pochodzą od tych samych ludzi, którzy zbudowali narzędzie, więc są słabym zastępstwem prawdziwych repozytoriów.
Alternatywy.
- Kontynuować bez warunków: prościej to ogłosić, ale traktowałoby liczby z 7 podłożonych naruszeń tak, jakby rozstrzygały hipotezę.
- Wstrzymać do czasu danych od partnerów (przenieść rekrutację, #132, do M3): najbardziej rygorystyczna opcja. Właściciel zostawił rekrutację na końcu planu, a mierzalne zakłady wskazują we właściwą stronę.
- Zatrzymać albo zmienić kierunek: nic zmierzonego nie przeczy żadnemu progowi, więc nie ma argumentów ani za jednym, ani za drugim.
ADR-023: Biblioteki w warstwach, z domyślną listą zakazów dla najbardziej wewnętrznej warstwy
Stan: Przyjęty · 2026-09-26 · #47
Kontekst. INW001 widzi tylko własne warstwy, więc from sqlalchemy.orm import Session w domenie ją przechodzi, a to najczęstszy wyciek w warstwowym kodzie Pythona. Odróżnienie biblioteki od własnego kodu nie może wymagać virtualenva (C4): Inwards nigdy nie importuje kodu użytkownika, więc nie może zapytać Pythona, skąd pochodzi moduł.
Decyzja.
- INW005
pure-domainsprawdza każdy import pliku w warstwie, który nie jest własnym kodem (należy do warstwy albo znajduje go sondowanie systemu plików z INW006) ani nie jest dozwolony przezallow-libraries/deny-librariestej warstwy. Wpisy to nazwy modułów, które obejmują swoje podmoduły; decyduje najdłuższy pasujący wpis, a przy remisieallow. allow-librarieszamienia warstwę w listę dozwolonych tylko dla kodu zewnętrznego. Biblioteka standardowa pozostaje dozwolona i jest rozpoznawana po dołączonej liście: sumiesys.stdlib_module_namesz CPythona 3.11–3.14 oraz modułów, które miały starsze wersje.- Wpisy muszą być identyfikatorami Pythona z kropkami. Glob albo nazwa dystrybucji do niczego by nie pasowały, a w najbardziej wewnętrznej warstwie po cichu wyłączyłyby ustawienie domyślne.
- Najbardziej wewnętrzna warstwa konfiguracji z dwiema lub więcej warstwami zabrania ustalonej listy frameworków, klientów baz danych i sieci oraz operacji wejścia-wyjścia z biblioteki standardowej, chyba że ustawia
deny-libraries, które zastępuje tę listę, zamiast ją rozszerzać. Konfiguracja z jedną warstwą nie dostaje ustawienia domyślnego: jej jedyna warstwa to cała aplikacja, a nie domena. - Komunikat podaje pakiet najwyższego poziomu biblioteki, nigdy skonfigurowanych list, więc wpis w baseline'ie przetrwa ich zmianę. Poprawka podaje wpis zakazu, który pasował (
http.client, któregoallow-libraries = ["http"]by nie znosiło), i każdą warstwę zewnętrzną, której konfiguracja pozwala używać tej biblioteki; agent wybiera tę, która zawiera adaptery, bo kolejność warstw nie mówi, która to jest w układzie heksagonalnym.
Konsekwencje.
- Istniejące konfiguracje z dwiema lub więcej warstwami wyłapują SQLAlchemy, FastAPI albo Requests w domenie bez zmiany konfiguracji.
- To także nowe źródło błędów po aktualizacji w projektach, których domena celowo używa takiej biblioteki. Wyłącza je
deny-libraries = []albo wpis wallow-libraries, ainwards baselineakceptuje to, co już jest. - Dopasowywane są nazwy importu, a nie nazwy dystrybucji (
PyYAMLtoyaml), a moduł biblioteki standardowej nowszy niż dołączona lista liczy się jako zewnętrzny.
Alternatywy. Czytać zainstalowane dystrybucje z virtualenva: dokładne, ale łamie C4 i zawodzi w obrazach CI bez zależności. Domyślny zakaz dla każdej warstwy poza najbardziej zewnętrzną: za dużo zgaduje o tym, czego może używać warstwa aplikacji. Wymieniać skonfigurowaną listę w komunikacie: zmieniona lista przywróciłaby każde naruszenie z baseline'u.
Poprawka, 2026-09-28: biblioteki zakazane prefiksowi modułów (#219). Najczęstszy kontrakt forbidden import-lintera, „mypackage.one nie może importować django”, wskazuje pakiet, który nie jest warstwą, więc inwards import-config (#55) musiał go pomijać.
- W tabeli opcji INW005.
[tool.inwards.rules.pure-domain]przyjmujedeny, listę tabel{ modules, libraries }, obokmodules, które każda reguła ma od poprawki #181 do ADR-027.modulesma gramatykęlayers[].modules, alibrariesgramatykędeny-libraries. Klucz przyjmuje tylkopure-domain; w tabeli innej reguły to nieznany klucz. - Niezależnie od warstw. Wpis dotyczy modułów, do których pasuje, niezależnie od tego, czy należą do warstwy, więc plik poza wszystkimi warstwami, który obejmuje wpis, ma czytane importy.
allow-librarieswarstwy go nie znosi: wpis jest węższy niż warstwa, a zespół pisze go, żeby coś odebrać. - Najpierw pytane są listy warstwy. Gdy one też zakazują importu, zgłoszenie należy do warstwy i ma jej komunikat, więc dodanie wpisu nie rusza istniejących kluczy baseline'u. W przeciwnym razie komunikat podaje moduł i prefiks, do którego pasował wpis (
denies to "mypackage.one"), a poprawka umieszcza port w tym prefiksie, a implementację poza nim. Własnemodulestabeli nadal zawęża każde zgłoszenie INW005. import-configzachowujeextend-deny-librariesdla źródeł, które są dokładnie jedną lub kilkoma warstwami, a dla pozostałych zapisuje wpisdeny.
Alternatywy. deny-libraries we wpisie [[tool.inwards.contexts]]: kontekst niesie też uprawnienia INW002 i INW003, więc przeniesiony kontrakt zmieniłby, co jeszcze pakiet może importować i kto może importować jego. Pole modules we wpisach zakazu warstwy: deny-libraries to lista napisów, a zamiana jej wpisów w tabele zmieniłaby typ istniejącego klucza.
ADR-024: Polskie tłumaczenie jako drugi build, tłumaczone w tym samym PR
Stan: Przyjęty · 2026-09-26 · #149
Kontekst. Właściciel chce mieć dokumentację także po polsku, z przełącznikiem języka. Zensical 0.0.65 buduje jeden język na projekt: internacjonalizacja jest w jego planie rozwoju, a dziś menu wyboru języka w nagłówku (extra.alternate) linkuje do innych buildów. Jego wbudowany przełącznik mapuje strony przez sitemapę drugiego buildu i zakłada równoległe katalogi główne (/en/, /pl/), ale angielska strona już żyje pod /inwards/, a linki docs: z CLI wskazują właśnie tam. Zensical nie potrafi wykluczyć pliku Markdown wewnątrz docs_dir i nie podąża za katalogami będącymi dowiązaniami symbolicznymi.
Decyzja.
- Dwa buildy.
docs/chapters/zostaje po angielsku pod/inwards/.docs/pl/odzwierciedla każdą stronę z angielskiej nawigacji pod tą samą ścieżką, adocs/zensical.pl.tomlbuduje go dodocs/site/pl/, więc jeden artefakt Pages zawiera oba. Polskie strony biorą obrazy, CSS i skrypty z angielskiej strony przez ścieżki../, zamiast kopii. - Przełącznik zachowuje stronę. Nadpisanie motywu (
docs/overrides/partials/alternate.html) linkuje każdy język do tej samej strony w drugim buildzie, alanguage-switch.mjsutrzymuje te linki aktualne (nawigacja natychmiastowa nie renderuje nagłówka od nowa, więc by się zdezaktualizowały) i przy kliknięciu wraca do strony głównej języka, gdy strona tam nie istnieje. Polskie nagłówki zachowują angielskie kotwice ({ #id }), więc przełączenie zachowuje też kotwicę (#anchor). - Tłumaczy agent, w tym samym PR co zmiana w wersji angielskiej (właściciel wybrał to zamiast tłumaczenia maszynowego w CI, maszynowego szkicu z przeglądem albo tłumaczenia przez społeczność).
docs/GLOSSARY.pl.mdustala terminy i leży pozadocs_dirobu buildów, więc nie jest publikowany. Subagent przegląda terminologię i znaczenie jak w każdym innym PR. - Nieaktualność jest śledzona przez hash. Każda polska strona zapisuje
sourcei SHA-256 angielskiego pliku, z którego ją przetłumaczono.scripts/check-docs-translation.pyoblewa CI przy brakującej albo osieroconej stronie, zacommitowanym banerze albo konfiguracjach, których motyw, rozszerzenia albo zasoby się rozjechały, i ostrzega przy nieaktualnej stronie; wdrożenie dodaje do nieaktualnych stron w swoim checkoucie baner „może być nieaktualne”. - Tłumaczone jest wszystko oprócz bloków kodu, wyjścia CLI, kluczy konfiguracji, komunikatów diagnostyk, identyfikatorów i changelogu. Treść ADR-ów jest tłumaczona w całości.
Konsekwencje.
- Angielskie adresy i kotwice się nie zmieniają, a czytelnik, który przełącza język, trafia do tej samej sekcji.
- Brakujące tłumaczenie nie może zostać scalone, a nieaktualne jest widoczne dla czytelników, zamiast po cichu wprowadzać w błąd.
- Każdy PR z dokumentacją dotyka też
docs/pl/, a tłumaczenie jest tak dobre, jak jego przegląd. - Polski build jest kompletny tylko wewnątrz angielskiego:
zensical serve -f docs/zensical.pl.tomlnie pokazuje zrzutów ekranu ani własnych stylów. - Hash zmienia się przy każdej edycji, także przy poprawce literówki, więc niektóre ostrzeżenia o nieaktualności wymagają tylko
--fix-hashes. - GitHub Pages serwuje tylko główny
404.html, więc brakująca strona pod/pl/pokazuje angielską stronę 404 (przełącznik języka nadal na niej działa).
Alternatywy. Angielski pod /en/ obok /pl/: wbudowany przełącznik by działał, ale przesunęłyby się wszystkie istniejące linki i adresy docs: z CLI. Tłumaczenie maszynowe przy każdym scaleniu: zawsze aktualne, ale wymaga sekretu i budżetu, terminologia rozjeżdża się między uruchomieniami i nikt go nie przegląda. Kopie zasobów w docs/pl/: samowystarczalne, ale każdy zrzut ekranu istniałby w dwóch kopiach, które trzeba utrzymywać identyczne.
ADR-025: INW010 sonduje dysk, żeby ustalić, czy moduł istnieje, i sprawdza tylko część importu będącą modułem
Stan: Przyjęty · 2026-09-26 · #45
Kontekst. INW010 oznacza import własnego modułu, który nie istnieje. Indeks modułów daje dwie odpowiedzi na pytanie „czy istnieje”: swoją listę (modules) i sondowanie systemu plików (ownerOf). Lista pomija pakiety przestrzeni nazw, moduły za dowiązaniem symbolicznym wychodzącym poza katalog główny i wszystko pod node_modules, __pycache__ albo w virtualenvie, a CLI i serwer języka inaczej wypisują pakiety warstw. Żadna z odpowiedzi nie zna skompilowanych modułów rozszerzeń (name.cpython-313-x86_64-linux-gnu.so), których nazwy sondowanie nie potrafi zgadnąć. Sama instrukcja importu też nie mówi, która jej część jest modułem: from shop.domain import pricing importuje podmoduł albo nazwę zdefiniowaną w shop/domain/__init__.py. Pakiet może też rozszerzyć swój __path__ (pkgutil.extend_path, pkg_resources.declare_namespace), żeby dzielić nazwę najwyższego poziomu z zainstalowaną dystrybucją: polar z korpusu robi tak ze swoim SDK, a 79 jego importów wskazuje moduły, które ma tylko SDK.
Decyzja.
- O istnieniu decyduje
ownerOf, które sonduje dysk tak, jak importuje Python, nigdy lista modułów. - Gdy sondowanie nie znajdzie modułu, pakiet, w którym by się znajdował, jest wypisywany raz (
ProjectFiles.listDir). Skompilowany moduł rozszerzenia (.so,.pyd, z tagiem ABI albo bez), źródło Cythona (.pyx) albo bajtkod (.pyc) o tej nazwie liczy się jako ten moduł. Poprawka podpowiada trzy elementy tego pakietu najbliższe brakującej nazwie według odległości edycyjnej, nigdy plik, który importuje, ani jego własny pakiet. - Sprawdzana jest tylko część będąca modułem:
Xwfrom X import nameoraz cała nazwa wimport Xifrom X import *.namenie jest sprawdzane nigdy. - Import jest własny, gdy któryś jego prefiks sonduje się jako własny moduł (pakiet najwyższego poziomu potrzebuje
__init__.py, jak w INW006). Import pod pakietem, którego__init__.pywspomina__path__albodeclare_namespace, przechodzi. - Import względny, który wychodzi ponad pakiet najwyższego poziomu, też jest błędem INW010: Python go odrzuca bez względu na to, co jest na dysku.
- Sprawdzane są tylko importy statyczne w plikach należących do warstwy. Import, który zgłasza INW010, nie dostaje dodatkowo INW006, które by mu przeczyło, a import skierowany na zewnątrz, który zgłasza INW001, nie dostaje INW010: poprawka INW001 usuwa import, a poprawka INW010 kazałaby utworzyć moduł.
- Podpowiedzi trafiają do kroków naprawy, a nie do komunikatu, więc klucz baseline'u się nie zmienia, gdy przybywa modułów.
- Indeks sonduje każdą ścieżkę raz. Serwer języka buduje indeks od nowa i ponownie sprawdza otwarte dokumenty, gdy powstaje albo znika ścieżka, która może być modułem (plik
.py,.pyi, moduł rozszerzenia albo bajtkod, albo katalog, poza katalogami ukrytymi, pamięciami podręcznymi, node_modules i site-packages), więc utworzenie brakującego modułu usuwa błąd bez naciskania klawisza. Gdy klient nie potrafi zgłaszać zdarzeń plików, serwer buduje świeży indeks przy każdym sprawdzeniu, więc błąd znika przy następnym naciśnięciu klawisza.
Konsekwencje.
-
from shop.domain import pricingbez żadnegopricingprzechodzi, gdyshop/domainjest pakietem. - Moduł generowany przy budowaniu (
_version.py,*_pb2.py) jest zgłaszany, dopóki nie pojawi się w checkoucie (#160), podobnie jak opcjonalny import zatry/except ImportError. Pakiet przestrzeni nazw współdzielony z zainstalowaną dystrybucją jest zgłaszany jako brakujący (#161). - Serwer języka buduje indeks od nowa tylko przy utworzeniu i usunięciu, więc
__init__.pyzmieniony tak, żeby rozszerzał swój__path__, zaczyna działać dopiero przy następnym utworzeniu albo usunięciu pliku. - Naruszenie znalezione w hooku kosztuje parsowanie potwierdzające, które kosztuje każde naruszenie (ADR-004), i jeden odczyt katalogu: w saleor
webhook/payloads.py(1301 linii) rośnie z 38,8 ms do 71,6 ms (p50), czyli mniej więcej tyle, ile na develop kosztuje w tym pliku naruszenie INW001 (70,1 ms);channel/tasks/saleor3_22.pyz 27,4 do 32,7 ms. - Żadnego fałszywego alarmu na pięciu repozytoriach z korpusu (6543 pliki) ani na przykładach. Cztery znaleziska, wszystkie w saleor, to naprawdę zepsute importy: import
saleor.translation.modelspodTYPE_CHECKING, który nie istnieje (klasa jest wsaleor.core.utils.translations), importsaleor.modelsi dwa importy względne, które wychodzą ponadsaleor. - Edytor i CLI zgadzają się bez względu na to, co każde z nich wypisuje, bo ani decyzja, ani podpowiedź nie czyta listy modułów.
- Sondowany jest teraz każdy import w pliku z warstwy, a nie tylko te spoza warstw; sondowanie każdej ścieżki raz utrzymuje koszt całego projektu na tym samym poziomie: pełne sprawdzenie saleor trwa 1,96 s wobec 2,15 s na develop (mediana z 8 naprzemiennych lokalnych uruchomień), a na syntetycznym repozytorium hook jest wolniejszy o 2,9 %, a pełne sprawdzenie szybsze o 1,3 % (
bench/compare.ts, próg 20 %).
Alternatywy.
- Przynależność do
modules: fałszywe błędy w edytorze dla pakietów przestrzeni nazw i wszystkiego, co pomija lista (przegląd #153), oraz przeglądanie całego projektu dla podpowiedzi przy każdym znalezisku, co kosztowało hook 50 do 130 ms na saleor. - Czytać
__init__.py, żeby sprawdzaćfrom X import name: import z gwiazdką albo__getattr__na poziomie modułu może zdefiniować dowolną nazwę, więc sprawdzanie tekstu byłoby zgadywaniem. - Pomijać importy wewnątrz
try/except ImportError: agent mógłby wtedy uciszyć regułę, owijając import, a tę furtkę zamykają kroki naprawy. - Wyłączyć pamięć podręczną sondowania w serwerze języka: poprawne, ale otwarty dokument nadal pokazywałby nieaktualny błąd do następnego naciśnięcia klawisza. Tak działa to u klienta bez zdarzeń plików.
ADR-026: Zgłaszaj nieczytelne cele importów dynamicznych w warstwach wewnętrznych
Stan: Przyjęty · 2026-09-26 · #46
Kontekst. ADR-015 sprawdza import dynamiczny tylko wtedy, gdy jego celem jest stały napis, a resztę zostawił na osobną decyzję. Wszystko inne przechodziło bez słowa: importlib.import_module(name), import_module(f"shop.{layer}.db"), exec(code), względne import_module, którego package jest zmienną, oraz literał z sekwencją \N{...} (jej dekodowanie wymaga tabeli nazw Unicode, której silnik nie zawiera). Dla agenta, którego INW011 właśnie zablokowało, włożenie nazwy modułu do zmiennej to kolejne obejście, a Inwards nie umie jej wyliczyć bez uruchamiania kodu użytkownika (C4).
Decyzja.
- Wywołanie loadera, którego celu Inwards nie umie odczytać, jest zgłaszane jako INW011 na poziomie błędu, z komunikatem, że celu nie da się sprawdzić. Dotyczy to
import_modulez nazwą, która nie jest literałem, albo z nazwą względną, którejpackagejest podane, ale nie jest literałem,__package__ani__name__;__import__z wyliczaną nazwą lublevelalbo zfromlist, które nie jestNoneani listą czy krotką literałów;run_modulez wyliczaną nazwą; orazexeclubevalz wyliczanym kodem. Argument, którego nie ma, gdy wywołanie przekazuje*argsalbo**kwargs, które nie jest dosłownym słownikiem z kluczami-napisami, liczy się jako wyliczany, bo może się kryć w rozpakowaniu; dosłowne**{"package": "shop"}jest odczytywane dokładnie. Loadery są rozpoznawane przez te same aliasy co w ADR-015, a wyliczane wywołanie wewnątrz dosłownego kodu dlaexecliczy się przy wywołaniu zewnętrznym. - Jest zgłaszane tylko w warstwach, które mają warstwę zewnętrzną. W najbardziej zewnętrznej warstwie kierunek dopuszcza każdy własny cel, więc nie ma czego sprawdzać, a to właśnie tam należą loadery wtyczek i korzenie kompozycji. Pliki poza wszystkimi warstwami pozostają niesprawdzane.
- Poprawka daje dwa wyjścia: zapisać cel jako literał (albo jako instrukcję importu) albo przenieść loader do najbardziej zewnętrznej warstwy i przekazać to, co ładuje, przez parametr typowany protokołem
typing.Protocolwarstwy wewnętrznej. compilez wyliczanym kodem nie jest zgłaszane. Buduje tylko obiekt kodu, a do jego uruchomienia trzebaexecalboeval, które są zgłaszane. Dzięki temu cisza jest też pofrom re import compileicompile(pattern), bo ADR-015 zawsze czytacompilejako funkcję wbudowaną. Nie jest zgłaszane takżeexec(compile("<literal>", ...)), o ile opisane niżej sprawdzenie nie uznacompileza ponownie związane: literał jest odczytywany przy wywołaniucompile.- Samo
execalboevalz wyliczanym kodem jest pomijane tylko wtedy, gdy kod na pewno ponownie wiąże tę nazwę przy wywołaniu. Wiązaniem musi byćdef,class, zwykłe przypisanie albo import umieszczone bezpośrednio w ciele modułu, przed instrukcją najwyższego poziomu, która zawiera wywołanie, albo bezpośrednio w ciele funkcji otaczającej wywołanie; albo parametr funkcji lub lambdy, której ciało zawiera wywołanie; albo cel pętliforwewnątrz tej pętli. Wiązania podif,try,withczywhilesię nie liczą. Wyjątek jest wyłączony dla całego pliku, gdy którekolwiek wiązanie tej nazwy może być funkcją wbudowaną: przypisanie, operator morsa, celfor,withalboexceptczy domyślna wartość parametru, których wartość wspomina loader albo moduł, który go zawiera (exec = exec,eval = builtins.eval,def run(code, exec=exec));defalboclass, których dekoratory lub argumenty klasy (klasy bazowe,metaclass=, argumenty nazwane) go wspominają; albo import zbuiltins,importlib,runpy, modułu względnego lub własnego modułu projektu, bo własny kod może ponownie eksportować funkcję wbudowaną (o tym, co jest własnym kodem, decyduje indeks modułów silnika). Wyłączają go teżglobal,nonlocalalbodeltej nazwy, a także import z gwiazdką lub każda wzmianka oglobals,vars,locals,setattr,delattr,__dict__,__builtins__albosys.modules, przez które kod może przywrócić funkcję wbudowaną. Kod treningowy w PyTorchu często definiujeeval(model, loader), a zgłaszanie tego jako importu dynamicznego byłoby szumem z bezsensowną poprawką. Dosłowny kod jest nadal czytany bez względu na to, z czym związana jest nazwa, jak postanowił ADR-015. - Wywołania, które zawodzą w czasie działania, pozostają niezgłoszone: względne
import_modulebezpackage, zpackage=Nonealbopackage="", względnerun_module, pusta nazwa. - Nazwa związana z kilkoma loaderami zgłasza każde ładowanie raz.
- Poziom błędu, jak w reszcie INW011. Ostrzeżenia nie zmieniają kodu wyjścia CLI, przechodzą przez hook i Stop gate i nie trafiają do baseline'u, więc ostrzeżenie przepuściłoby obejście.
Konsekwencje.
- Obejście przez nazwę w zmiennej jest zgłaszane, przez każdy alias, który śledzi ADR-015. Testy obejmują każdy loader, aliasy, f-stringi, zmienne, literały z
\N{...}, argumenty za*argsi**kwargs, względneimport_modulez nieznanym pakietem oraz każde ponowne wiązanieexec,evalalbocompile, które nie przesłania funkcji wbudowanej przy wywołaniu. Podpowiedź loaderów nie wymaga zmian, aprescan-diffnadal niczego nie przeocza. - Uzasadnione loadery działające w czasie wykonania są zgłaszane w warstwach wewnętrznych. Na korpusie prawdziwych repozytoriów (5 repozytoriów, 6543 pliki) zmiana dodaje 4 wyniki, każdy to
import_module(path)ładujące skonfigurowaną klasę albo wtyczkę: jeden wseedwork.applicationz python-ddd, trzy w saleorze (saleor.core.telemetry,saleor.plugins,saleor.schedulers). Ich zespoły przeniosłyby każdy loader na zewnątrz albo przyjęły go do baseline'u. - Stałe cele, które nie są literałami (stała na poziomie modułu
TARGET = "...",str.format,%, konwersje w f-stringach, takie jak{'shop'!s}), były zgłaszane jako niesprawdzalne zamiast przechodzić. #79 je zwija, więc teraz są zgłaszane dokładnie; nazwa, która może zostać ponownie związana, pozostaje niesprawdzalna. - Wyjątek dla ponownego wiązania przeocza funkcję wbudowaną przekazaną jako argument:
def run(exec, c): return exec(c)wywołane jakorun(exec, code)nie jest zgłaszane, bo parametr przesłania funkcję wbudowaną wewnątrzrun. Przeocza też funkcję wbudowaną osiągniętą przez obiekt, który nie nazywa loadera,__self__,__globals__ani funkcji zapisującej przestrzeń nazw. Od #79print.__self__liczy się jako modułbuiltins, więcexec = operator.attrgetter("exec")(print.__self__)wyłącza wyjątek. Ponieważ jest ostrożny, zgłasza też niektóre wywołania, które nie są funkcją wbudowaną: zmienną wyrażenia listowego ([eval(m) for eval in evaluators]), nazwę metody użytą w ciele jej własnej klasy, przechwyceniematch, każde wiązanie podifalbotrylub przezglobal, nawet jeśli wykonuje się przed wywołaniem, oraz każde ponowne wiązanie w pliku, który dotyka funkcji zapisującej przestrzeń nazw albo ma import z gwiazdką. - Zgłoszenie dotyczy tylko kierunku. W najbardziej zewnętrznej warstwie niesprawdzalne wywołanie wciąż może bez zgłoszenia sięgnąć do własnego kodu poza wszystkimi warstwami (INW006), a obiekt kodu z
compileuruchomiony czymś innym niżexecczyeval(types.FunctionType) zostaje przeoczony.
Alternatywy. Zgłaszać w każdej warstwie, także najbardziej zewnętrznej: oznacza korzenie kompozycji i rejestry wtyczek, gdzie loader działający w czasie wykonania to właściwy projekt. Ostrzeżenie zamiast błędu: przechodzi przez hook i Stop gate, więc obejście agenta i tak by się udało. Rozwiązywać znane prefiksy (f"shop.plugins.{name}" może sięgnąć tylko do shop.plugins): mniej zgłoszeń, gdy prefiks leży w warstwie wewnętrznej, ale więcej kodu dla przypadku, którego korpus jeszcze nie ma; późniejsze zgłoszenie może to dodać, jeśli prawdziwe projekty będą tego potrzebować. Oznaczać każde wywołanie loadera w warstwie wewnętrznej, dosłowne czy nie (alternatywa z ADR-015): zgłasza też import_module("json").
ADR-027: select, ignore i severity dla każdej reguły w tabeli [tool.inwards.rules]
Stan: Przyjęty · 2026-09-26 · #43
Kontekst. Zespół, który wprowadza Inwards do starszego kodu, chce włączać reguły po jednej albo najpierw widzieć naruszenia danej reguły jako ostrzeżenia, zanim zaczną blokować. Użytkownicy Ruffa oczekują select i ignore, ale [tool.inwards] ma już klucz ignore: nazwy modułów pomijanych przez ostrzeżenie INW006 o nieprzypisanym pakiecie, które zapisuje inwards init. Diagnostyki pochodzą z silnika i z pięciu sprawdzeń, które adaptery wywołują bezpośrednio (checkShape, checkRequired, checkSelectors, checkPrefixes, checkMoves), a Stop gate porównuje konfiguracje jako JSON.
Decyzja.
- Podtabela.
[tool.inwards.rules]zawieraselectiignore, listy kodów reguł, orazseverity, tabelę z kodu na"error"albo"warning". Kluczignorenajwyższego poziomu zachowuje swoje znaczenie. Bezselectzgłasza każda reguła;ignorema pierwszeństwo przedselect.severityustawia poziom każdej diagnostyki reguły, także tych, które reguła zgłasza na własnym poziomie: przyINW006 = "error"ostrzeżenie o pakiecie staje się błędem. - Dokładne kody, sprawdzane. Kod, którego nie ma w rejestrze, to błąd konfiguracji, tak jak nieznany klucz. Bez prefiksów: kody nie są pogrupowane według kategorii, a prefiks taki jak
INW00po cichu objąłby reguły dodane później. Pustyselectteż jest błędem, bo do wyłączania reguł służyignore. - INW000 jest stała.
ignoreaniseveritynie mogą jej wymienić, aselectjej nie wyłącza. Plik, którego zadeklarowane kodowanie może ukryć importy, dostaje INW000 zamiast sprawdzenia, więc wyłączenie INW000 albo obniżenie jej poziomu przepuściłoby taki plik niesprawdzony. - Sprawdzenie układu w sesji też jest stałe. Porównanie INW006 w Stop gate ze startem sesji (prefiks opróżniony od tego czasu, kod warstwy przeniesiony poza wszystkie warstwy) pomija tabelę. To obrona przed
mv shop/domain shop/core, czyli obejście, a nie reguła, którą zespół wprowadza stopniowo, a przyselect = ["INW001"]alboignore = ["INW006"]takie przeniesienie by przeszło. - Stosowana w rdzeniu, na końcu. Każda inna funkcja rdzenia, która zwraca diagnostyki adapterowi, stosuje tabelę, więc
inwards check, hooki, Stop gate i serwer języka są zgodne.Engine.checkFilesstosuje ją po tym, jak zostawi jedno ostrzeżenie INW006 na pakiet, więc skonfigurowany poziom nie zmienia liczby zgłoszonych kopii. Reguły nadal się wykonują; ich diagnostyki są potem odrzucane albo dostają nowy poziom. - Ostrzeżenie to ostrzeżenie. Reguła ustawiona na
"warning"pojawia się w każdym formacie, ale jak każde ostrzeżenie nie zmienia kodu wyjścia, nie blokuje ani hooka edycji, ani Stop gate i nie trafia do baseline'u. - Baseline.
inwards baselinezapisuje tylko to, co zgłasza sprawdzenie, więc pomija reguły wyłączone albo ustawione na ostrzeżenie. Wpisy takiej reguły, które już są w pliku, są uśpione: nie liczą się jako naprawione (resolved),inwards baselineje zachowuje i znów obowiązują, gdy reguła wróci do poziomu błędu. W drugą stronę: wpis zapisany, gdy reguła była podniesiona do błędu, po powrocie reguły do domyślnego poziomu pasuje do odpowiadającego mu ostrzeżenia, więc też nie liczy się jako naprawiony. - SARIF.
rules[]nadal wymienia każdą zarejestrowaną regułę z domyślnym poziomem z rejestru wdefaultConfiguration.level. Każdy wynik ma skonfigurowanylevel, który pokazują przeglądarki SARIF. Wyłączona reguła nie ma wyników. - Run log.
codesiseveritieszapisują to, co zostało zgłoszone, po zastosowaniu tabeli. - Chroniona jak reszta. Tabela jest wewnątrz
[tool.inwards], więc config guard odrzuca edycję, która ją zmienia, a zmiana przez Bash oblewa Stop gate. Oba przypadki mają testy.
Konsekwencje.
- Zespół może wprowadzać reguły stopniowo bez baseline'u i pokazywać regułę jako ostrzeżenia, zanim zacznie blokować.
- Żadnej osobnej ścieżki w adapterach: serwer języka stosuje tabelę bez własnych zmian.
-
rules.ignoreiignorenajwyższego poziomu mają wspólne słowo, ale nie znaczenie. Zmiana nazwy klucza najwyższego poziomu to zmiana łamiąca zgodność, odłożona do schematu konfiguracji v2 (#51). - Wyłączona reguła nadal kosztuje czas sprawdzenia. Pominięcie jej wymagałoby przekazania tabeli do każdej reguły, żeby zaoszczędzić kilka milisekund.
- Konfiguracja, która wymienia regułę znaną tylko nowszemu Inwards, kończy się kodem wyjścia 2; jaśniejszy komunikat daje
required-version. - INW006 nie da się całkiem wyłączyć: sprawdzenie układu w sesji nadal blokuje przeniesienie warstwy.
- Serwer języka czyta tabelę przy starcie, więc zmiana wymaga ponownego uruchomienia, a błąd konfiguracji (na przykład nieznany kod) trafia tylko do jego kanału wyjściowego (#163).
- Po edycji tabeli przez Bash Stop gate oblewa zmianę, ale sprawdza z edytowaną konfiguracją, więc nie wymienia tego, co edycja ukrywa (#164).
- Brak ustawień dla pojedynczych plików lub ścieżek. Należą do wyciszeń (#50).
Alternatywy. select i ignore na najwyższym poziomie, jak w Ruffie: znajome, ale ignore jest zajęte, a odróżnianie INW001 od modułu o nazwie tests po samym kształcie to zgadywanie. Jeden klucz na regułę, INW001 = "off", jak w ESLint: zwięzłe, ale nie da się powiedzieć „tylko te reguły”. Prefiksy kodów: patrz wyżej. Filtrowanie w każdym adapterze: cztery miejsca wywołań (sprawdzenie, sprawdzenie układu w Stop gate, dwa w serwerze języka), które mogłyby się rozjechać.
Poprawka, 2026-09-28: reguły opt-in i tabele opcji (#181). Kolejne reguły (reguła cienkiego endpointu, rodzina FastAPI) oceniają zawartość handlerów według progów wybranych przez zespół, więc muszą startować wyłączone i przyjmować opcje. select nie potrafi włączyć jednej reguły bez wyłączenia pozostałych, a [[tool.inwards.rules]] z #98 nie zmieści się w TOML obok tabeli rules.
- Domyślnie włączona albo wyłączona. Każdy wpis rejestru ma
default: "on"albo"off". Każda dotychczasowa reguła ma"on", więc żadna istniejąca konfiguracja się nie zmienia. Reguła wyłączona zgłasza tylko wtedy, gdy wymienia jąselectalbo nowy kluczextend-select. extend-select(nazwa z Ruffa) włącza reguły obokselectalbo obok reguł domyślnych, gdyselectnie ma.ignorenadal wygrywa z oboma. Kody są sprawdzane jak pozostałe, a INW000 nie może się tam znaleźć.- Tabele opcji. Opcje reguły trafiają do
[tool.inwards.rules.<rule-name>], z kluczem w postaci nazwy kebab-case, więc nie kolidują z czterema kluczami list i tabel. Każda reguła przyjmujemodules, listę wpisów w gramatycelayers[].modules(ADR-034): prefiks taki jakshop.domainobejmuje ten pakiet i wszystko pod nim, a selektor taki jakshop.*.apiużywa symboli wieloznacznych. Reguła zgłasza tylko w pasujących modułach, a diagnostyka w samympyproject.tomlnie jest ograniczana. Reguła z własnymi opcjami dodaje swoje klucze; nieznany klucz albo zły typ to błąd konfiguracji, który podaje nazwę klucza. INW000 nie może mieć tabeli, z powodu opisanego wyżej. Tabele są sortowane według nazwy, więc zmiana ich kolejności niczego nie zmienia. - Tabela niczego nie włącza. Tabela dla reguły wyłączonej to ostrzeżenie wskazujące tę tabelę w
pyproject.toml, z kodem tej reguły, a nie błąd, więc zespół może przygotować opcje przed włączeniem reguły. Tabela nie filtruje tego ostrzeżenia, bo reguła, której dotyczy, jest wyłączona. - SARIF wymienia regułę opt-in w
rules[]zdefaultConfiguration.enabled = false, więc wynik zostaje jedną listą. Reguły włączone mają wpis taki jak wcześniej. - Baseline. Wpis reguły wyłączonej w danym module (opt-in i niewybranej albo wyłączonej tam przez
modules) jest uśpiony, tak jak wpis reguły zignore. - Chronione. Nowe klucze są wewnątrz
[tool.inwards], więc config guard odrzuca ich edycję przez agenta, a zmiana przez Bash oblewa Stop gate. Oba przypadki mają testy.
Zgłoszenie prosiło o selektory kształtów z #95, ale tam shop.domain pasuje do jednego pakietu i niczego pod nim, co jest złym domyślnym zachowaniem przy ograniczaniu reguły; gramatyka warstw znaczy to samo co warstwa. inwards check nie ma listy reguł, więc „opt-in” pojawia się tylko w kolumnie Default w indeksie reguł w dokumentacji.
ADR-028: Wyciszenie w linii wymaga powodu, a agent domyślnie nie może go dodać
Stan: Przyjęty · 2026-09-26 · #50
Kontekst. Zespół czasem musi na stałe zaakceptować jeden import: stary adapter, moduł dołączony do repozytorium, moduł generowany. Baseline akceptuje naruszenia jako zbiór i ma się kurczyć, a [tool.inwards.rules] działa na całą regułę, nie na linię. Ruff, mypy i ESLint rozwiązują to komentarzem w linii. W Inwards komentarz jest jednak też najtańszym sposobem, żeby agent zazielenił sprawdzenie, a hook nie odróżni, kto napisał daną linię. Mechanizm z #134 już teraz bezpiecznie czyta plik w stanie ze startu sesji, z blobu git, za który ręczy manifest startowy.
Decyzja.
- Składnia.
# inwards: ignore[INW001] reason="why"ukrywa każdą diagnostykę wymienionych reguł, która wskazuje na linię komentarza, niezależnie od ich liczby (from x import a, bdaje dwie). W jednym komentarzu może być kilka kodów (ignore[INW001,INW005]), a dyrektywa może stać po komentarzu innego narzędzia w tej samej linii; druga dyrektywa w tym samym komentarzu to błąd INW009, a nie coś, co zostanie po cichu przeczytane albo pominięte. Liczy się linia, na którą wskazuje diagnostyka: w imporcie w nawiasach linia importowanej nazwy, a nie linia zfrom; w imporcie dynamicznym rozpisanym na kilka linii pierwsza linia wywołania. Nie ma formy ogólnej bez kodów, formy dla całego pliku ani formy dla następnej linii: każda ukryłaby więcej niż diagnostykę, którą ktoś obejrzał. - Rozliczalne. Powód jest obowiązkowy. Komentarz w złej postaci, z pustym albo brakującym powodem albo z kodem nieznanym lub takim, którego nie da się wyciszyć, niczego nie ukrywa i sam jest błędem, INW009
suppression-comment. Poprawny kod, który nie pasuje do żadnej diagnostyki w swojej linii, to ostrzeżenie INW009, bo później po cichu ukryłby tam nową diagnostykę; reguła wyłączona w[tool.inwards.rules]nie jest zgłaszana jako nieużyta. INW009 podlega tabeli jak każda reguła. - Co można wyciszyć. Każdą regułę, która wskazuje na linię kodu Pythona: INW001, INW005, INW006, INW010, INW011 i reguły dodane później (dla INW010 to np. moduł generowany, którego nie ma w świeżym checkoucie, #160). Nie INW000 (plik w ogóle nie jest sprawdzany, więc przy zadeklarowanym kodowaniu „komentarz” może być kodem), INW007 i INW008 (dotyczą drzewa pakietów; zmienia się je w konfiguracji kształtu) ani samej INW009. W pliku z INW000 wyciszenia w ogóle nie są czytane.
- Czytane z drzewa składni. Komentarze pochodzą z pełnego parsowania, więc
x = "# inwards: ignore[...]"się nie liczy. Plik, którego tekst zawierainwards: ignore, pomija szkielet importów i od razu dostaje pełne parsowanie, które z jednego drzewa daje i importy, i komentarze, więc kosztuje tyle co plik z naruszeniem. Pominięcie szkieletu tylko zwiększa dokładność sprawdzenia; prescan i argument za jego poprawnością (ADR-004) się nie zmieniają. - Stosowane w rdzeniu.
Engine.checkFileiEngine.checkstosują wyciszenia dla każdego pliku, przed[tool.inwards.rules], więc CLI, hooki i serwer języka są zgodne.Engine.checkzwraca też wyciszone diagnostyki z ich powodami;checkFilesnadal zwraca tylko to, co jest zgłaszane. - Widoczne. Wyjście tekstowe i zwięzłe kończy się linią „N findings suppressed by inline comments”, a podsumowanie JSON ma
suppressed(tylko gdy są jakieś). SARIF wymienia każdą wyciszoną diagnostykę jako wynik z wyciszenieminSource, któregojustificationto powód, więc code scanning pokazuje ją jako wyciszoną, zamiast ją zgubić. Run log zapisujesuppressedirejecteddla każdego uruchomienia, ainwards statsliczy odrzucone wyciszenia. - Domyślnie
agent-suppressions = "deny". W hookach Claude Code wyciszenie jest uznawane, gdy jego plik jest bajt w bajt taki jak na starcie sesji (SHA-256 z manifestu startowego), bo agent go nie dotknął, niezależnie od tego, czy był zacommitowany; w przeciwnym razie tylko wtedy, gdy plik w stanie ze startu sesji (blob git z #134) miał tę samą diagnostykę (reguła, moduł, komunikat) też wyciszoną, w tym samym pliku, kopia za kopię. Plik ma znaczenie, boorder.pyiorder.pyimają wspólny moduł: wyciszenie przeniesione z jednego do drugiego jest nowe. Wyciszenie, które agent dodał, skopiował na inny import, przeniósł albo rozszerzył o inny kod, nie jest uznawane, podobnie jak wyciszenie w pliku, który agent utworzył, przemianował albo dowiązał. Oba sprawdzenia, a także to z #134, trzymają się jednego niezmiennika: plik ma tożsamość startową tylko wtedy, gdy jego ścieżka w zapisanej postaci (katalog roboczy tak, jak go podano, połączony ze ścieżką pliku, z..zastosowanym tekstowo, względem rzeczywistego katalogu głównego projektu) jest równa jego ścieżce fizycznej, a sam plik nie jest dowiązaniem symbolicznym. Dlatego nowy dowiązany plik (ln -s order.pyi order.py), katalog roboczy wewnątrz nowego dowiązanego katalogu,..przez któryś z nich ani plik ze startu podmieniony na dowiązanie do tych samych bajtów nie mogą pożyczyć zapisu startowego. Stop gate ponownie sprawdza plik ze startu, który stracił tożsamość, nawet gdy jego hash zawartości się nie zmienił. Diagnostyka jest wtedy traktowana dokładnie tak, jakby komentarza nie było: wpis baseline'u nadal ją akceptuje, naruszenie, które plik miał na starcie sesji, nadal jest tylko kontekstem (#134), a każde inne blokuje jak każde naruszenie, z notą, która mówi dlaczego. Żeby to działało, wyciszona diagnostyka zużywa pasujący wpis baseline'u, po diagnostykach zgłoszonych, więc ten wpis też nie liczy się jako naprawiony. Zmiana samego powodu istniejącego wyciszenia niczego nie zmienia. Tryb jest czytany z konfiguracji ze startu sesji, więc edycja przez Bash nie zmienia niczego w hookach i oblewa Stop gate; config guard chroni ten klucz jak każdy klucz[tool.inwards]."allow"uznaje każde wyciszenie.inwards check, CI i serwer języka zawsze uznają wyciszenia: nie mają sesji, z którą mogłyby porównać.
Konsekwencje.
- Jeden zaakceptowany import nie wymaga już baseline'u ani wyłączenia reguły, a każdy taki wyjątek ma swój powód w kodzie, obok importu.
- Agent nie może uciszyć naruszenia komentarzem, dopóki właściciel na to nie pozwoli, a odrzuconą próbę widać w
inwards stats. - Dodanie tej funkcji nie zmienia niczego w istniejących projektach: żaden plik nie ma jeszcze wyciszenia, a nowy klucz jest opcjonalny.
- Przy
"deny"wyciszenie w pliku, który na starcie sesji był niezacommitowany albo nieśledzony, albo w dowolnym pliku projektu poza git, liczy się jako nowe, gdy tylko agent ten plik zedytuje, bo hooki nie mogą udowodnić jego zawartości na starcie (#134). Od #157 dotyczy to tylko takiego pliku, który jest zbyt duży, żeby hooki zachowały jego kopię na starcie sesji (ponad 512 KiB albo ponad limit 4 MiB takich plików). Plik, którego agent nie rusza, zachowuje swoje wyciszenia. Właściciel commituje wyciszenie, zanim przekaże taki plik agentowi. - Przeniesienie wyciszenia między dwoma importami, które dają tę samą diagnostykę (ten sam cel dwa razy w jednym module), przechodzi niezauważone. Nie ukrywa niczego nowego.
- Zmiana nazwy albo przeniesienie pliku z wyciszeniem sprawia, że wyciszenie jest nowe, bo nowa ścieżka nie ma zawartości ze startu. Tak samo jest z plikiem osiąganym przez dowolne dowiązanie symboliczne wewnątrz projektu, nawet takie, które istniało na starcie sesji.
- Powód nie może zawierać
", a nic nie sprawdza, czy mówi cokolwiek sensownego. To zadanie przeglądu kodu. - Plik z wyciszeniem zawsze dostaje pełne parsowanie, które czysty plik bez wyciszenia pomija.
- Przy
stop-gate = "project"Stop gate porównuje każde wyciszenie w projekcie z zawartością ze startu, czyli jedno sprawdzenie więcej na każdy plik, który je ma.
Alternatywy. Ogólne komentarze w stylu # noqa: INW001 albo # type: ignore: czytają je inne narzędzia, a forma bez kodów ukryłaby wszystko w linii. Dyrektywa dla następnej linii albo całego pliku: ukrywa diagnostyki, których nikt nie obejrzał. Wyciszenia według ścieżki w pyproject.toml: jeszcze jedno miejsce do utrzymywania w zgodzie z kodem, a config guard musiałby oceniać każdy wpis; ścieżki zostają dla #160 i konfiguracji w schemacie v2 (#51). Uznawać wyciszenia agenta i tylko je liczyć: licznik nie zatrzyma naruszenia w kodzie. Odrzucać każde wyciszenie w zmienionym pliku: istniejące wyciszenia właściciela blokowałyby każdą edycję tego pliku.
ADR-029: Moduły generowane przechodzą INW010, domyślnie moduły z protoc i moduły wersji
Stan: Przyjęty · 2026-09-26 · #160
Kontekst. INW010 ustala na dysku, czy moduł istnieje (ADR-025). Niektóre moduły istnieją dopiero po kroku budowania: *_pb2.py i *_pb2_grpc.py z protoc, _version.py z setuptools-scm albo hatch-vcs. Checkout programisty je ma, a świeży checkout w CI nie, więc ten sam commit przechodzi lokalnie i oblewa w CI. Dotąd wyjściem był baseline, który ma się kurczyć i nie nadaje się do modułu istniejącego w czasie działania programu; wyciszenie w linii (ADR-028) przy każdym imporcie takiego modułu; albo wyłączenie INW010 w [tool.inwards.rules].
Decyzja.
- Klucz
generatedw[tool.inwards]: wzorce modułów, które INW010 traktuje jako istniejące, gdy sonda ich nie znajduje. - Wzorce to nazwy z kropkami z
*i?w segmentach. Bez zbiorów w nawiasach: zbiór może zawierać dowolny znak, więc[!/]*przeszedłby sprawdzenie znaków, a i tak obejmowałby każdy segment. Wzorzec pasuje do całych segmentów w dowolnym miejscu nazwy modułu, tak jakignorena najwyższym poziomie, a symbol wieloznaczny nigdy nie przechodzi przez kropkę:*_pb2obejmujeshop.api.orders_pb2,_versionobejmujeshop._version,shop.api.genwszystko wshop/api/gen/. Porównywana jest rozwiązana część importu będąca modułem, więcfrom .orders_pb2 import Orderwshop.apitoshop.api.orders_pb2. - Walidowane. Pusty segment, znak, którego nie może być w nazwie modułu (w tym
[i]), albo wzorzec złożony z samych symboli wieloznacznych i kropek (*,*.*) to błąd konfiguracji. Ten ostatni wyłączyłby INW010, a to zadanie[tool.inwards.rules]. - Domyślnie włączone. Bez tego klucza lista to
["*_pb2", "*_pb2_grpc", "_version"]. Takie nazwy nadają narzędzia, rzadko ludzie, więc brak takiego modułu prawie zawsze oznacza krok budowania, który się nie wykonał. Ustawienie klucza zastępuje listę domyślną, tak jakdeny-librarieszastępuje swoją (ADR-023), agenerated = []ją wyłącza. - Dopasowanie bez wyrażeń regularnych. Nazwa modułu pochodzi z importu, który pisze agent, a tłumaczenie na wyrażenie regularne (
.*za każdą gwiazdkę) się cofa:*_*_*_*_pb2na segmencie o długości 240 znaków zajmowało w hooku ponad 300 ms. Iteracyjne dopasowanie dwoma wskaźnikami, które wznawia tylko za ostatnią gwiazdką, kosztuje O(wzorzec × segment). Wzorce elementów kształtu pakietu korzystają z tego samego dopasowania, co naprawia ich zbiory w nawiasach, w których tłumaczenie na wyrażenie regularne zamieniało?i*w symbole wieloznaczne. - Czyta go tylko INW010. Indeks modułów nadal widzi moduł jako brakujący, więc pozostałe reguły oceniają go jak każdy brakujący moduł: INW001 patrzy na nazwę i zgłasza import skierowany na zewnątrz niezależnie od tego, co jest na dysku, INW005 uznaje go za własny przez najbliższy istniejący pakiet, a INW006 wskazuje ten pakiet.
- Chronione jak każdy klucz w
[tool.inwards]: config guard odrzuca jego edycję przez agenta, a Stop gate oblewa zmianę zrobioną przez Bash. Test przypina config guard. - Bez ignorowania INW010 dla pliku. Wyciszenie w linii już jest wyjściem dla jednej linii, a wyciszenia według ścieżki w konfiguracji zostają dla schematu konfiguracji v2 (#51), jak zdecydowało ADR-028.
Konsekwencje.
- Projekt, który importuje moduły z protoc albo moduły wersji, dostaje w CI ten sam wynik co lokalnie, bez konfiguracji. Testy przypinają oba checkouty, dla listy domyślnej i dla skonfigurowanego wzorca.
- To nie jest zmiana łamiąca zgodność. INW010 nie trafiło jeszcze do żadnego wydania (0.2.0 jest starsze), a lista domyślna tylko usuwa diagnostyki; nie zmienia się żaden kod wyjścia, klucz ani pole
diagnostics@1. - Na korpusie (5 repozytoriów, 6543 pliki) nie zmienia się żadna diagnostyka, a cztery diagnostyki INW010 w saleor zostają.
- Zmyślony import, którego nazwę obejmuje wzorzec (
shop.api.payments_pb2bezpayments.proto), przechodzi INW010, domyślnie dla*_pb2,*_pb2_grpci_version. Nadal zawodzi przy uruchomieniu kodu. Zespół, który chce je wyłapywać, ustawiagenerated = []i uruchamia generator przed sprawdzeniem. - INW006 nadal widzi moduł jako brakujący. Moduł generowany leżący bezpośrednio w pakiecie nad warstwami (
shop._versionimportowany z warstwy) dostaje błąd INW006 w obu checkoutach, ale bez pliku treść mówi o pakiecie nad warstwami, a z plikiem o module poza warstwami, więc wpis baseline'u zrobiony w jednym checkoucie nie pasuje w drugim. Moduł generowany w pakiecie poza warstwami (shop.persistence.orders_pb2) ma w obu tę samą treść. - Generowany pakiet najwyższego poziomu bez zacommitowanego
__init__.pynie jest własny dla żadnej reguły: INW010 go nie sprawdza, a INW005 traktuje go jak bibliotekę. - „W dowolnym miejscu” to szeroko: wzorzec
apiobejmuje każdy moduł z segmentemapi. Dłuższy wzorzec (shop.api.gen) jest węższy.
Alternatywy.
- Bez listy domyślnej: surowiej, ale każdy projekt z gRPC albo setuptools-scm najpierw trafiłby na błąd w CI i dopiero z niego dowiedział się o kluczu, i to dla nazw, które prawie nigdy nie pochodzą od agenta.
- fnmatch na całej nazwie z kropkami, z
*przechodzącym przez kropki: przykład z issue,*._version, działałby tak, jak jest zapisany, ale*znaczyłby co innego niż wignorei we wzorcach kształtu, gdzie zostaje w obrębie segmentu, ashop.*sięgałby na dowolną głębokość. - Dopasowanie tylko całej nazwy:
*_pb2potrzebowałby wtedy w każdym wzorcu formy „na dowolnej głębokości”, takiej jak**z selektorów kształtu. - Nauczyć indeks modułów, że moduły generowane istnieją, dla wszystkich reguł: INW006 miałby tę samą treść w obu checkoutach, ale INW005, INW006 i serwer języka wierzyłyby w pliki, których nie ma, a indeks potrzebowałby konfiguracji.
- Ignorowanie INW010 dla pliku w konfiguracji: jeszcze jedno miejsce do utrzymywania w zgodzie z kodem, a wyciszenie w linii już istnieje.
- Zbiory w nawiasach fnmatch, jak we wzorcach elementów kształtu: zawartość zbioru omija sprawdzenie znaków, a
*i?wystarczają na każdy przypadek z issue.
ADR-030: Konteksty ograniczone jako tabela contexts z dosłownymi prefiksami
Stan: Przyjęty · 2026-09-27 · #51
Kontekst. Warstwy opisują jedną cebulę: uporządkowaną listę, w której każdy moduł może importować warstwy wymienione przed nim. Konteksty ograniczone (bounded contexts) i pionowe wycinki przecinają ją w poprzek. orders i billing mają każdy swoją domenę i aplikację, a zamówienia mogą korzystać z rozliczeń tylko przez ich API. ADR-005 obiecywał, że takie nieliniowe reguły dostaną własne tabele, żeby prosty przypadek pozostał prosty. INW002 (konteksty zależą od siebie tylko tak, jak to zadeklarowano) i INW003 (kod z zewnątrz korzysta tylko z publicznych modułów kontekstu) potrzebują wspólnej definicji tego, co kontekst posiada i na co pozwala.
Decyzja.
- Tabela
[[tool.inwards.contexts]], jeden wpis na kontekst, z kluczaminame,modules,publicidepends-on. Klucze wymienia dokumentacja konfiguracji. - Dosłowne prefiksy, wygrywa najdłuższe dopasowanie.
modulesipublicto pełne nazwy modułów rozdzielone kropkami, tak jak wpisy warstw. Moduł należy do kontekstu, którego prefiks dopasowuje najdłuższą część jego nazwy, więc zagnieżdżone konteksty działają, a kolejność tabel nigdy nie ma znaczenia. Ten sam prefiks w dwóch kontekstach to błąd konfiguracji. Selektory z gwiazdkami (shop.*) zostają dla #191, który wprowadzi je najpierw do warstw; do tego czasu gwiazdka w kontekście jest błędem konfiguracji, a nie po cichu dosłownym tekstem. publicjest bezwzględne i musi należeć do kontekstu. Wpis publiczny to pełna nazwa modułu, a nie nazwa względna wobec kontekstu, i musi należeć do tego kontekstu według reguły najdłuższego dopasowania. Moduł jest publiczny, gdy leży na publicznym prefiksie albo pod nim i należy do tego kontekstu, więc kontekst zagnieżdżony w publicznym pakiecie zachowuje swoje wnętrze jako prywatne. Publiczność dotyczy modułów: importowana nazwa jest najpierw rozwiązywana do swojego modułu.depends-onjest bezpośrednie. Wymienia konteksty, z których ten może importować. Nie przechodzi dalej przez łańcuch i nie działa w drugą stronę. Odwołanie do kontekstu zadeklarowanego niżej jest w porządku; własna nazwa, nieznana nazwa i powtórzenie to błędy konfiguracji. Parser dopuszcza cykle między kontekstami; może ich zabronić INW004.- Konteksty i warstwy się sumują. Zadeklarowana zależność ani moduł publiczny nigdy nie pozwalają na import, którego zabrania kolejność warstw, a przynależność do kontekstu nic nie mówi o warstwie ani odwrotnie. Sprawdzenia kontekstów działają niezależnie od tego, czy plik należy do jakiejś warstwy.
- Uprawnienia dla INW002 i INW003. INW002 wymaga
depends-ontylko między dwoma różnymi kontekstami, do których należą oba końce importu, i nic nie mówi, gdy któryś koniec nie należy do żadnego kontekstu. INW003 wymaga publicznego celu od każdego importującego spoza kontekstu celu, także od kodu, który nie należy do żadnego kontekstu. Kontekst korzysta tylko ze swoich własnych deklaracji, także wtedy, gdy jego prefiksy leżą wewnątrz innego kontekstu. - JSON Schema dla całej tabeli, w wersji draft-07 dla zgodności ze SchemaStore, publikowany z dokumentacją i dołączany do każdego wydania. Sprawdza strukturę; parser sprawdza dodatkowo relacje między wpisami, których draft-07 nie potrafi wyrazić. Testy utrzymują zgodność obu: klucze, kody reguł i wartości domyślne.
Konsekwencje.
- Jedna definicja przynależności i uprawnień dla INW002 i INW003, ustalona, zanim powstała którakolwiek z reguł, więc nie mogą się rozjechać.
- Konfiguracja bez
contextsdziała dokładnie jak wcześniej, acontexts = []znaczy to samo. - Edytory mogą podpowiadać i sprawdzać
[tool.inwards]na podstawie schematu, a przykłady z samej dokumentacji są względem niego sprawdzane. - Projekt z dwudziestoma wycinkami wymienia dwadzieścia kontekstów, dopóki #191 nie wprowadzi gwiazdek.
-
publicnie wyrazi „tylko te nazwy z modułu”; reeksporty i__all__są poza zakresem. - Dopóki INW002 i INW003 nie trafią do wydania, tabela
contextsjest wczytywana i sprawdzana, ale niczego nie zgłasza.
Alternatywy.
- Kontrakty import-lintera (niezależność, zakazy i warstwy jako osobne typy kontraktów): ekspresyjne, ale każdy kontrakt wymienia swoje moduły od nowa, a relacje między kontraktami nie są sprawdzane. Jedna tabela z regułami przynależności trzyma kontekst każdego modułu w jednym miejscu.
inwards import-config(#55) będzie tłumaczyć kontrakty. - Konteksty wewnątrz
layers(warstwa na kontekst): miesza dwa niezależne wymiary i każe każdemu kontekstowi powtarzać cebulę. - Wygrywa pierwsze dopasowanie, jak przy kształtach: kolejność tabel zmieniałaby wtedy architekturę. Najdłuższe dopasowanie to to, co już robią warstwy.
- Względne wpisy
public(apijakoapidanego kontekstu): krótsze, ale niejednoznaczne przy kilku prefiksach na kontekst i niespójne z każdą inną nazwą modułu w konfiguracji.
ADR-031: Pamięć podręczna ekstrakcji kluczowana treścią, której hooki nigdy nie czytają
Stan: Przyjęty · 2026-09-27 · #56
Kontekst. Pełne sprawdzenie parsuje każdy plik, nawet gdy żaden nie zmienił się od poprzedniego uruchomienia: około 0,9 s dla syntetycznego repozytorium z 2100 plikami, w większości na parsowanie w WASM. To, co wynika z pliku, zależy prawie wyłącznie od jego własnego tekstu. Pamięć podręczna leżałaby jednak w projekcie, do którego może pisać agent pilnowany przez Inwards, a hooki są ścieżką egzekwowania reguł. Podrzucony wpis mówiący, że plik niczego nie importuje, nigdy nie może przepuścić naruszenia przez PostToolUse ani Stop gate.
Decyzja.
- Zapamiętywane są tylko fakty o pojedynczym pliku: szkielet importów z prescanu (albo jego odmowa), statyczne importy z pełnego parsowania i komentarze wyciszające. Importy dynamiczne (INW011) nie są, bo to, czy zaimportowany
evalmoże być wbudowanym, zależy od innych plików. Nie jest też zapamiętywane nic, co silnik wyprowadza z tych faktów: warstwy, ustawienia reguł, baseline, istnienie celu importu (INW010). - Kluczem jest cała tożsamość: znormalizowany tekst, nazwa modułu, to, czy plik jest
__init__pakietu, oraz rewizja ekstrakcji. Rewizję podnosi się za każdym razem, gdy prescan, parser, nazywanie modułów, parsowanie wyciszeń albo rejestr reguł zmieniają to, co wynika z tekstu; test liczy odcisk tych plików i nie przechodzi, dopóki rewizja nie zostanie podniesiona. Nazwa katalogu przestrzeni nazw zawiera też format pamięci podręcznej i hash załadowanych gramatyk. - Silnik przyjmuje opcjonalny port.
Engine.create(wasm, config, { cache })przyjmuje dowolnyExtractionCache; bez niego parsuje jak wcześniej. Silnik nadal nie wykonuje operacji wejścia-wyjścia (ADR-006). inwards checkiinwards baselineużywają.inwards/cache; nic innego go nie czyta. Hooki nie dostają pamięci podręcznej, a serwer języka trzyma własną w pamięci, która nigdy nie dotyka dysku: tylko najnowszy tekst każdego modułu, najwyżej 5000 wpisów i około 32 MB, najpierw usuwane najdawniej używane.--no-cachealboINWARDS_NO_CACHE=1wyłącza pamięć podręczną na dysku.- Odczyt niczemu nie ufa. Wpis jest czytany tylko wtedy, gdy każdy katalog na jego ścieżce jest prawdziwym katalogiem; plik jest otwierany bez podążania za dowiązaniem i bez czekania na FIFO, a czytany tylko wtedy, gdy jest zwykłym plikiem mniejszym niż 256 KB. Jego JSON musi mieć oczekiwany kształt i zapisywać tę samą tożsamość; wszystko inne to chybienie.
- Zapis znosi wyścigi. Każdy wpis trafia do pliku tymczasowego o unikalnej nazwie i jest przemianowywany na miejsce. Dwa uruchomienia mogą nadpisać sobie nawzajem wpisy; żadne nie zobaczy połowy wpisu. Każdy błąd kończy się zwykłym parsowaniem.
- Przycinanie jest ograniczone. Uruchomienie przycina część pamięci podręcznej (jeden z 256 katalogów) przy pierwszym zapisie do niej i ponownie, gdy jego własne zapisy przekroczą w niej 512 KB: pliki tymczasowe starsze niż godzina, wpisy starsze niż 30 dni, a potem najstarsze wpisy, aż część zmieści się w limicie. Najpierw ponownie sprawdza katalogi od projektu w dół i usuwa tylko nazwy, które zapisuje sama pamięć podręczna.
Konsekwencje.
- Ciepłe
inwards checkpomija parsowanie niezmienionych plików: na syntetycznym repozytorium 3,0 raza szybciej (0,46 s wobec 1,25 s, p50). Benchmark podaje osobno uruchomienia bez pamięci podręcznej, z pustą i z ciepłą. - Nic w
.inwards/cachenie może zmienić wyników hooków, co sprawdza test z podrzuconym wpisem. -
inwards checkz pamięcią podręczną jej ufa. Każdy, kto może pisać do projektu, może sprawić, że przeoczy ono naruszenie. CI, które odtwarza pamięć podręczną z niezaufanej gałęzi, powinno używać--no-cache, jak mówi przewodnik po GitHub Actions. - Katalogi są sprawdzane po ścieżce, a nie trzymane otwarte: Node nie ma
openataniunlinkat. Pamięć podręczna zakłada, że ten, kto może pisać do projektu, działa też jako użytkownik, tak jak agent z dostępem do powłoki; proces, który może tylko pisać pliki i ściga się z uruchomieniem, podmieniając katalog na dowiązanie między sprawdzeniem a zapisem albo przycinaniem, może skierować tę jedną operację gdzie indziej. Każda publikacja i każde przycinanie najpierw sprawdza cały łańcuch katalogów i przestaje używać części, która się zmieniła, a przycinanie usuwa tylko nazwy, które zapisuje sama pamięć podręczna. - Rewizję trzeba podnosić ręcznie; test odcisku zauważa tylko, że pliki się zmieniły.
- Pusta pamięć podręczna płaci za zapis każdego pliku: uruchomienie, które ją wypełnia, było na syntetycznym repozytorium o 27% wolniejsze. Benchmark podaje ten koszt, ale go nie bramkuje, bo zależy bardziej od systemu plików runnera niż od kodu.
Alternatywy.
- Klucz ze ścieżki i czasu modyfikacji: tańszy do sprawdzenia, ale checkout albo
touchpsują go w obie strony i nie da się go współdzielić między klonami. - Jeden plik pamięci podręcznej na projekt: mniej plików, ale każde uruchomienie przepisuje całość, a równoległe uruchomienia potrzebują blokady.
- Pamięć podręczna także dla hooków, z HMAC-iem kluczowanym poza projektem: klucz musiałby leżeć tam, gdzie agent nie może go przeczytać, a hooki sprawdzają jeden plik, w którym parsowanie nie jest kosztem (rozdział 6).
- Zapamiętywanie całych wyników: zależą od konfiguracji, baseline'u i innych plików; poprawne unieważnianie ich to właśnie ten trudny problem, którego ten projekt unika.
ADR-032: Cykle importów przy sprawdzaniu całego projektu, z importów, które sprawdzenie i tak czyta
Stan: Przyjęty · 2026-09-27 · #54
Kontekst. Cykl między modułami albo między kontekstami ograniczonymi to problem architektury, którego nie widać w żadnym pojedynczym imporcie: każdy krok z osobna może być dozwolony. ADR-030 zostawił cykle między kontekstami dla INW004. Znalezienie cyklu wymaga importów wszystkich modułów, a hooki sprawdzają jeden plik w budżecie 100 ms. Zgłoszenie wymagało, żeby zimne uruchomienie na syntetycznym repozytorium, łącznie z szukaniem cykli, zmieściło się w 1 s.
Decyzja.
- Tylko przy sprawdzaniu całego projektu. INW004 działa, gdy sprawdzenie obejmuje cały projekt:
inwards checkbez ścieżek,inwards baseline, bramka Stop zstop-gate = "project". Hook po każdej edycji i serwer języka nigdy go nie zgłaszają. - Z importów, które sprawdzenie i tak czyta. Silnik zachowuje importy każdego sprawdzonego pliku, gdy je skanuje i potwierdza: ze szkieletu albo z pełnego parsowania razem z czytelnymi importami dynamicznymi. Żaden plik nie jest czytany dwa razy, a pamięć podręczna ekstrakcji (ADR-031) działa. Liczy się każdy import, także w funkcjach i za
TYPE_CHECKING, tak jak w innych regułach. - Węzłami są sprawdzone moduły. Import to krawędź do najdłuższego sprawdzonego modułu, od którego zaczyna się jego cel. Nic innego, ani biblioteka standardowa, ani pakiet spoza sprawdzenia, nie może zamknąć cyklu i nie daje krawędzi; rozwiązanie celów nie potrzebuje systemu plików.
- Jedno zgłoszenie na silnie spójną grupę. Grupy znajduje algorytm Tarjana w wersji iteracyjnej; każda dostaje najkrótszy cykl przez swój pierwszy moduł, z pełną ścieżką, przy imporcie, który robi pierwszy krok. Węzły i krawędzie są odwiedzane w posortowanej kolejności, więc zgłoszenie jest za każdym razem takie samo. Komunikat podaje też rozmiar grupy w elementach i powiązaniach oraz skrót jej powiązań, więc baseline przestaje pasować, gdy grupa zmieni się w jakikolwiek sposób. Dotyczy to także grupy, która straciła powiązanie: projekt uruchamia wtedy
inwards baselineponownie, żeby ją przyjąć. - Każdy plik w cyklicznej grupie jest potwierdzany. Szkielet może odczytać import, którego nie ma: linię wewnątrz wieloliniowego napisu albo f-stringa, albo linię, której parser, wychodząc z błędu składni, nie czyta jako importu. Jedna taka krawędź może połączyć dwie grupy w jedną. Dlatego każdy plik z krawędzią wewnątrz cyklicznej grupy, który przeczytał tylko szkielet, jest potwierdzany, a wyszukiwanie rusza od nowa, aż każda grupa opiera się na potwierdzonych importach. Potwierdzanie pozostaje tanie. Plik, który do ostatniego importu ma wyłącznie importy najwyższego poziomu, komentarze i puste linie, nie wymaga parsowania: jego szkielet to ten sam tekst, który sparsował się do samych importów. Każdy inny plik jest parsowany do końca swojego ostatniego importu. Gdy ten tekst parsuje się bez błędu, cięcie leży poza każdym napisem, nawiasem i kontynuacją, więc zawiera te same importy co cały plik (szkielet nigdy nie pomija importu, więc dalej żadnego nie ma); w przeciwnym razie parsowany jest cały plik.
cycleswybiera rodzaje, domyślnie["contexts"]: cykle między kontekstami to pytanie architektoniczne, dla którego konteksty istnieją, a cykle modułów przy aktualizacji wywróciłyby wiele istniejących projektów."modules"je dodaje;[]wyłącza regułę.- Nie da się go wyciszyć w linii. Sprawdzenie jednego pliku nie wie, czy wyciszony cykl nadal istnieje, a komentarz siedziałby przy jednym imporcie z wielu. Cykle, które projekt już ma, przyjmuje baseline.
Konsekwencje.
- Na syntetycznym repozytorium (2100 plików), gdzie losowe importy generatora wkładają większość modułów każdej warstwy do jednej cyklicznej grupy, szukanie cykli razem z potwierdzaniem dało zimne sprawdzenie całego projektu 1,51 s wobec 1,35 s bez niego (mediany 8 naprzemiennych uruchomień z
INWARDS_NO_CACHE=1, średnie obciążenie około 1,1). Pełne parsowanie każdego pliku w grupie trwało zamiast tego około 7 s. Szukanie znalazło cztery cykle. Zimne sprawdzenie przekracza na tej maszynie budżet 1 s z szukaniem i bez niego. - Cykl między kontekstami jest wykrywany nawet wtedy, gdy
depends-onpozwala na oba kierunki. - Projekt zakładany przez
inwards init --stylenie ma cykli, na których mógłby się wyłożyć, więc każdy preset zapisujecycles = ["modules", "contexts"](#340). - Edytor i hook po edycji nie pokazują cykli; bramka Stop pokazuje je tylko w trybie projektu.
- Import podmodułu uruchamia też
__init__jego pakietu; ten niejawny krok nie jest krawędzią, więc cykl, który zamyka się tylko przez__init__, nie jest wykrywany. - Bez kontekstów pliki poza wszystkimi warstwami nie są parsowane, więc cykle przez nie nie są widoczne.
- Plik z błędem składni za ostatnim importem liczy się z importami zapisanymi nad błędem; Python w ogóle by go nie zaimportował.
Alternatywy.
- Osobne przejście po grafie, które czyta każdy plik: prostsze do napisania, ale podwaja czytanie i parsowanie, które sprawdzenie już wykonuje.
- Rozwiązywanie krawędzi przez
ownerOf: dokładnie jak w Pythonie, ale sprawdza system plików dla każdego importu, 55 ms pierwszego pomiaru, a moduł spoza sprawdzenia i tak nie może leżeć na zgłaszanym cyklu. - Skaner tokenów, który rozstrzyga, kiedy można ufać szkieletowi: pierwsza wersja tej reguły go miała. Review znalazło poprawny kod, który źle odczytywał (f-string zagnieżdżony w f-stringu, dozwolony od Pythona 3.12), i błędy składni, za którymi nie nadążał; tokenizera Pythona i odtwarzania po błędach w parserze nie da się wiernie odwzorować skanerem.
- Pełne parsowanie każdego pliku w cyklicznej grupie: poprawne, ale na zimno około 7 s na syntetycznym repozytorium.
- Zgłaszanie każdego cyklu elementarnego: ich liczba eksploduje wraz z rozmiarem grupy; jeden najkrótszy cykl na grupę wystarcza do działania, a następne uruchomienie pokaże kolejny.
- Cykle modułów domyślnie włączone: ustawienie bardziej rygorystyczne, ale aktualizacja, która wywraca większość kodu, uczy ludzi wyłączać regułę.
Poprawka · 2026-10-11 · #375. Import w treści if TYPE_CHECKING: albo elif TYPE_CHECKING: (typing.TYPE_CHECKING albo dowolny atrybut, który się na nim kończy) nie daje już krawędzi, ani dla cykli modułów, ani kontekstów. TYPE_CHECKING ma w czasie działania wartość False, więc taki import nigdy się nie wykonuje, a to standardowy sposób na zachowanie podpowiedzi typu bez cyklu w czasie działania. examples/clean-app pokazał koszt liczenia go: shop.domain.ports importuje z powrotem shop.domain.order dla podpowiedzi, a każdy preset inwards init włącza cykle modułów (#340), więc rada brzmiała: usuń poprawną adnotację. INW015 już zwalniał takie importy (#313), a teraz obie reguły czytają jeden znacznik: pełne parsowanie ustawia typeChecking na takim imporcie (python/type-checking.ts), a EXTRACTION_REVISION zmienił się, żeby żadna pamięć podręczna nie podała importów bez niego. Gałąź else się wykonuje, więc jej importy się liczą, podobnie jak importy pod if not TYPE_CHECKING: albo pod warunkiem złożonym. Szkielet nie widzi linii z if, więc jego importy nie mają znacznika; krawędź ze szkieletu spod TYPE_CHECKING, która trafia do cyklicznej grupy, znika, gdy opisane wyżej potwierdzanie sparsuje plik, a plik, który zaczyna się od samych importów najwyższego poziomu, takiej krawędzi mieć nie może. INW001, INW002, INW003 i INW005 nadal liczą importy tylko dla typów: podpowiedź przez granicę warstwy albo kontekstu to nadal zależność w projekcie.
-
examples/clean-appprzechodzi sprawdzenie zcycles = ["modules", "contexts"]. - Inwards patrzy na nazwę w warunku:
if TC:pofrom typing import TYPE_CHECKING as TCsię liczy, a projekt, który sam ustawiaTYPE_CHECKING = True, ukryłby prawdziwy cykl. - Odrzucone: ustawienie, które przywraca importy tylko dla typów. Cykl, za którym idzie tylko narzędzie do sprawdzania typów, nigdy nie wywraca się przy imporcie, i nikt o nie nie prosił; można je dodać później, nikomu niczego nie psując.
ADR-033: OpenCode przez plugin, który uruchamia hook Claude Code
Stan: Przyjęty · 2026-09-27 · #170
Kontekst. Ewaluacje agentów (#48) działają na OpenCode, a Inwards może mierzyć tylko agenta, do którego jest podłączony. OpenCode nie ma ustawień hooków takich jak Claude Code. Ładuje pluginy JavaScript z .opencode/plugins/, a plugin dostaje zdarzenia i wywołania narzędzi: tool.execute.before może rzucić wyjątek, żeby zablokować wywołanie, tool.execute.after może zmienić wynik narzędzia, a zdarzenie session.idle przychodzi po zakończeniu tury. Reguły, zapis sesji, strażnik konfiguracji i bramka Stop już istnieją jako inwards hook claude-code. Projekt i jego gwarancje opierają się na OpenCode 1.18.31.
Decyzja.
- Plugin, który tłumaczy, i jedna implementacja hooka.
inwards init --agent opencodezapisuje.opencode/plugins/inwards.js, zwykły JavaScript bez kroku budowania i bez zależności. Plugin zamienia zdarzenia OpenCode na ładunki, które wysyła Claude Code, i uruchamia z nimiinwards hook claude-code:session.createdstaje się SessionStart,tool.execute.beforedlaedit,writeibashstaje się PreToolUse (z przemianowanymifilePath,oldStringi resztą),tool.execute.afterdlaedit,writeiapply_patchstaje się PostToolUse, asession.idlestaje się Stop. Na razie nie mainwards hook opencode; nagrane ładunki pozostają jedynym kontraktem. - Tak jak plik ustawień Claude Code, plugin zawiera ścieżkę do pliku binarnego na tej maszynie. Uruchamia Inwards bez powłoki, pod bezwzględną ścieżką znalezioną przez
init, ainitdodaje go do.gitignore. Pierwsza linia oznacza plik jako zapisany przezinit, który odmawia zastąpienia pliku bez niej, katalogu albo dowiązania. Hook działa w projekcie, w którym leży plik, a nie w katalogu, z którego uruchomiono OpenCode, bo OpenCode ładuje też pluginy katalogów nadrzędnych. - Blokada to rzucony błąd; wszystko inne, co mówi hook, dołącza do wyniku narzędzia albo do sesji. Odmowa z PreToolUse staje się
Errorz powodem strażnika, który OpenCode pokazuje modelowi zamiast uruchomić narzędzie. Znalezisko, ostrzeżenie albo prośba eskalacji z PostToolUse jest dopisywane do wyniku narzędzia, który model czyta przed następnym krokiem. To, co Claude Code pokazuje użytkownikowi albo dodaje na starcie sesji (końcowe podsumowanie bramki Stop, problemy pozostawione przez wcześniejsze sesje), trafia do sesji jako wiadomość od pluginu, która nie zaczyna tury (noReply). - Bramka Stop zaczyna kolejną turę. Gdy bramka blokuje przy
session.idle, plugin wysyła jej powody do sesji przezclient.session.promptAsync, z nagłówkiem „Inwards Stop gate (sent by the Inwards plugin, not the user)”. Wiadomość idzie jako agent, model i wariant, które użytkownik ostatnio wybrał. Bez nagłówka model wziął raport za użytkownika, który powtarza prośbę. Plugin trzymastop_hook_activedla każdej sesji i czyści je, gdy użytkownik wyśle wiadomość, więcescalate-afterdziała tak jak w Claude Code. OpenCode nie czeka na jedno zdarzenie przed następnym, więc bramka działa po kolei w każdej sesji, a wynik jest odrzucany, gdy użytkownik wysłał wiadomość po bezczynności, na którą odpowiada, gdy trwa tura albo gdy ostatnia wiadomość bramki jeszcze nie dotarła. Bramka działa tylko przy bezczynności kończącej turę rozpoczętą wiadomością (użytkownika albo jej własną, widzianą przezchat.message): polecenie powłoki, ręczna kompakcja ani przerwanie (MessageAbortedError) nikogo nie odsyłają. Odrzucona wiadomość jest wysyłana do trzech razy; taka, której nadal nie da się wysłać albo której żądanie się urwało, wychodzi przy następnej bezczynności, chyba że dotarła albo użytkownik napisał pierwszy. Polecenie powłoki, które zaczyna się i kończy w trakcie działania bramki, unieważnia jej wynik, a bezczynność po nim sprawdza ponownie. - Czego strażnik nie przeczyta, tego plugin odmawia. Strażnik konfiguracji ocenia edycję po starym i nowym tekście, a
apply_patchnie ma żadnego z nich. Dlatego plugin odmawia łatki, która dotykapyproject.toml,.opencode/,opencode.json(c),.inwards/alboinwards-baseline.json, orazeditalbowriteczterech ostatnich, które w Claude Code obejmujepermissions.deny. Nagłówki łatek są czytane tak łagodnie, jak czyta je OpenCode, a ścieżki są porównywane w zapisanej postaci i po rozwiązaniu dowiązań. Gdy hook nie może się uruchomić, wywołanie dotykające tych plików albopyproject.tomljest odrzucane, a nie przepuszczane bez sprawdzenia, a uruchomienie hooka jest przerywane po 60 sekundach, domyślnym limicie czasu hooka w Claude Code. Dwa argumenty OpenCode, których strażnik nigdy nie widzi, sprawdza plugin:bashnie może działać w katalogu Inwards (swoimworkdir, a bez niego w katalogu OpenCode), aeditplikupyproject.toml, któregooldStringnie pasuje dokładnie jeden raz (co najmniej raz zreplaceAll), jest odrzucany, bo OpenCode sięga wtedy po luźniejsze dopasowania, za którymi symulacja strażnika nie nadąży. - Subagenty dzielą sesję najwyższego poziomu, tak jak w Claude Code: wywołania sesji podrzędnej używają identyfikatora sesji jej korzenia, a bramka Stop działa tylko dla sesji najwyższego poziomu. Sesja, której utworzenia plugin nie widział (subagent wznowiony po restarcie), jest wyszukiwana przez SDK, najwyżej trzy razy; dopóki wyszukiwanie zawodzi, jej wywołania są sprawdzane pod jej własnym identyfikatorem, a bramka Stop dla niej nie działa.
- Bramka Stop sprawdza plik pluginu, a nie ustawienia Claude Code, gdy
INWARDS_HOOK_HOST=opencodemówi, kto wywołuje. Plugin liczy skrót własnego pliku, gdy OpenCode go ładuje, i przekazuje go dalej; bramka blokuje, gdy pliku na dysku nie ma albo się różni, więc plugin opróżniony w trakcie sesji, z zachowanym znacznikiem, zostaje zgłoszony, zanim następny start niczego nie uruchomi.
Konsekwencje.
- Reguły, strażnik, bramka Stop i eskalacja mają jedną implementację, a ich zmiana trafia do OpenCode bez zmiany pluginu.
- Test end-to-end uruchamia
opencode runz prawdziwym modelem, gdy jest skonfigurowany: agent zapisuje import na zewnątrz, czyta INW001 w wyniku narzędzia i go poprawia. - OpenCode nie może odmówić zakończenia tury. Powody bramki przychodzą jako nowa wiadomość po zakończeniu tury, a
opencode runw tym momencie kończy działanie, więc nieinteraktywne uruchomienie nie dostaje drugiej tury; sprawdzenie po edycji i tak dociera do agenta. Przewodnik wymienia każdą różnicę. - Plugin nie może zablokować wiadomości wysłanej przez użytkownika, a nowa wiadomość zeruje licznik
escalate-after, tak jak nowa tura w Claude Code. - Polecenie Bash nadal może usunąć albo przepisać plugin. Bramka Stop działającej sesji to zauważy, ale przy następnym starcie OpenCode nie ładuje niczego, co mogłoby to zauważyć, jak po usunięciu pliku ustawień Claude Code.
- Ponowne uruchomienie
initw trakcie sesji z innym Inwards (po aktualizacji albo przeniesieniu pliku binarnego) zapisuje inne bajty, więc bramka prosi o restart OpenCode, zanim tura może się skończyć; ponowne uruchomienie, które niczego nie zmienia, tego nie robi.
Alternatywy.
- Punkt wejścia
inwards hook opencode, który czyta kształty OpenCode: tłumaczenie przeszłoby do przetestowanego CLI, ale dodałoby drugi kontrakt ładunków dla API pluginów, które wciąż się zmienia. Tłumaczenie jest małe; może się przenieść później. - Plugin, który implementuje sprawdzenia na nowo w JavaScripcie: bez procesu na każde zdarzenie, ale z dwiema implementacjami każdej reguły i strażnika.
- Blokowanie końca tury przez
chat.messagealbo uprawnienia: żadne z nich nie działa przy końcu tury;session.idleto jedyny punkt, a przychodzi po turze.
ADR-034: Selektory warstw zakotwiczone w pakiecie najwyższego poziomu, ze sprawdzaniem wycinków w sesji
Stan: Przyjęty · 2026-09-28 · #191
Kontekst. Pionowe wycinki powtarzają te same warstwy w każdym wycinku: shop.orders.domain, shop.billing.domain i tak dalej. Wymienienie pakietu każdego wycinka w każdej warstwie działa, ale jest długie, a nowy wycinek, którego nikt nie dopisze do konfiguracji, po prostu nie jest sprawdzany. Kształty już przyjmują selektory w gramatyce z ADR-018. Warstwy są trudniejsze: przynależność decyduje o każdej regule, INW006 rozumuje o pakietach nad warstwami, Stop gate porównuje sesje po prefiksach, a trzy przejścia po katalogach (CLI, manifestu sesji i serwera języka) decydują, jaki kod w ogóle istnieje.
Decyzja.
- Rozpoznawanie i zgodność. Wpis z
*w dowolnym miejscu to selektor i jest sprawdzany ściśle: jego segmenty to*(jeden segment),**(jeden lub więcej) albo identyfikatory. Częściowe gwiazdki,?, nawiasy kwadratowe, puste segmenty i separatory ścieżek to błędy konfiguracji. Każdy wpis bez*to dosłowny prefiks z tak łagodnym sprawdzaniem jak dotąd, łącznie ze starymi niepoprawnymi nazwami, a pusta listamodulespozostaje dozwolona. - Selektor zaczyna się od dosłownego pakietu najwyższego poziomu (
shop.*.domain, nie*.domain). Ten pakiet kotwiczy przejścia po katalogach, które otwierają go w całości, tak jak już otwierają pakiet najwyższego poziomu dosłownego prefiksu, oraz szukanie dowodu przez INW006. Selektor bez dosłownego pierwszego segmentu to błąd konfiguracji; projekt z kilkoma pakietami najwyższego poziomu wymienia jeden selektor na pakiet. - Dopasowanie. Selektor obejmuje każdy moduł równy jednemu z jego pełnych dopasowań oraz ich potomków. Dopasowanie to programowanie dynamiczne po segmentach, O(selektor × moduł) na wywołanie, a nie rekurencyjne dopasowanie kształtów, bo działa dla każdego importu. Kształty zachowują własne dopasowanie i pierwszeństwo pierwszego pasującego wpisu.
- Pierwszeństwo, w tej kolejności: najgłębszy ostatni dosłowny segment dopasowania, potem głębsze dopasowanie, potem więcej dosłownych segmentów, potem wcześniejsza warstwa. Pierwsze kryterium pozwala dosłownemu poddrzewu (
shop.orders.domain) wygrać z szerokimshop.**, który pasuje głębiej. Dla samych dosłownych wpisów ta kolejność sprowadza się do najdłuższego prefiksu, więc istniejące konfiguracje zachowują właścicieli. Dokumentacja konfiguracji ma tabelę prawdy. - Kroki naprawy nazywają dopasowany prefiks importującego modułu, nigdy surowy selektor ani inny wycinek, i podpowiadają
<prefiks>.portstylko wtedy, gdy ten prefiks jest pakietem. Przy kilku dosłownych prefiksach w warstwie treść zmienia się celowo: naprawa nazywała dotąd pierwszy prefiks warstwy. - INW006 potrzebuje dowodu dla selektorów. Pakiet zawiera warstwę selektora tylko wtedy, gdy projekt ma pod nim moduł, do którego selektor pasuje. Indeks modułów odpowiada na to, listując tylko katalogi, na które selektor pozwala, nigdy całe drzewo, i zapamiętuje odpowiedź. Dosłowne wpisy zachowują regułę tekstową. Importy prawdziwego pakietu-kontenera pozostają błędami.
- Sesje sprawdzają wycinki. Selektor jest martwy, gdy nie pasuje do żadnego modułu, niezależnie od pierwszeństwa. W sesji jest też sprawdzany wycinek po wycinku, gdzie wycinek to prefiks dopasowanego modułu aż do ostatniego dosłownego segmentu selektora:
shop.orders.domaindlashop.*.domain,shop.orders.infradlashop.*.infra.*,shopdlashop.**. Wycinek, który na starcie sesji miał moduły, a teraz nie ma żadnego, to błąd, jak dosłowny prefiks, który przestał pasować. Przeniesienia kodu warstwy poza wszystkie warstwy są wykrywane moduł po module, jak dotąd. Diagnostyki konfiguracji wskazują tekst selektora. - Zmiana nazwy albo usunięcie wycinka wymaga użytkownika, tak jak przy dosłownych prefiksach:
git mv shop/orders shop/sales, przeniesienie wycinka głębiej podshop.**.domaini usunięcie wycinka, którego jedynym modułem jest__init__.py, zatrzymują Stop gate. - Jedna funkcja pomocnicza nazywa pakiety do przejścia.
layerPackagespodaje pakiet najwyższego poziomu każdego wpisu; przejście CLI, manifest sesji oraz listowanie i filtr zdarzeń plików serwera języka otwierają te katalogi, więc edytor indeksuje te same moduły co CLI. Przeładowanie konfiguracji buduje to wszystko od nowa.
Konsekwencje.
- Jeden wpis na warstwę obejmuje każdy wycinek, a nowy wycinek jest sprawdzany od chwili, gdy powstanie.
- Istniejące konfiguracje zachowują właścicieli i komunikaty, poza treścią naprawy dla warstw z kilkoma dosłownymi prefiksami.
- Serwer języka nie pomija już katalogów
node_modulesani środowisk wirtualnych wewnątrz pakietu warstwy, co zamyka lukę względem CLI starszą niż selektory. - Wycinki nie mogą pojawiać się i znikać w trakcie sesji bez użytkownika. Nazywanie wycinków do ostatniego dosłownego segmentu sprawia, że zwykłe edycje (usunięcie albo zmiana nazwy modułu w wycinku, który zachowuje inne) nie blokują, ale opróżnienie wycinka blokuje nawet przy zamierzonym usunięciu: przeniesienie do katalogu, który przejście pomija, wygląda dokładnie tak samo.
- Selektor nie może zaczynać się od gwiazdki, więc projekt z kilkoma pakietami najwyższego poziomu pisze jeden selektor na pakiet.
- Szukanie dowodu nie wchodzi w katalogi będące dowiązaniami symbolicznymi. Wycinek osiągalny tylko przez dowiązanie nie czyni swojego rodzica kontenerem, więc INW006 zgłasza tam więcej, nigdy mniej.
- Konteksty (ADR-030) nadal przyjmują tylko dosłowne prefiksy.
Alternatywy.
- Ranking tylko po głębokości dopasowania: prosty, ale
shop.**odebrałbyshop.orders.domain.orderwarstwie z dosłownymshop.orders.domain, a tego użytkownik nigdy nie ma na myśli. - Wygrywa pierwszy pasujący wpis, jak w kształtach: kolejność warstw decydowałaby wtedy o przynależności, a nie tylko o kierunku.
- Nazywanie wycinka pełnym dopasowanym prefiksem: pod
shop.**każdy plik staje się osobnym wycinkiem, a usunięcie albo zmiana nazwy dowolnego modułu zatrzymuje Stop gate. - Dopuszczenie usunięcia wycinka i traktowanie jako błędu tylko przeniesień: manifest nie odróżni usunięcia od przeniesienia do
node_modulesalbo środowiska wirtualnego w katalogu głównym, które przejścia pomijają. - Gwiazdki na początku (
*.domain) z przejściem całego drzewa: przejścia musiałyby dla bezpieczeństwa otwierać każdy katalog najwyższego poziomu, łącznie ze środowiskami wirtualnymi.
ADR-035: inwards check idzie za członkami workspace'u uv, każdy z własną konfiguracją
Stan: Przyjęty · 2026-09-28 · #57
Kontekst. Konfiguracja ma jeden root, a nazwy modułów to ścieżki poniżej niego. Workspace uv trzyma pakiet każdego członka w jego własnym src/ (qv-lite: 7 członków, src/packages/core/src/qv_core), więc konfiguracja w katalogu głównym workspace'u nazywa pakiet packages.core.src.qv_core, podczas gdy inni członkowie importują qv_core, i te importy przechodzą jako importy bibliotek zewnętrznych (#201). Działało jedno [tool.inwards] na członka i pętla w powłoce z inwards check --config <member>/pyproject.toml. Hooki już wybierają najbliższą konfigurację dla każdego pliku i zapisują każdą konfigurację na starcie sesji. ADR-018 postanowił, że monorepo idzie za workspace'ami uv. Członkowie współdzielą też niejawne pakiety przestrzeni nazw (acme.core w jednym członku, acme.api w innym), które Python scala z obu.
Decyzja.
- Członkowie pochodzą z uv, konfiguracje zostają przy członkach.
inwards checkbez--configczyta[tool.uv.workspace](membersminusexclude,*wewnątrz segmentu) z najbliższego katalogu głównego workspace'u w katalogu roboczym lub nad nim. Uruchomiony tam, gdzie poniżej leżą członkowie z[tool.inwards], sprawdza każdego z nich jego własną konfiguracją i baseline'em; najbliższa konfiguracja w katalogu głównym workspace'u lub poniżej sprawdza resztę z pominięciem katalogów tych członków, a członek zagnieżdżony w innym zostaje swojej własnej konfiguracji. Członek bez[tool.inwards]trafia na listę niesprawdzonych, chyba że sprawdza go konfiguracja katalogu głównego. Nie ma nowego klucza konfiguracji ani flagi--workspace. - Wskazane ścieżki trafiają do najbliższej konfiguracji. Każda ścieżka jest sprawdzana najbliższą konfiguracją nad nią, a katalog zawierający członków z konfiguracją także ich konfiguracjami. Workspace jest szukany od każdej ścieżki, a nie od katalogu roboczego, więc plan nie zależy od miejsca uruchomienia.
--configznaczy to, co dotąd: jedna konfiguracja dla wszystkiego. - Jeden raport. Raporty łączą się w jeden: jeden dokument JSON albo SARIF, ścieżki względne wobec katalogu roboczego, liczniki zsumowane. Wyjście text i concise kończy się wierszem na każdą konfigurację. Kod wyjścia to najgorszy z kodów; niepoprawna konfiguracja członka daje kod 2, a pozostali członkowie są nadal sprawdzani. "Nic nie sprawdzono" (#200) jest oceniane raz, na połączonym raporcie. Z
--logkażda konfiguracja zapisuje własny wiersz, tylko z własnymi znaleziskami i czasem. - Pakiety przestrzeni nazw zaglądają do innych członków. Importy względne już wcześniej były rozwiązywane po nazwie tak jak w Pythonie. Błędne było istnienie: INW010 zgłaszał moduł, którego brakuje w tym członku, a który ma część pakietu przestrzeni nazw u innego członka. CLI daje teraz silnikowi przez
ProjectFilessondęportionskatalogów importu pozostałych członków (src/, a bez niego katalog członka), a INW010 przepuszcza brakujący moduł, gdy jego pakiet jest tu pakietem przestrzeni nazw od pakietu najwyższego poziomu w dół i ma go któraś z części. - Hooki zachowują to, co miały, z jednym dodatkiem: strażnik konfiguracji chroni
[tool.inwards]i baseline członka także wtedy, gdy nie istnieje jeszcze ani stan sesji, ani konfiguracja w katalogu głównym.
Konsekwencje.
- Pętla z qv-lite staje się jednym
inwards checkw katalogu głównym workspace'u, a lista członków zostaje w jednym miejscu, które czyta uv. - Konfiguracja w katalogu głównym i konfiguracje członków mogą współistnieć bez sprawdzania pliku dwa razy, a ostrzeżenie z #201 nadal pojawia się dla członka bez własnej konfiguracji.
- Wykrywane są tylko workspace'y uv. Monorepo bez
[tool.uv.workspace]nadal potrzebuje wskazanych ścieżek albo osobnego uruchomienia na konfigurację. -
inwards baselinenadal bierze jedną konfigurację na uruchomienie, a serwer języka nadal czyta jedną konfigurację (jego ograniczenie do pierwszego folderu obszaru roboczego jest śledzone osobno) i nie szuka części pakietów przestrzeni nazw u innych członków. - Katalog importu członka jest zgadywany (
src/, a bez niego katalog członka), a nie czytany z jegoroot, a część pakietu spoza workspace'u (zainstalowana dystrybucja) jest nadal zgłaszana (#161).
Alternatywy.
- Kilka katalogów głównych w jednej konfiguracji (
roots = [...]): jedna mapa warstw dla wszystkich członków, ale lista członków powtarzałaby to, co uv już ma, a warstwy zwykle różnią się między członkami. - Przeszukiwanie drzewa w poszukiwaniu każdego zagnieżdżonego
pyproject.tomlz[tool.inwards]: obejmuje monorepo bez uv, ale kosztuje przejście drzewa przy każdym uruchomieniu i nie wie, które katalogi należą do siebie. - Flaga
--workspace: jawna, ale uruchomienie w katalogu głównym workspace'u już to mówi, a dawne zachowanie w tym miejscu (jedna konfiguracja indeksująca członków po ścieżce) było fałszywą zielenią, przed którą ostrzega #201. - Pomijanie INW010 pod każdym pakietem przestrzeni nazw: prostsze, ale zmyślony moduł w pakiecie przestrzeni nazw przechodziłby po cichu w każdym projekcie bez
__init__.py.
ADR-036: Szablony pakietów rozwijają się w konfigurację, którą użytkownik mógłby napisać ręcznie
Stan: Przyjęty · 2026-09-28 · #97
Kontekst. fastapi-best-practices daje każdej domenie te same moduły, tę samą kolejność importów między nimi (router, potem dependencies, potem service, potem models i schemas, potem constants) i te same nieliczne moduły, z których mogą korzystać inne domeny. Kształty (ADR-018), selektory warstw (ADR-034) i konteksty (ADR-030) mogły powiedzieć każdy swoją część, ale tylko powtarzając listę modułów w trzech tabelach. Zgłoszenie prosiło też o niezależne warstwy sąsiednie (models | schemas), których kolejność warstw nie umiała wyrazić: warstwa zawsze mogła importować każdą warstwę wymienioną przed nią, więc jedna z dwóch sąsiednich mogła importować drugą.
Decyzja.
- Szablon to nazwana tabela,
[tool.inwards.templates.<nazwa>], zroles(od najbardziej wewnętrznej,a | bdla warstw sąsiednich),public, kluczami kształtuallow,require,forbidiextraorazhints.template = "<nazwa>"działa we wpisie warstwy (role stają się warstwami wewnątrz modułów wpisu), we wpisie kształtu (szablon dostarcza klucze elementów, a klucz ustawiony przez wpis wygrywa) i w kontekście (nazwypublicszablonu, pod każdym z modułów kontekstu, dołączają do jegopublic). - Szablony rozwijają się w konfigurację, którą użytkownik mógłby napisać ręcznie, raz, w parserze. Wczytana konfiguracja nie ma po nich śladu, więc żadna reguła, baseline, opis architektury ani edytor nie muszą wiedzieć, że szablony istnieją, a szablon zawsze można zastąpić jego rozwinięciem. Każdy klucz szablonu ma więc ręczną postać, dlatego poza szablonami doszły dwa klucze:
hintswe wpisach kształtu i warstwy sąsiednie jako zagnieżdżona tablica wlayers. - Warstwy sąsiednie to miejsce w kolejności. Warstwa ma miejsce (rank), gdy konfiguracja ma warstwy sąsiednie; warstwy z tego samego miejsca nie mogą importować jedna drugiej, a warstwa może importować każdą warstwę z niższego miejsca. INW001 i INW011 traktują import warstwy sąsiedniej jak import na zewnątrz i mówią
from sibling layer; dozwolony kierunek łączy warstwy sąsiednie znakiem|; INW005 daje domyślną listę zakazów każdej warstwie z najniższego miejsca. Konfiguracja bez warstw sąsiednich nie dostaje miejsc, więc jej wczytana postać i każdy komunikat zostają bez zmian. - Warstwy ról nazywają się
<wpis>.<rola>i obejmują<moduł>.<rola>dla każdego z modułów wpisu, z listami bibliotek wpisu. Sam wpis nie staje się warstwą: moduł w nim, którego nie obejmuje żadna rola, leży poza wszystkimi warstwami, co zgłasza INW006. - Błędy nazywają to, co napisał użytkownik: klucz
templatewpisu dla nieznanego szablonu albo takiego, któremu brakuje ról lubpublicpotrzebnych w danym miejscu, oraz własny klucz szablonu dla błędnej roli, wzorca albo wskazówki. Problem, który widać dopiero po rozwinięciu (zajęta już nazwa albo prefiks warstwy roli), nazywa rozwiniętą warstwę. - Uzupełnione w #298:
rulesszablonu włączają reguły opt-in dla roli i rozwijają się do[tool.inwards.rules]jak wszystko inne: kod dołącza doextend-select, moduły roli domodulesreguły (przy INW015 dorole, czyli chronionych modułów), a opcje i poziom do tabeli reguły. Własne opcje i poziom tabeli najwyższego poziomu wygrywają, tak jak własny klucz wpisu wygrywa z kluczem jego szablonu; dwie role, które się nie zgadzają, to błąd konfiguracji, bo reguła ma jedną wartość na opcję. Reguł domyślnie włączonych nie można wskazać: i tak zgłaszają wszędzie, a szablon mógłby je tylko zawęzić.
Konsekwencje.
- Układ fastapi-best-practices to jeden szablon i trzy krótkie jego użycia, a nowa domena jest objęta od chwili, gdy powstanie. Fixture testowy zawiera szablon i jego ręczny odpowiednik, a oba dają te same diagnostyki.
- Warstwy sąsiednie działają też bez szablonów, czego potrzebowało
a | bz import-linter;inwards import-confignadal odwzorowuje|na jedną warstwę i konteksty, a mógłby przejść na zagnieżdżone tablice. - Komunikaty i opis architektury nazywają warstwy ról po rozwinięciu,
domain.service, a dozwolony kierunek dużego szablonu jest długi. - Rola, której nie ma żaden pakiet, tworzy pustą warstwę, którą INW006 zgłasza jako błąd, więc opcjonalne elementy należą do
allow, nie doroles. - Diagnostyki konfiguracji dla rozwiniętych selektorów, na przykład martwej warstwy roli, wskazują linię 1 pliku
pyproject.toml: rozwiniętego tekstu nie ma w pliku. - Konteksty nadal przyjmują dosłowne prefiksy, więc każda domena potrzebuje własnego wpisu kontekstu; szablon oszczędza tylko jego listę
public.
Alternatywy.
- Szablony jako osobne pojęcie w regułach: reguły musiałyby ustalać role każdego pakietu przy sprawdzaniu, a szablon mógłby wyrażać rzeczy, których nie wyrazi żadna ręczna konfiguracja, co utrudnia rozumowanie o nim i odejście od niego.
- Warstwy sąsiednie jako konteksty, tak jak
inwards import-configodwzorowuje|: konteksty przyjmują dosłowne prefiksy, więc nie obejmąsrc.*.models, a kontekst warstwy sąsiedniej zagnieżdżony w kontekście domeny zabrałby jej moduły z kontekstu domeny. - Uporządkowanie warstw sąsiednich (
modelsprzedschemas):schemas -> modelsby nie przeszło, alemodels -> schemasby przeszło, a|znaczy co innego. - Klucz
rankna każdej warstwie: bardziej elastyczny, ale łatwo o błąd; zagnieżdżona tablica pokazuje kolejność w samej liście.
ADR-037: Rodziny reguł dla frameworków, opt-in, z własnym prefiksem
Stan: Przyjęty · 2026-09-28 · #186
Kontekst. Rozdział 1 mówi, że Inwards rozumuje wyłącznie o strukturze zależności między twoimi własnymi modułami. #98 już planuje reguły treści zależne od roli warstwy. FastAPI to kolejny krok: część tego, co psuje się w projekcie FastAPI, dotyczy architektury i wymaga widoku całego projektu, którego linter działający plik po pliku nie ma. APIRouter, którego nic nie dołącza, kody błędów niezadeklarowane w schemacie OpenAPI i handlery wyjątków zarejestrowane w innym pliku obejmują wiele plików. Ruff ma już reguły FastAPI (FAST001–FAST003, FAST004 w przeglądzie), a flake8-fastapi kody CF; oba działają plik po pliku. Reguły opt-in i opcje reguł istnieją od poprawki #181 do ADR-027.
Decyzja.
- Reguły dla frameworków tworzą rodziny z własnym prefiksem. Reguły FastAPI to
FAPIi trzy cyfry. KodyINWzostają dla reguł architektury, które obowiązują w każdym projekcie Pythona; kodFAPIod razu mówi, że rada dotyczy frameworka.FASTnależy do Ruffa, aCFdo flake8-fastapi, więc użycie któregokolwiek dałoby jednemu kodowi dwa znaczenia w tym samym repozytorium. Kolejna rodzina (np.DJdla Django) dostanie własny prefiks, bez przenumerowywania czegokolwiek. Kody są wszędzie dokładne, więcselect,ignore, wyciszenia i SARIF nie wymagają zmian. - Każda reguła rodziny jest opt-in (
default: "off"): zgłasza tylko wtedy, gdy wymienia jąextend-selectalboselect, a opcje przyjmuje w[tool.inwards.rules.<rule-name>]. Projekt, który nie używa frameworka, nic nie płaci, nawet parsowaniem: wspólny model czyta plik tylko wtedy, gdy jego tekst wspomina framework. - Nie dublujemy Ruffa. Reguła rodziny nigdy nie zgłasza tego, co już zgłaszają reguły Ruffa dla danego frameworka (
FAST) albo flake8-async (ASYNC). Gdy Ruff pokrywa przypadek jednego pliku, reguła Inwards pokrywa tylko to, co wymaga innych plików. - Jeden wspólny model na rodzinę. Reguły FAPI czytają jeden model aplikacji, routerów, operacji ścieżek, połączeń i handlerów wyjątków (
rules/fastapi/), zbudowany statycznie ze źródeł i rozwiązywany między plikami przezProjectIndex. Aplikacja nigdy nie jest importowana ani uruchamiana (ADR-006). - Zarejestrowane kody mogą pojawić się przed swoimi sprawdzeniami. FAPI001–FAPI003 są zarejestrowane razem ze swoimi stronami już teraz i niczego nie zgłaszają aż do #183 i #184; ich strony to mówią. Kody planowane później (FAPI004 dla spike'a #185, FAPI005–FAPI009 dla #224–#228) są wymienione w indeksie reguł, ale niezarejestrowane, więc do czasu wydania pozostają błędami konfiguracji.
Konsekwencje.
- Zespół włącza rodzinę reguła po regule, a kod znaleziska mówi, czy to rada o architekturze, czy o frameworku.
- Model powstaje raz; każda reguła FAPI to zapytanie do niego.
- Zdanie z rozdziału 1 o „wyłącznie strukturze zależności” przestaje być prawdą dla rodzin opt-in; domyślny zestaw reguł nadal je spełnia.
- Zarejestrowany kod bez sprawdzeń jest akceptowany przez
extend-selecti nic nie robi, czego użytkownik może się nie spodziewać; jedynym sygnałem jest baner na stronie reguły. - Statyczne rozwiązywanie nie widzi dynamicznych połączeń (routery znajdowane przez
importlib, fabryki); każda reguła musi powiedzieć, jak się wtedy zachowuje.
Alternatywy.
- Reguły FastAPI jako kody
INW: jedna przestrzeń nazw, ale zespół nie mógłby włączać ani wyłączać rad o frameworku jako całości, a kody mieszałyby dwa rodzaje reguł. - Użycie prefiksu
FASTRuffa: znajomy, aleFAST002znaczyłby dwie różne reguły w jednym repozytorium. - Domyślnie włączone w projektach, które importują FastAPI: mniej konfiguracji, ale po aktualizacji w każdym projekcie FastAPI pojawiłyby się nowe błędy.
- Przekazanie sprawdzeń do Ruffa: Ruff sprawdza plik po pliku, a te sprawdzenia potrzebują widoku całego projektu.
Poprawka, 2026-09-28: diagnostyki, które potrzebują całego projektu (#184). FAPI003 to pierwsza reguła z rodziny, której diagnostyki potrzebują wszystkich plików: router jest niepodpięty tylko wtedy, gdy żadna aplikacja w projekcie go nie dołącza.
- Da się ją wyciszyć, w przeciwieństwie do INW004. Każda diagnostyka FAPI003 ma własną linię (wywołanie
APIRouter(...), wywołanieinclude_router, które zamyka cykl), więc wyciszenie w niej dotyczy jednej decyzji. INW004 nie da się wyciszyć, bo komentarz stałby przy jednym z wielu importów. - Tylko sprawdzane pliki, względem całego grafu. Częściowe sprawdzenie (ścieżka w argumencie, Stop gate) buduje graf aplikacji i routerów ze wszystkich plików FastAPI w projekcie i zgłasza tylko w plikach, które sprawdza. Stop gate zgłasza więc router, który sesja utworzyła lub zmieniła, a router niepodpięty już na starcie sesji jest starym błędem.
- Hook edycji i edytor zgłaszają tylko diagnostyki z jednego pliku. Utworzenie routera i podpięcie go do aplikacji to dwie edycje. Graf budują jednak wtedy, gdy plik wycisza FAPI003, żeby wyciszenie liczyło się jako użyte, a nie zamieniało w ostrzeżenie INW009, a potem odrzucają to, co znalazły.
Poprawka, 2026-10-11: reguły treści pomijają moduły testowe (#362). Przebieg na korpusie z #182 zgłosił FAPI001 na dwóch jednorazowych aplikacjach, które budują testy Polara, i INW015 na teście python-ddd, który importuje logger z infrastruktury. Nikt nie poprawiłby żadnego z nich.
- Moduły testowe po nazwie, dla każdej reguły treści opt-in. INW012 do INW016 i FAPI001 do FAPI009 nie zgłaszają w module, którego ostatni segment nazwy to
test_*albo*_test, albo który ma segmenttests,testlubconftest. Nazwa to wszystko, co silnik wie bez I/O, i odpowiada domyślnemu zbieraniu testów przez pytest. Reguły importów nadal sprawdzają moduły testowe: test, który importuje w poprzek warstw, wciąż warto znać. check-tests = true, osobno dla każdej reguły, przywraca je. Klucz leży w tabeli opcji reguły obokmodules, więc tabela reguł rozstrzyga go tak samo: reguła jest w tym module wyłączona, wyciszenie w nim nie jest zgłaszane jako nieużywane, a wpis baseline'u w nim jest uśpiony. Zespół, który chce INW013 w swoich asynchronicznych testach, włącza tę jedną regułę.ignorezostaje przy INW006. Jego wpisy wskazują moduły poza warstwami, które nie potrzebują ostrzeżenia, a importy z nich nadal są sprawdzane;inwards initwpisuje do niegoscriptsimigrations. Gdyby reguły treści czytałyignore, zmieniłoby to, co sprawdzają istniejące konfiguracje, a testy obejmują już nazwy wyżej. Resztę załatwiamodulesi wyciszenie.
Konsekwencje: ponowny przebieg na korpusie usuwa dokładnie te 3 zgłoszenia i nic więcej. Projekt, który uruchamiał regułę treści na swoich testach, przestaje widzieć te zgłoszenia, dopóki nie ustawi check-tests. Pomocnik testów spoza konwencji, na przykład app/testing/factories.py, nadal jest sprawdzany; wyłącza go modules albo wyciszenie. Alternatywy: czytanie ignore (odrzucone wyżej); jeden klucz najwyższego poziomu dla wszystkich reguł treści (jedna linia w projekcie, ale tabela reguł potrzebowałaby wartości spoza siebie, a zespół rzadko chce przywrócić w testach wszystkie reguły naraz); same dokumenty, polecające modules (to lista dozwolonych, więc pominięcie tests oznacza wypisanie wszystkich innych pakietów).
ADR-038: Kopia startu sesji poza projektem, przeciw odtworzonemu SessionStart
Stan: Przyjęty · 2026-09-28 · #88
Kontekst. Stop gate ufa plikowi .inwards/state/<id>.start.json: konfiguracjom, HEAD i skrótom plików, od których zaczęła się sesja. Config guard trzyma od niego z daleka narzędzia plikowe agenta, ale Bash dociera do niego na sposoby, których żaden wzorzec nie widzi. Przegląd #23 pokazał pełne obejście: poluzować [tool.inwards] przez sed, d=.inw; rm -rf ${d}ards/state, a potem przekazać do I=inwards; $I hook claude-code ładunek SessionStart z source: startup i tym samym identyfikatorem sesji. Hook zapisuje nowy start z poluzowanego projektu i Stop przechodzi. Częściowe odtworzenie (usunięcie samego <id>.start.json) też działało, a od #157 zapisuje także kopie własnych edycji agenta. Ten sam Bash może usunąć hook Stop z settings.local.json; Claude Code od razu przeładowuje hooki, więc Stop gate tej sesji w ogóle się nie uruchamia. Każdy stan, który trzyma Inwards, może zapisać użytkownik, na którym działa agent, więc żaden lokalny zapis nie jest odporny na podrobienie. Celem jest, żeby takie zmiany wychodziły na jaw przy Stop, bez blokowania użytkownika, który zmienił [tool.inwards] przed sesją i jeszcze tego nie zatwierdził.
Decyzja.
- Kopia poza projektem. SessionStart zapisuje ten sam zapis startu drugi raz, do
$XDG_STATE_HOME/inwards/sessions/<skrót ścieżki projektu>/<id>.start.json(bez tej zmiennej~/.local/state), przycinany tylko według wieku (tydzień). Limit liczby sesji pozwoliłby zalewowi zmyślonych sesji, uruchomionych przez hook, wypchnąć kopię prawdziwej sesji przed odtworzeniem, więc go nie ma, a resume, compact i każdy Stop odświeżają kopię, więc kopia trwającej sesji nigdy się nie starzeje. Platforma dostajeRuntime.stateHomeiStateFiles.outsideDir. - Odtworzenie zachowuje oryginał. SessionStart typu
startupalbocleardla sesji, której pliku startu już nie ma, ale której kopia istnieje, to odtworzenie: kopia wraca jako plik startu, a do dziennika sesji trafia zdarzeniereplay. Resume i compact działają jak dotąd: nigdy nie tworzą startu. - Czytający wolą kopię.
readSessionireadSessionStartbiorą kopię, gdy istnieje, i mówią, jak wypada wobec niej zapis w projekcie: zachowany, usunięty, przepisany albo bez kopii. Hooki edycji też więc używają oryginalnego startu. - Stop zgłasza to, co się nie zgadza. Zapisane odtworzenie, usunięty zapis i przepisany zapis blokują, każdy z własnym komunikatem, obok tego, co wykaże porównanie z oryginalnym startem (zmieniona konfiguracja, nowe naruszenia). Eskalują jak każda inna blokada, więc ostatni Stop pokazuje listę użytkownikowi.
- Zatwierdzona konfiguracja tylko tam, gdzie nie ma kopii. Zapisowi bez kopii (sesja ze starszej wersji Inwards, usunięta kopia albo katalog stanu, którego nie dało się zapisać) Inwards ufa tylko wtedy, gdy każda jego konfiguracja jest tą z HEAD na starcie, czytaną przez
git --no-lazy-fetch cat-file blob, nigdy przezgit show, które mogłoby uruchomić filtry agenta. Sesja z kopią nigdy tego porównania nie robi, więc niezatwierdzona zmiana konfiguracji zrobiona przez użytkownika przed sesją przechodzi. - Brakujący hook Stop zgłasza następny SessionStart. Gdy któraś warstwa ustawień wciąż ma hooki Inwards, ale żadna nie ma hooka Stop, SessionStart mówi o tym użytkownikowi w
systemMessage, a modelowi wadditionalContext. Stop gate sesji, która go usunęła, nie może się uruchomić, więc nie może tego zgłosić. - Brak jakiegokolwiek zapisu też kończy się informacją dla użytkownika. Gdy nie ma ani pliku startu, ani kopii, ostatni Stop kończy teraz turę z
systemMessage, a nie po cichu.
Konsekwencje.
- Odtworzenie z #88 i częściowe z #157 oblewają Stop gate z komunikatem, który nazywa odtworzenie, a zmieniona konfiguracja jest zgłaszana względem oryginalnego startu.
- Własna zmiana konfiguracji użytkownika przed sesją,
/clear, resume i kompaktowanie działają jak wcześniej. - Kopia to próg zwalniający. Agent, który przed odtworzeniem usunie albo podrobi też
~/.local/state/inwards/sessions/..., dostaje świeży punkt odniesienia. Dokumentacja wymienia pozostałe warstwy:permissions.deny, CODEOWNERS iinwards checkw CI. - Hook Stop usunięty w trakcie sesji wyłącza bramkę tej sesji; ostrzeżenie przychodzi sesję później i tylko wtedy, gdy SessionStart wciąż się uruchamia.
- Inwards pisze teraz poza projektem, w katalogu stanu użytkownika. Zapis kopii jest najlepszym wysiłkiem: gdy katalogu stanu nie da się zapisać (katalog domowy tylko do odczytu w kontenerze CI albo w piaskownicy agenta), SessionStart i tak się udaje, raz informuje użytkownika, a sesja wraca do porównania z zatwierdzoną konfiguracją.
- Git starszy niż 2.44 nie ma
--no-lazy-fetch. Poza częściowym klonem nic nie może zostać pobrane, więc zatwierdzona konfiguracja jest czytana bez tej flagi. W częściowym klonie (extensions.partialClonealbo zdalne repozytorium zpromisorlubpartialclonefilter) nie jest czytana, a zapis bez kopii blokuje z komunikatem, że konfiguracji nie dało się sprawdzić i że pomoże nowszy git albo katalog stanu z prawem zapisu. - Zalew zmyślonych sesji tylko dodaje małe pliki kopii, które znikają po tygodniu.
Alternatywy.
- Zawsze porównywać konfigurację startu z zatwierdzoną: wykrywa odtworzenie bez kopii, ale blokuje każdą sesję, która zaczyna się z niezatwierdzoną zmianą konfiguracji, a tak właśnie użytkownicy zmieniają warstwy.
- Czytać transkrypt Claude Code i odrzucać start zapisany po pierwszym użyciu narzędzia w sesji:
transcript_pathw ładunku Stop pochodzi od Claude Code, ale format transkryptu nie jest publicznym kontraktem, plik bywa duży, agent może go zapisać tak samo, a OpenCode go nie ma. - Znacznik poza projektem przy pierwszym wywołaniu narzędzia w PreToolUse: to samo polecenie Bash, które usuwa stan, może usunąć znacznik przed odtworzeniem.
- Podpisywać zapis startu: klucz leżałby tam, gdzie użytkownik agenta może go odczytać.
ADR-039: Daemon hooków dla każdego projektu, osobno od serwera języka
Stan: Przyjęty · 2026-10-10 · #59
Kontekst. Zaplanowane są trzy długo działające procesy: proces, który trzyma silnik w gotowości dla hooków (#60), serwer języka w pliku binarnym (#63, ADR-008) i serwer MCP (#65). Rozdział 6 nazywał proces hooków inwards server, czyli tak, jak ADR-008 nazywa serwer języka, a backlog nazywał go inwards daemon. Otwarte było też pytanie, czy jeden proces może obsługiwać i edytor, i hooki.
Dziś CLI uruchamia jedno polecenie na proces. main.ts raz buduje AppDeps, runCheck przy każdym wywołaniu czyta konfigurację i tworzy Engine, a środowisko WASM i gramatyka wczytują się raz na proces (obietnica na poziomie modułu w python/parser.ts). Serwer języka w VS Code już jest stałym procesem: to proces Node, który rozszerzenie uruchamia przez IPC i który trzyma silnik, indeks modułów i pamięciową pamięć podręczną ekstrakcji, dopóki okno jest otwarte.
Eksperyment (rozdział 6) uruchamiał prawdziwą obsługę hooka na ciepło za gniazdem uniksowym i porównywał ją z jednorazowymi uruchomieniami pliku binarnego darwin-arm64, na macOS, przy średnim obciążeniu od 5 do 7. Wyniki:
- Start klienta to podłoga.
inwards --versiontrwa 15,5 ms (p50), a każde wywołanie hooka uruchamia proces, zanim o cokolwiek zapyta. - Daemon opłaca się przy PostToolUse. Jednorazowo, p50 / p95: 46,6 / 50,2 ms dla pliku z 13 liniami i 119,9 / 151,6 ms dla pliku z 4492 liniami i dwoma naruszeniami. Ta sama obsługa na ciepło, bez zmian w kodzie: 32,3 / 35,2 i 91,1 / 97,7 ms. Z dwiema pamięciami podręcznymi w pamięci: 17,2 / 19,8 i 18,2 / 19,7 ms, a 47,6 / 50,1 ms (jednorazowo 117,5 / 122,8), gdy duży plik zmienia się przed każdym wywołaniem.
- Jedno wywołanie gita kosztuje tyle, co start procesu. Jedno
git cat-file blob, które czyta tekst pliku ze startu sesji, żeby oddzielić stare naruszenia od nowych, trwa około 15 ms, a każdy PostToolUse sprawdza plik dwa razy: taki, jaki jest teraz, i taki, jaki był na starcie sesji. Dla dużego pliku to 30 ms za każdym razem, na ciepło. - Pozostałe zdarzenia nie zyskują. PreToolUse trwa jednorazowo 16,8 ms, tuż przy podłodze 15,5 ms. Stop trwa 141 ms, raz na turę.
Decyzja.
- Osobne procesy, jeden plik binarny.
inwards serverto serwer języka: LSP przez stdio, uruchamiany i zatrzymywany przez edytor, jeden na obszar roboczy, sprawdza niezapisany tekst z edytora.inwards daemonobsługuje hooki: jeden na użytkownika i projekt, uruchamia go hook, znika po 10 minutach bez żądania, sprawdza to, co jest na dysku.inwards mcpto serwer MCP przez stdio, uruchamiany przez klienta MCP. Wszystkie trzy korzystają z jednego modułu ciepłego silnika w CLI i nigdy ze sobą nie rozmawiają. - Przez daemona idzie tylko PostToolUse. SessionStart, PreToolUse i Stop zawsze działają we własnym procesie hooka. PreToolUse nie wczytuje gramatyki, więc nic by nie zyskał. Stop to egzekwowanie reguł i ustala, co sesja zmieniła, z manifestu startowego, a nie tylko z edycji zapisanych przez PostToolUse. Daemon, który odpowiada źle (błąd, nieaktualna wersja albo proces podstawiony przez agenta), może opóźnić zgłoszenie do Stop, ale nie może go przepuścić.
- Ta sama obsługa, platforma na żądanie. Daemon uruchamia dzisiejsze
hookClaudeCodezRuntimezbudowanym z katalogu roboczego i środowiska klienta oraz zStreams, które zbierają wyjście. Klient wypisuje stdout i stderr i kończy się kodem wyjścia daemona. Testy przepuszczają fixture'y E2E hooka obiema drogami, a wyniki muszą się zgadzać. - Trzyma tylko to, co identyfikuje jego treść. Między żądaniami daemon trzyma gramatykę, pamięć podręczną ekstrakcji z kluczem jak w ADR-031 (skrót tekstu, nazwa modułu, flaga pakietu, rewizja ekstrakcji; kilka tekstów na moduł, bo w użyciu są i tekst ze startu, i tekst po edycji; najwyżej 5000 wpisów i około 32 MB, jak w serwerze języka) oraz tekst ze startu sesji czytany z gita, z kluczem: repozytorium, commit startowy i ścieżka. Konfiguracja, baseline, lista plików i stan sesji są czytane od nowa przy każdym żądaniu, tak jak przy jednorazowym uruchomieniu, więc żadna zmiana konfiguracji, checkout ani nowy baseline nie zostawi go z nieaktualnymi danymi. Ciepłe sprawdzenie pliku z 13 liniami, razem z konfiguracją i indeksem modułów, trwało w eksperymencie 0,8 ms. Nic nie trafia na dysk: hooki nadal nie czytają żadnej pamięci podręcznej, którą agent może zapisać.
- Transport.
node:netpo obu stronach: gniazdo domeny uniksowej na Linuksie i macOS, nazwany potok na Windows. Gniazdo leży w katalogu, który może otworzyć tylko użytkownik:$XDG_RUNTIME_DIR/inwards/, w przeciwnym razie$TMPDIR/inwards-<uid>/, w ostateczności/tmp/inwards-<uid>/, tworzonym z uprawnieniami 0700 i używanym tylko, dopóki jest prawdziwym katalogiem należącym do użytkownika z tymi uprawnieniami. Nazwa to 16 cyfr szesnastkowych skrótu prawdziwej ścieżki projektu i 8 losowych, co mieści ścieżkę w limicie 104 bajtów na macOS; potok nazywa się\\.\pipe\inwards-<skrót>-<losowe>. Gdy daemon już nasłuchuje, zapisujedaemons/<skrót>.jsonw katalogu stanu z ADR-038 (uprawnienia 0600, przez plik tymczasowy i zmianę nazwy): protokół, wersję Inwards, tożsamość pliku wykonywalnego, pid i adres. Nazwy potoków na Windows mają jedną przestrzeń dla wszystkich użytkowników, więc losowa część nie pozwala innemu użytkownikowi zająć nazwy wcześniej. - Ramkowanie. Jedno żądanie na połączenie, jedna linia JSON w każdą stronę. Żądanie niesie
protocol: "inwards-daemon/1", wersję, tożsamość pliku wykonywalnego (ścieżkę, rozmiar i czas modyfikacji),argv(obsługiwane jest tylkohook claude-code), katalog roboczy, zmienne środowiska, które czytaRuntime, i dane wejściowe hooka. Odpowiedź niesie kod wyjścia, stdout i stderr alboerror(stale,protocol,too-large). Danych wejściowych powyżej 16 MB klient nie wysyła; hook działa wtedy jednorazowo. - Nieaktualność. Każda różnica w protokole, wersji albo tożsamości pliku wykonywalnego daje
stale: daemon kończy pracę, a klient uruchamia sprawdzenie jednorazowo i startuje nowego daemona. Daemon przy każdym żądaniu sprawdza też własny plik wykonywalny, na wypadek aktualizacji, która podmieniła plik w miejscu. Klient i daemon to zawsze ta sama wersja, więc nie ma zgodności między wersjami do utrzymywania. - Start, wyścigi i powrót do jednorazowego uruchomienia. Hook, który nie znajdzie daemona, nie połączy się w ciągu 100 ms albo dostanie
stale, działa jednorazowo, więc odpowiada nie później niż dziś, a potem uruchamiainwards daemonw tle. Dwa hooki, które startują daemona jednocześnie, rozstrzyga plik blokady tworzony na wyłączność obok zapisu, z pidem w środku; przegrany kończy pracę, a blokadę, której pid już nie istnieje, usuwa się i próbuje raz jeszcze. Adresy są losowe, więc dwa daemony nigdy nie walczą o tę samą ścieżkę. Po wysłaniu żądania klient czeka na odpowiedź tak długo, jak pozwala limit czasu samego hooka: równoległe uruchomienie hooka zapisałoby edycję dwa razy. Połączenie zamknięte bez odpowiedzi kończy się jednorazowym uruchomieniem, a #60 zapisuje edycje z kluczemtool_use_id, żeby ta powtórka nie policzyła edycji dwa razy. - Jedno żądanie naraz. Daemon obsługuje żądania w kolejności nadejścia, tak jak serwer języka szereguje przeładowania: równoległe wywołania narzędzi zapisują ten sam stan sesji.
- Wyłączniki.
INWARDS_DAEMON=0sprawia, że każdy hook działa jednorazowo. Daemon jest wyłączony, gdy ustawione jestCI, a testy działają z wyłączonym daemonem, z wyjątkiem jego własnych testów. To nie jest klucz[tool.inwards]: zmienia szybkość, nigdy wyniki. - Pełne sprawdzenia zostają jednorazowe.
inwards check,inwards baselinei pula workerów (#61) działają we własnym procesie; daemon obsługuje sprawdzenia jednego pliku i nie trzyma workerów. - Nazwy.
inwards server(jakruff serverity server),inwards daemonzinwards daemon statusiinwards daemon stopdla bieżącego projektu orazinwards mcp. Rozdział 6 i ADR-008 używają tych nazw.
Konsekwencje.
- W eksperymencie p95 PostToolUse spadło z 50,2 do 19,8 ms dla małego pliku i z 122,8 do 50,1 ms dla pliku z 4492 liniami edytowanego przed każdym wywołaniem. Cel #60, p95 poniżej 50 ms, jest spełniony dla małego pliku i na granicy dla dużego. Na linuksowym laptopie z eksperymentu z bajtkodem w rozdziale 6
inwards --versiontrwało 10,5 ms, a nie 15,5. - Przy okazji JIT jest rozgrzany: jednorazowe sprawdzenie dużego pliku trwało 70,8 ms, to samo na ciepło 30 ms.
- Stop gate i guardy zachowują swój model zaufania. Zepsuty albo podstawiony daemon kosztuje opóźnienie i wczesną informację zwrotną, a nie przeoczone naruszenie przy Stop.
- Jeden moduł ciepłego silnika obsługuje trzy procesy, a serwer języka przechodzi do pliku binarnego (#63, #64) z kodem pamięci podręcznej, który ma dziś.
- Każdy projekt z daemonem zajmuje od 150 do 210 MB RSS (serwer z eksperymentu, uruchamiany ze źródeł) przez maksymalnie 10 minut po ostatniej edycji. Pięć sesji agentów w pięciu repozytoriach to pięć daemonów.
- Każde wywołanie hooka nadal uruchamia proces Buna, tu około 15 ms. Usunąć to mógłby tylko klient napisany w innym języku.
- Użytkownik, a więc i agent, może połączyć się z daemonem, zatrzymać go albo wskazać w zapisie własny proces. Połączenie nie daje nic, czego nie daje samo
inwards; podstawiony proces może zmienić tylko to, co mówi PostToolUse, zanim Stop sprawdzi wszystko ponownie. - Nazwane potoki nie zostały zmierzone: eksperyment działał na macOS. #60 musi pokazać przechodzący wiersz Windows (ręczne uruchomienie pełnej macierzy), zanim zostanie scalone.
- Druga ścieżka kodu dla PostToolUse. Przepuszczanie fixture'ów E2E obiema drogami utrzymuje je zgodne.
Alternatywy.
- Jeden proces dla edytora i hooków, czyli serwer języka, który nasłuchuje też na hooki, albo jeden daemon na projekt z
inwards serverjako pośrednikiem stdio. Czasy życia się różnią: okno edytora kontra sesja agenta, a agenci często działają bez otwartego edytora, więc hooki nie mogą na nim polegać. Dane wejściowe się różnią: niezapisane bufory kontra dysk i stan sesji. Pośrednik dodaje skok przez gniazdo przy każdym naciśnięciu klawisza dla serwera, który i tak działa stale, awaria zabiera oba procesy, a kilka okien na jednym repozytorium musiałoby wybrać właściciela. - Każde zdarzenie hooka przez daemona: PreToolUse zyskałby około 1 ms, a werdykt Stop gate pochodziłby z procesu, który agent może podmienić.
- Bez daemona, szybsze jednorazowe uruchomienie: bajtkod już skrócił start o połowę (#39). Zostaje start procesu, wczytanie WASM i gramatyki oraz zimny JIT (27,7 ms jednorazowo wobec 0,8 ms na ciepło dla małego pliku), a do tego praca, którą między procesami dałoby się ponownie wykorzystać tylko przez pliki, które agent może zapisać.
- Silnik dla każdej konfiguracji, aktualizowany przez obserwatory plików: oszczędza ponowne czytanie konfiguracji, które kosztuje dużo poniżej milisekundy, a nieaktualność zamienia w problem poprawności (przegapione zdarzenie, sieciowy system plików).
- TCP na localhost: może się połączyć każdy lokalny użytkownik, port trzeba wybrać i ogłosić, a Windows może zapytać o zaporę.
- Ramkowanie LSP, JSON-RPC albo HTTP przez gniazdo: obsługują identyfikatory żądań, powiadomienia i routing; jedno żądanie na połączenie nie potrzebuje żadnego z nich.
- Mały natywny klient jako polecenie hooka: usunąłby większość podłogi 15 ms, ale dodaje drugi zestaw narzędzi i drugi plik binarny na platformę, wbrew ADR-003. Warto do tego wrócić, jeśli benchmark na Linuksie nie zmieści się w 50 ms.
- Inne nazwy:
inwards serveróżni się odserverjedną literą i kojarzy się z podglądem dokumentacji;inwards lspzrywa z Ruffem i ty, których polecenia użytkownicy spróbują najpierw; jednoinwards serverz trybami--stdioi--socketukrywa, że oba procesy mają innych właścicieli i inne czasy życia.
Poprawka · 2026-10-10 · #60. Implementacja rozstrzyga szczegóły, które decyzja zostawiła otwarte:
INWARDS_DAEMON=1włącza daemona nawet wtedy, gdy ustawionoCI, dla własnych testów daemona i zadania benchmarku, które działają pod CI. Bez tej zmiennej daemon jest włączony, chyba że ustawionoCI;0go wyłącza.- Hook uruchamia daemona tylko w projekcie ze stanem sesji Inwards (
.inwards/state, który tworzy tylko SessionStart i tylko tam, gdzie istnieje[tool.inwards]). Hook zainstalowany dla wszystkich projektów nie uruchamia niczego w projekcie, który nie używa Inwards. - Hook czeka na odpowiedź 45 s, poniżej domyślnego limitu 60 s w Claude Code, żeby jednorazowe ponowienie miało jeszcze czas. Zapisane edycje niosą
tool_use_idz danych hooka, a edycja zapisana dwa razy pod tym samym identyfikatorem liczy się raz, dla listy Stop gate i dla eskalacji, więc to ponowienie nie policzy edycji dwa razy. - Pamięć podręczna ekstrakcji trzyma do 4 tekstów na moduł w granicach 5000 wpisów i 32 MB, a odpowiedzi gita są trzymane tylko dla
cat-file blob <commit>:<ścieżka>ils-tree <commit>z pełnym identyfikatorem commita, do 2000 wpisów i 32 MB. - Przy uruchomieniu ze źródeł tożsamość programu to tożsamość Buna i
main.ts; edycja innego pliku źródłowego nie czyni daemona nieaktualnym. Po takiej edycji uruchominwards daemon stop; skompilowany plik binarny nie ma tej luki. - Daemon odrzuca wszystko poza danymi PostToolUse dla
hook claude-code, więc proces, który się z nim połączy, nie dostanie od niego także werdyktu Stop gate. inwards daemon --idle SECONDSustawia limit bezczynności, domyślnie 600; testy używają krótkich.
Poprawka · 2026-10-10 · #276. Sam pid nie mówi, kto trzyma blokadę: daemon zabity bez sprzątania (SIGKILL, awaria, restart) zostawia swoją blokadę, a gdy system da ten pid innemu procesowi, każdy kolejny daemon ustępował i każdy PostToolUse działał jednorazowo. Blokada trzyma teraz pid i 32 losowe cyfry szesnastkowe, a odpowiedź na inwards daemon status je powtarza. Daemon, który zastanie blokadę, przejmuje ją, gdy jej pid nie istnieje albo jest jego własny, a gdy blokada ma ponad 10 sekund, także wtedy, gdy daemon pod adresem z zapisu nie odpowie tym pidem i tokenem. Młodszą blokadę uznaje za zajętą, bo jej daemon może jeszcze zaczynać nasłuchiwać. Sprawdzenie korzysta tylko z gniazda i wieku pliku, więc działa tak samo na Linuksie, macOS i Windows, a Stop gate nadal od niego nie zależy.
Poprawka · 2026-10-10 · #275. Daemon, który nie może nasłuchiwać (żaden katalog na gniazdo nie jest prywatny dla użytkownika, każda ścieżka gniazda przekroczyłaby 104 bajty albo nasłuchiwanie się nie udaje), kończy działanie, a następny PostToolUse nie znajdował zapisu i uruchamiał kolejnego, więc każda edycja płaciła za proces, który od razu się kończył. Teraz daemon przed zwolnieniem blokady zapisuje obok zapisu plik daemons/<hash>.failed (tylko dla właściciela, przez plik tymczasowy i zmianę nazwy) z czasem, przyczyną i swoim pidem. Hook, który uruchomiłby daemona, nie uruchamia żadnego, dopóki ta notatka ma mniej niż 5 minut, więc seria edycji uruchamia co najwyżej jednego daemona na 5 minut. Daemon, który nasłuchuje, usuwa notatkę, a inwards daemon status pokazuje ją, gdy nic nie działa. Notatka z datą ponad 5 minut w przyszłości (zegar cofnięto) nie wstrzymuje hooków.
Poprawka · 2026-10-10 · #277. Praca hooka jest synchroniczna, a git działał przez spawnSync bez limitu, więc jedno zawieszone wywołanie gita (sieciowy system plików, blokada trzymana przez inny proces gita) blokowało kolejkę daemona: kolejne hooki PostToolUse czekały swoje 45 s, zanim uruchomiły się jednorazowo, a inwards daemon stop czekał za nimi. Teraz wszystkie wywołania gita w jednym żądaniu daemona mają wspólny budżet 5 sekund. Wywołanie, które by go przekroczyło, jest zabijane sygnałem SIGKILL (SIGTERM można zignorować, a spawnSync wraca dopiero po zakończeniu procesu potomnego), wywołanie po jego wyczerpaniu w ogóle się nie zaczyna, a oba odpowiadają „nie ma”, jak nieudane wywołanie. Odpowiedź po przekroczeniu czasu nigdy nie trafia do pamięci podręcznej. Jednorazowy hook i Stop gate nadal uruchamiają gita bez limitu. status i stop omijają kolejkę: daemon odpowiada na nie, gdy tylko je przeczyta, co uruchomienie hooka opóźnia najwyżej o swój budżet gita i własną pracę, a klient czeka na tę odpowiedź 15 s zamiast 5. Gdy daemon się zatrzymuje, porzuca żądania, które jeszcze czekają w kolejce, a ich hooki działają jednorazowo. Żądanie, które wyczerpie budżet, nie kończy daemona: nowy trafiłby na tego samego zawieszonego gita, a nic, co trzyma, nie pochodzi z nieudanych wywołań.
ADR-040: Wątki robocze parsują duże pełne sprawdzenie; wątek główny podejmuje każdą decyzję
Stan: Przyjęty · 2026-10-10 · #61
Kontekst. Zimne inwards check działa na jednym rdzeniu: 1,48 s dla 4324 plików saleora i 2,34 s dla syntetycznego repozytorium w trybie starszego kodu, w którym każdy moduł wymaga parsowania potwierdzającego (p50 na 10-rdzeniowym laptopie). Runnery CI mają kilka rdzeni. Profile zimnego uruchomienia pokazują, na co idzie czas w saleorze: mniej więcej jedna trzecia na parsowanie szkieletu importów przez prescan i testy tekstu przed nim, ćwierć na pełne parsowania potwierdzające znaleziska, ćwierć na przejście drzewa, ustalanie rzeczywistych ścieżek i czytanie plików, a reszta na reguły, indeks modułów i start. Tylko parsowanie zależy wyłącznie od tekstu pliku. ADR-039 umieścił już pulę workerów w procesie samego pełnego uruchomienia, nigdy w daemonie hooków.
Decyzja.
- Wątki, nie procesy. CLI uruchamia wątki robocze Buna, a każdy z nich wykonuje punkt wejścia samego pliku binarnego:
main.tswidzi, że nie jest wątkiem głównym, i zamiast parsować argv obsługuje zadania ekstrakcji. Skompilowany plik wykonywalny nie potrzebuje drugiego punktu wejścia ani niczego na dysku. Każdy worker wczytuje gramatykę z bajtów, które przysyła mu wątek główny. - Jednostką pracy jest zadanie ekstrakcji.
ExtractionJobto plik źródłowy i to, co z niego wydobyć: szkielet (razem z testem na loader, który decyduje, czy szkielet w ogóle się czyta) albo importy i komentarze wyciszające z pełnego parsowania. Odpowiedź to ten sam rekord, który trzyma pamięć podręczna ekstrakcji (ADR-031), więc nie może zawierać niczego, czego nie mogłaby zawierać pamięć podręczna.createExtractionWorkerwykonuje zadania tym samym kodem, którego używa silnik. - Silnik pyta dwa razy, potem sprawdza jak dotąd.
Engine.checkWithprzekazuje partii zadania szkieletu dla każdego pliku, który czyta skan, skanuje, ustala, które pliki sparsują potwierdzenia i komentarze wyciszające, przekazuje je, a potem sprawdza każdy plik po kolei dokładnie tak, jakEngine.check, czytając wcześniej wczytane odpowiedzi przed pamięcią podręczną. Reguły, pierwszeństwo, skrót baseline'u, importy dynamiczne (ich odczyt zależy od innych plików), znaleziska FastAPI obejmujące wiele plików i cykle importów zostają w wątku głównym. - Odpowiedzi to podpowiedzi, nigdy wyniki. Zadanie, na które pula nie odpowie, odpowiedź w złym kształcie albo partia, która się nie powiedzie, silnik liczy sam, jak bez puli, więc każdy błąd pojawia się tak jak dziś. Worker, który padnie albo odpowie błędem, zostaje wycofany, a jego partia wraca do kolejki.
- Wątek główny też parsuje. Gdy workery pracują, wątek główny bierze partie z końca kolejki, więc pula N wątków uruchamia N-1 workerów.
- Kiedy. Wątki uruchamiają tylko
inwards checkiinwards baseline, i tylko dla 1000 plików lub więcej, po jednym wątku na 500 plików, do limitu. Limitem jestINWARDS_THREADS, a bez niej połowa rdzeni ponad dwa, najwyżej 4: jeden wątek na 4 rdzeniach, trzy na 8, cztery od 10. Każdy wątek uruchamia własną maszynę wirtualną JavaScriptu, której kompilator JIT i odśmiecacz potrzebują własnych rdzeni.INWARDS_THREADS=1trzyma sprawdzenie w jednym wątku. To zmienna środowiskowa, a nie klucz[tool.inwards], bo zmienia szybkość, nigdy wyniki.
Konsekwencje.
- Zimne pełne sprawdzenia, p50 z czterema wątkami w porównaniu z bazową kompilacją: saleor 1,48 → 0,98 s, polar 0,80 → 0,55 s, repozytorium syntetyczne 0,52 → 0,44 s, syntetyczne repozytorium w trybie starszego kodu 2,34 → 1,14 s (rozdział 6). Wynik jest identyczny co do bajtu; test porównuje przez CLI jeden wątek z czterema, a testy silnika porównują
checkWithzcheckna każdej ścieżce przez silnik. - Silnik zostaje czysty. Port to funkcja z zadań w odpowiedzi; wątki są adapterem CLI.
- Daleko do trzykrotnego przyspieszenia, o które prosił #61. Przejście drzewa, ustalanie rzeczywistych ścieżek, czytanie plików i reguły zostają w wątku głównym: z czterema wątkami saleor spędza mniej więcej jedną trzecią czasu, zanim silnik w ogóle ruszy. Osiem wątków było wolniejsze niż cztery na saleorze i repozytorium syntetycznym.
- Każdy worker trzyma własne środowisko WASM i gramatykę: szczytowe RSS saleora rośnie z około 360 MB do około 520 MB przy czterech wątkach i 615 MB przy ośmiu.
- Na Linuksie zysk jest mniejszy. Kontener na tym samym laptopie, przypięty do czterech rdzeni, sprawdzał repozytorium syntetyczne o 60% wolniej przy czterech wątkach, a przy dwóch tak samo jak w jednym; przy ośmiu rdzeniach repozytorium w trybie starszego kodu trwało 1,23 s w czterech wątkach wobec 2,30 s w jednym (rozdział 6). Na 4-rdzeniowym runnerze linuksowym zadania benchmarku cztery wątki spowolniły pełne sprawdzenie repozytorium syntetycznego o 59%, a dwa o 19%, więc maszyna z 4 rdzeniami zostaje przy jednym wątku, a trzykrotne przyspieszenie na 4 vCPU, o którym mówiło #61, jest w ten sposób nieosiągalne.
- Worker sam kompiluje gramatykę i rozgrzewa swój JIT, więc poniżej około 1000 plików wątki kosztują więcej, niż oszczędzają. Repozytorium, które wymaga wielu parsowań potwierdzających, zyskałoby wcześniej; próg liczy pliki, bo pracy nie znamy, dopóki nie przejdą skany.
Alternatywy.
- Procesy potomne pliku binarnego: każdy płaci za start procesu (około 15 ms) oprócz gramatyki, a zadania szłyby przez potoki jako JSON zamiast klonu strukturalnego.
- Każdy worker sprawdza wycinek plików: zrównolegla też reguły, ale skrót baseline'u, znaleziska FastAPI obejmujące wiele plików, ostrzeżenia o pakietach bez warstwy i cykle importów potrzebują wszystkich plików, a każdy worker budowałby z dysku własny indeks modułów. Decyzje w jednym wątku zostawiają kolejność wyniku i reguły pierwszeństwa tam, gdzie są.
- Workery czytają też pliki: przeniosłoby do puli ćwierć czasu idącą na czytanie, ale wątek główny i tak potrzebuje każdego tekstu dla reguł, a nazwy modułów biorą się z rzeczywistych ścieżek, którymi zarządzają kontrole tożsamości w CLI.
- Domyślnie więcej wątków: na obciążonym 10-rdzeniowym laptopie osiem wątków było wolniejsze niż cztery na saleorze (1,04 wobec 0,98 s) i repozytorium syntetycznym, a szybsze tylko na repozytorium w trybie starszego kodu (1,03 wobec 1,14 s).
Poprawka · 2026-10-10 · #281. Szeregowa część przed silnikiem potaniała, a żadna decyzja nie opuściła wątku głównego. Przejście drzewa daje każdemu plikowi rzeczywistą ścieżkę, którą już ustaliło dla jego katalogu, więc sprawdzenie wywołuje realpath raz na katalog i dowiązanie symboliczne zamiast dwa razy na plik. Sprawdzenie 1000 plików lub więcej najpierw liczy pliki, uruchamia pulę, a potem czyta wszystkie pliki jedną partią, gdy workery ładują gramatykę. Każdy worker trzyma dwie partie, więc nie czeka, aż wątek główny skończy własną, żeby dostać następną. Zimne sprawdzenie saleora przy czterech wątkach skróciło się z 1,09 do 0,87 s, wobec 1,48 s w jednym wątku przed #61 (rozdział 6). Alternatywa Workery czytają też pliki pozostaje odrzucona: wariant, w którym wolne workery parsowały każdą porcję plików zaraz po przeczytaniu, a silnik używał odpowiedzi na identyczne zadania, nie był szybszy. Na Linuksie zmiana nie przyspieszyła niczego na czterech rdzeniach i przyspieszyła o 5% na ośmiu, bo Linux tanio ustala ścieżki i czyta pliki ze swoich pamięci podręcznych.
ADR-041: inwards server używa kodu inwards check; serwer Node rozszerzenia zostaje do jego przełączenia
Stan: Przyjęty · 2026-10-10 · #63 · zastępuje ADR-008
Kontekst. ADR-008 zostawił serwer języka na Node w rozszerzeniu VS Code, dopóki plik binarny nie będzie miał inwards server. ADR-039 ustalił tę nazwę, zostawił serwer jako osobny proces i dał CLI moduł z rozgrzanym silnikiem (daemon/memory.ts), którym wcześniej była pamięć podręczna ekstrakcji w pamięci rozszerzenia. Serwer rozszerzenia to drugi adapter wokół silnika: ma własne przejście po plikach (workspace.ts, utrzymywane w zgodzie z CLI przez test zgodności), własny odczyt konfiguracji, indeks modułów przebudowywany na zdarzeniach plików i czyta tylko pyproject.toml z korzenia pierwszego folderu obszaru roboczego. Dla plików, których nikt nie otworzył, pokazuje INW007 i INW008 z listingu katalogów, więc dla każdej innej reguły edytor i inwards check się tam nie zgadzają. Plik binarny działa na Bunie, rozszerzenie na Node w hoście rozszerzeń VS Code, a ścieżka sprawdzania w CLI używa parsera TOML Buna i gramatyk wbudowanych w plik wykonywalny.
Decyzja.
- Serwer mieszka w CLI i sprawdza kodem
inwards check.src/cli/src/lsp/decyduje, co i kiedy sprawdzić i co pokazuje każdy dokument,adapters/lsp-connection.tsmówi LSP przez stdio za pomocąvscode-languageserver10 (tej samej wersji co rozszerzenie), acommands/server.tsto komenda. Każde sprawdzenie idzie przezplanCheckirunCheck, więc serwer nie ma własnego przejścia po plikach, odczytu konfiguracji ani indeksu modułów. - Z rozszerzeniem nic nie jest współdzielone. Rozszerzenie zachowuje zamrożony serwer Node, dopóki #64 nie zrobi z niego cienkiego klienta, który uruchamia
inwards server, i nie usuniesrc/vscode-extension/src/server/. Zmiany w tym, co pokazuje edytor, trafiają do serwera w CLI. - Przebieg całego projektu to
inwards checkw każdym folderze obszaru roboczego. Każdy folder dostaje konfiguracje, które uruchomiłby taminwards check(najbliższe[tool.inwards]albo konfigurację każdego członka workspace'u uv), każdą raz, z niezapisanym tekstem otwartych dokumentów zamiast tekstu z dysku. Każda diagnostyka trafia na swój plik, więc plik, którego nikt nie otworzył, pokazuje wszystko, co zgłaszainwards check, apyproject.tomlpokazuje diagnostyki INW006 całego projektu. Przebieg rusza na starcie, po zapisie, gdy folder obszaru roboczego się pojawi lub zniknie, i gdy obserwatory plików edytora zgłoszą zmianę, która może zmienić diagnostykę: utworzenie, zmianę lub usunięcie pliku modułu albo katalogu,pyproject.tomllubinwards-baseline.json, poza ukrytymi katalogami i__pycache__. Zdarzenia są zbierane przez 100 ms, więc zmiana gałęzi uruchamia jeden przebieg. - Naciśnięcie klawisza sprawdza tylko ten dokument, tak jak hook PostToolUse sprawdza edycję (
edit: true), z konfiguracją, do której skierowałby goinwards check. Dokument pokazuje to sprawdzenie i to, co ostatni przebieg znalazł w nim, a czego sprawdzenie jednego pliku znaleźć nie może (cykl importów, router FastAPI, którego nie dołącza żadna aplikacja); te diagnostyki odświeżają się przy następnym zapisie. - Nic nie jest trzymane poza wyekstrahowanym tekstem. Jak w daemonie, każde sprawdzenie czyta konfigurację, baseline i listing plików od nowa, więc edycja konfiguracji, checkout ani nowy baseline nie zostawią serwera nieaktualnym, a zdarzenia plików decydują tylko o tym, kiedy rusza przebieg. Między sprawdzeniami serwer trzyma pamięć podręczną ekstrakcji daemona (5000 wpisów, około 32 MB, 4 teksty na moduł). Na 10-rdzeniowym laptopie syntetyczne repozytorium z rozdziału 6 (2100 plików) zajęło 504 ms przy pierwszym przebiegu, 154 ms p50 przy kolejnych i 0,6 ms p50 na naciśnięcie klawisza, uruchomione ze źródeł.
- Jeden wątek, jedno sprawdzenie naraz. Serwer nigdy nie uruchamia wątków roboczych (ADR-040). Sprawdzenia biegną w kolejności nadejścia; sprawdzenie po naciśnięciu klawisza, które jeszcze czeka, czyta najnowszy tekst, gdy rusza, więc pisanie kolejkuje najwyżej jedno na dokument.
- Stdout należy do protokołu. Połączenie dostaje stdin i stdout wprost; strumienie samego sprawdzenia piszą tekst ze stdout na stderr, a Biome trzyma
consolez dala od CLI.--stdio, które edytory przekazują z przyzwyczajenia, jest przyjmowane i niczego nie zmienia;--clientProcessIdbiblioteka czyta sama. Serwer kończy się poexit, gdy stdin się zamknie albo gdy zniknie proces edytora. - Błędy. Zepsuta konfiguracja wyskakuje raz na konfigurację i komunikat i zostaje jako błąd na swoim
pyproject.toml(w wierszu, który wskazuje parser TOML, inaczej w pierwszym), dopóki przebieg nie stwierdzi, że jest poprawiona; jej pliki niczego w tym czasie nie pokazują.
Konsekwencje.
- Każdy edytor z klientem LSP (Neovim, Helix, a VS Code po #64) dostaje Inwards z jednego pliku binarnego, bez instalowania czegokolwiek innego.
- Gdy wszystkie pliki są zapisane, edytor pokazuje to, co
inwards checkzgłasza w każdym folderze;src/cli/test/lsp/parity.test.tsporównuje jedno z drugim na examples/ jako obszarze roboczym z dwoma folderami, w CI na skompilowanym pliku binarnym. - Nie ma indeksu modułów ani konfiguracji do utrzymywania w aktualności, więc rezerwowe ścieżki rozszerzenia dla braku obserwatorów i serializowane przeładowania nie mają tu odpowiednika; edytor bez obserwowania plików dostaje nowy przebieg przy każdym zapisie.
- Do #64 są dwa serwery języka: serwer rozszerzenia nadal pokazuje dla nieotwartych plików tylko INW007 i INW008.
- Każdy zapis kosztuje sprawdzenie całego projektu. Parsowanie jest w pamięci podręcznej, ale przejście po drzewie, czytanie plików i reguły już nie: 154 ms dla 2100 plików.
- Niezapisane edycje
pyproject.tomlalbo baseline'u liczą się dopiero po zapisie, a diagnostyki w innych plikach, które zależą od niezapisanego tekstu (na przykład cykle przez niego), odświeżają się dopiero przy następnym przebiegu. - Dwa foldery obszaru roboczego, których konfiguracje obejmują ten sam plik (projekt zagnieżdżony w innym, który nie jest członkiem workspace'u uv), pokazują jego diagnostyki dwa razy, tak jak
inwards checkuruchomione w obu folderach. - Plik binarny zawiera
vscode-languageserverz jego bibliotekami protokołu i JSON-RPC. - Ścieżki plików, których nikt nie otworzył, stają się URI przez
pathToFileURLz Node; otwarte dokumenty zachowują URI edytora. Litery dysków Windows i ich kodowanie nie były sprawdzane na Windows, więc przed wydaniem musi przejść pełna macierz testów.
Alternatywy.
- Moduł importowany już teraz przez oba serwery: rozszerzenie musiałoby uruchamiać ścieżkę sprawdzania CLI na Node, czyli zastąpić tam parser TOML Buna i wbudowane gramatyki, dla serwera, który #64 usunie w następnym wydaniu.
- Rozszerzenie uruchamia plik binarny już teraz: rozszerzenie potrzebowałoby wtedy pliku binarnego dla każdej platformy w VSIX albo kroku pobierania, a to praca #64, razem z Marketplace.
- Projekt serwera rozszerzenia w pliku binarnym (otwarte pliki sprawdzane w całości, reszta z listingu, indeks modułów utrzymywany przez obserwatory): przenosi niezgodność z
inwards checkdo pliku binarnego i trzyma pamięć podręczną, której aktualność zależy od tego, czy dotrze każde zdarzenie. - Przebieg całego projektu po każdym naciśnięciu klawisza: zawsze dokładny, ale każda przerwa w pisaniu w dużym projekcie kosztuje sprawdzenie całego projektu, wobec 0,6 ms dla jednego pliku.
- Wątki robocze dla przebiegu: każdy przebieg uruchamiałby od nowa pulę maszyn wirtualnych JavaScript albo trzymał jedną żywą na okno edytora; liczby z ADR-040 pokazują, że wątki opłacają się dopiero od około 1000 plików, a ciepły przebieg i tak korzysta z pamięci podręcznej.
ADR-042: inwards mcp odpowiada sprawdzeniem inwards check, na tekstach nałożonych na dysk
Stan: Przyjęty · 2026-10-10 · #65
Kontekst. ADR-039 nazwał inwards mcp trzecim długo działającym frontem: serwerem MCP przez stdio, uruchamianym przez klienta MCP agenta, korzystającym z modułu z rozgrzanym silnikiem i nierozmawiającym ani z inwards server, ani z inwards daemon. Zgłoszenie prosiło o trzy narzędzia: check_files, explain_rule i where_should_this_go. Hooki widzą kod dopiero po edycji; narzędzie MCP może odpowiedzieć, zanim agent coś zapisze, ale tylko wtedy, gdy agent zapyta. SDK MCP dla TypeScriptu ma dwie linie: v1 (@modelcontextprotocol/sdk), które dostaje już tylko poprawki błędów i bezpieczeństwa, oraz v2 (@modelcontextprotocol/server 2.3), które implementuje rewizję 2026-07-28 i nadal obsługuje klientów zaczynających od initialize. Claude Code i sam klient v2 wciąż zaczynają od initialize (2025-11-25).
Decyzja.
- Jeden proces na sesję klienta, w CLI.
src/cli/src/mcp/zawiera politykę narzędzi,adapters/mcp-connection.tsmówi MCP przez stdio za pomocą SDK v2 (2.3.1) i jegoserveStdio, które obsługuje obie ery protokołu z jednej fabryki serwera, acommands/mcp.tsto komenda. Schematy wejścia to Zod 4 (zod4.6.5), które SDK zamienia na JSON Schema pokazywane przeztools/list. SDK, Zod i strony reguł ładują się przez dynamiczne importy, więc plik binarny trzyma je w chunkach, które czyta tylkoinwards mcp; żadne wywołanie hooka za nie nie płaci. check_filestoinwards check.planCheckkieruje cele od katalogu roboczego,runPlanuruchamia i scala konfiguracje, arunChecksprawdza, z rozgrzanym wejściem-wyjściem serwera języka (pamięć podręczna ekstrakcji w pamięci, jedno zachowane parsowanie, bez wątków roboczych). Kod Pythona, który agent przekazuje wcontents, jest na czas wywołania nakładany na dysk (project/overlay.ts): plik, którego jeszcze nie ma, razem z brakującymi katalogami pakietów, pojawia się w sondzie, listingach, przejściu po drzewie, a więc i w indeksie modułów, i czyta się jako podany tekst. Odpowiedź to raportinwards/diagnostics@1. Nic nie jest zapisywane i nic nie trafia do run logu, bo wywołanie jest pytaniem, a nie uruchomieniem.explain_rulezwraca strony reguł. Angielskie strony zdocs/chapters/rules/są importowane jako tekst i wbudowane w plik binarny; narzędzie zwraca metadane z rejestru i sekcje strony What it does, Why is this bad, Example i How to fix (zfullkażdą sekcję), bez znaczników testów i z linkami względnymi zamienionymi na bezwzględne. Test nie przechodzi, gdy zarejestrowana reguła nie ma wbudowanej strony.where_should_this_gopyta sprawdzenie, a nie czyta konfiguracji drugi raz. Dla modułu, który wskazał agent, i dla nowego modułu w pierwszym dosłownym prefiksie każdej warstwy sprawdza w pamięci moduł próbny, który zawiera tylko planowane importy. Import jest odrzucony dokładnie wtedy, gdy prawdziwy plik w tym miejscu dostałby INW001, INW002, INW003, INW005 albo INW010. Sugestia to wskazany moduł, gdy jego importy przechodzą; w przeciwnym razie, spośród warstw, w których przechodzą wszystkie, ta, na którą wskazuje opis, a gdy żadna, najbardziej wewnętrzna; bez importów warstwa nazwana w opisie albo wskazana przez krótką listę słów o roli kodu.- Tylko do odczytu i po kolei. Każde narzędzie jest oznaczone jako tylko do odczytu i idempotentne. Wywołania idą jedno po drugim, jak sprawdzenia serwera języka, więc dwa nigdy nie dzielą zachowanego parsowania. Każde wywołanie czyta konfigurację, baseline i listing od nowa.
- Stdout należy do protokołu. Sprawdzenia dostają strumienie, których stdout pisze na stderr, tak jak w
inwards server. Serwer kończy pracę, gdy klient zamyka stdin.
Konsekwencje.
- Każdy klient MCP dostaje trzy narzędzia z jednego pliku binarnego; Claude Code i Codex CLI wypróbowano ręcznie, a testy sterują skompilowanym plikiem binarnym przez stdio klientem z SDK, w obu erach.
- Agent może sprawdzić kod, zanim go zapisze, także w pakiecie, którego jeszcze nie ma, i dostać te same diagnostyki i kroki naprawy, które hook PostToolUse dałby po edycji.
-
where_should_this_goprzestrzega każdej reguły, która ocenia importy, łącznie z kontekstami i regułami bibliotek, bez własnego kodu, który mógłby się z nimi rozjechać. - Plik binarny zawiera SDK i Zod (około 0,5 MB po minifikacji) oraz strony reguł (około 0,2 MB), ładowane tylko przez
inwards mcp. -
explain_rulezwraca tylko wersję angielską; polskie strony zostają na stronie dokumentacji. - Każda próba to sprawdzenie: jedno na warstwę i jedno dla wskazanego modułu. Konfiguracja z wieloma warstwami spowalnia wywołanie, choć każde to sprawdzenie jednego pliku na rozgrzanych pamięciach podręcznych.
- Podpowiedź z opisu to lista słów. Zna angielskie słowa o roli kodu i skonfigurowane nazwy, nic więcej.
- Moduł próbny nie odróżni nazwy pisanej małą literą w module (
shop.domain.order.total) od podmodułu; narzędzie czyta ją jako moduł, więc INW010 może ją zgłosić. Nazwy wielką literą (Order) są importowane jako nazwy.
Alternatywy.
- SDK v1: ten sam kształt API, ale tylko utrzymanie, i bez obsługi rewizji 2026-07-28.
- JSON-RPC pisany ręcznie: bez zależności, ale dwie ery protokołu, walidacja schematów i handshake byłyby na naszej głowie przy każdej zmianie specyfikacji.
where_should_this_goz samej konfiguracji (kolejność warstw i prefiksy): prostsze, ale pominęłoby konteksty, reguły bibliotek i moduły, których nie ma, i powtarzało logikę reguł poza silnikiem.- Model językowy do czytania opisu: Inwards nie ma sieci ani modelu, a odpowiedź powinna być za każdym razem taka sama.
- Strony reguł jako zasoby MCP: klienci podsuwają modelowi narzędzia pewniej niż zasoby, a zgłoszenie prosiło o narzędzie. Zasoby mogą przyjść później.
explain_rulez opublikowanej strony: wymaga sieci, a strona mogłaby opisywać inną wersję niż ta w pliku binarnym.
ADR-043: Rozszerzenie VS Code zawiera plik binarny, jeden VSIX na platformę
Stan: Przyjęty · 2026-10-10 · #64 · domyka ADR-041
Kontekst. ADR-041 przeniósł serwer języka do pliku binarnego i zamroził serwer Node rozszerzenia do czasu, aż rozszerzenie zacznie uruchamiać inwards server. Do tego rozszerzenie potrzebuje pliku wykonywalnego inwards dla platformy użytkownika. cd.yml już teraz kompiluje sześć plików binarnych na jednym runnerze, uruchamia każdy na jego własnym systemie i dołącza je razem z SHA256SUMS do szkicu wydania na GitHubie (#14). Repozytorium jest prywatne, więc pobranie pliku z wydania wymaga zalogowania do GitHuba. Od VS Code 1.61 Marketplace serwuje pakiet zbudowany dla platformy użytkownika, vsce package --target buduje taki pakiet, a Open VSX też je serwuje.
Decyzja.
- Jeden VSIX na platformę, z plikiem binarnym tej platformy w środku.
src/vscode-extension/scripts/package-target.tskopiuje każdy plik binarny z wydania dobin/(bin/inwards.exena Windows) i uruchamiavsce package --targetdlalinux-x64,linux-arm64,alpine-x64(plik binarny dla musl),darwin-x64,darwin-arm64iwin32-x64. Siódmy, uniwersalny VSIX nie ma pliku binarnego; rejestry serwują go na każdą inną platformę (Windows na Arm, 32-bitowy Linux na Arm, Alpine na arm64), gdzie rozszerzenie potrzebujeinwardswPATHalbo ustawieniainwards.path. Polefileswpackage.jsonwylicza, co trafia do pakietu, więc nic innego się nie dostanie. - Który plik binarny rusza.
inwards.path, jeśli jest ustawione, w przeciwnym razie dołączony plik binarny, a na końcuinwardszPATH. Ustawiona ścieżka, pod którą nic nie ma, to błąd; rozszerzenie nigdy nie podstawia w jej miejsce innego pliku binarnego w innej wersji. Sama nazwa w ustawieniu jest szukana wPATH, ścieżka względna liczy się od pierwszego folderu obszaru roboczego, a~i${workspaceFolder}są rozwijane. Na Windows liczy się tylko.exe, bo Node nie uruchomi.cmdani.batbez powłoki. inwards.pathto ustawienie ograniczone. W niezaufanym obszarze roboczym VS Code przekazuje rozszerzeniu tylko wartość ustawioną przez samego użytkownika, więc sklonowane repozytorium nie może wybrać programu, który rozszerzenie uruchomi.- Brak pliku binarnego to komunikat, a nie awaria. Rozszerzenie mówi, czego szukało, proponuje ustawienie i przewodnik instalacji, i czeka, aż zmieni się ustawienie albo ktoś uruchomi Inwards: Restart Server.
inwards.enablewyłącza serwer. - Publikacja to osobny workflow.
vscode-publish.ymlrusza, gdy zostanie opublikowane pełne wydanie (gdy właściciel ustawi zmiennąVSCODE_PUBLISH), pobiera siedem plików VSIX z wydania, sprawdza je względemSHA256SUMSi wersji z taga, i wysyła je przezvsce publishiovsx publish. Każde zadanie trzyma jeden token z własnego środowiska i biegnie na runnerach hostowanych przez GitHub. Wersje przedpremierowe nigdy nie trafiają do rejestrów: oba przyjmują tylkoX.Y.Z, a VSIX kandydata do wydania ma już wersję docelową. - Serwer Node rozszerzenia znika razem z testami, strefą fallow i testem CLI, który porównywał jego przejście po plikach z przejściem CLI. Rozszerzenie zależy tylko od
vscode-languageclient.
Konsekwencje.
- Instalacja z Marketplace albo Open VSX działa bez instalowania czegokolwiek innego i bez sieci przy starcie, a serwer ma zawsze wersję rozszerzenia.
- Rozszerzenie nie ma kodu do pobierania ani sum kontrolnych. Dołączony plik binarny to plik z wydania: macierz weryfikacji w
cd.ymlporównuje oba bajt po bajcie na każdym systemie i uruchamia ten dołączony, aSHA256SUMSobejmuje każdy VSIX. - VS Code, Neovim i Helix uruchamiają ten sam serwer, więc ograniczenia starego serwera (tylko konfiguracja pierwszego folderu obszaru roboczego, same INW007 i INW008 dla nieotwartych plików) znikają.
- VSIX dla platformy ma około 27 MB (skompresowany plik binarny o rozmiarze 65 MB), wobec 139 KB samego klienta, a każde wydanie niesie siedem plików VSIX, razem około 165 MB.
- Dołączony plik binarny idzie za wersją rozszerzenia. Projekt, który przypina inną wersję przez
uv add --dev inwards, ustawiainwards.pathna plik binarny ze swojego środowiska wirtualnego. - Reguły ścieżek Windows (
.exe, ukośniki wsteczne, spacje, wpisyPATHw cudzysłowach) mają testy jednostkowe z semantyką ścieżek Windows na każdym systemie; samo rozszerzenie nie startowało jeszcze na Windows, więc przed pierwszym wydaniem musi przejść pełna macierz testów i ręczna instalacja. - Wysyłka do Marketplace używa tokenu PAT, a Azure DevOps wycofuje tokeny globalne 1 grudnia 2026; przejście na Microsoft Entra ID (
vsce publish --azure-credential) to dalsza praca.
Alternatywy.
- Pobieranie pliku binarnego przy pierwszym starcie z wydania na GitHubie o wersji rozszerzenia, sprawdzane względem
SHA256SUMS: jeden mały VSIX, ale pliki prywatnego repozytorium wymagają tokenu, każdy pierwszy start potrzebuje sieci (proxy, maszyny bez dostępu do sieci), a rozszerzenie niosłoby kod do pobierania, sum kontrolnych i przechowywania. Sumy kontrolne pochodziłyby też z tego samego miejsca co plik binarny. - Jeden VSIX ze wszystkimi sześcioma plikami binarnymi: każdy użytkownik pobiera około 160 MB, żeby używać jednego z nich.
- Tylko
inwardszPATHalbo ze środowiska wirtualnego projektu: po instalacji rozszerzenie nie robiłoby nic, dopóki użytkownik nie zainstaluje też pliku binarnego. Zostaje jako ścieżka zapasowa. - Zachowanie serwera Node jako zapasu: dwa serwery, które się nie zgadzają, czyli dokładnie to, co ADR-041 miał zakończyć.
ADR-044: Copilot przez punkt wejścia inwards hook copilot i zacommitowany plik hooków
Stan: Przyjęty · 2026-10-11 · #316 · prace zaczynają się od danych wejściowych, które nagra #320
Kontekst. Przewodnik po Copilocie łączy Copilota z Inwards przez AGENTS.md, rozszerzenie edytora, inwards mcp i CI, więc Copilot nie dostaje ani config guarda, ani Stop gate. Copilot uruchamia teraz hooki agenta w czterech miejscach. Poniższe pochodzi z dokumentacji czytanej 2026-10-11: z opisu hooków GitHuba, About hooks, Using hooks with the Copilot CLI i Customize the cloud agent with hooks (żadna z czterech stron nie podaje daty) oraz z przewodnika po hookach i opisu hooków VS Code (obie z datą 2026-10-07). Nie uruchomiono żadnej sesji Copilota: na maszynie, na której przeprowadzono eksperyment, nie ma ani Copilot CLI, ani VS Code, i nigdzie się nie logowano.
| Copilot CLI | Agent w chmurze (cloud agent) | VS Code, harness Copilota | VS Code, harness Local (preview) | |
|---|---|---|---|---|
| Pliki hooków | .github/hooks/*.json, .github/copilot/settings*.json, .claude/settings*.json, ~/.copilot/hooks/, katalogi polityk, pluginy; uruchamia się każdy wpis |
tylko .github/hooks/*.json z gałęzi domyślnej; uruchamia się tylko polecenie bash |
własna implementacja Copilota (Copilot SDK), format Copilota | .github/hooks/*.json (pliki Copilota są mapowane), ~/.copilot/hooks/, .claude/settings*.json z chat.useClaudeHooks (matchery ignorowane), front matter agentów własnych; obowiązuje zaufanie do obszaru roboczego |
| Dane wejściowe | camelCase (sessionId, toolName, toolArgs) z nazwami narzędzi Copilota (edit, create, bash, apply_patch); nazwa zdarzenia w PascalCase przełącza na snake_case z nazwami narzędzi Claude'a |
jak w CLI | jak w CLI | snake_case z hook_event_name, tool_name, tool_input; nazwy narzędzi harnessu Local nie są udokumentowane |
| Odmowa edycji | permissionDecision: "deny" albo kod wyjścia 2; inny niezerowy kod też odmawia (fail-closed); przekroczenie czasu przepuszcza (fail-open, domyślnie 30 s) |
jak w CLI; ask staje się deny |
jak w CLI | hookSpecificOutput.permissionDecision albo kod wyjścia 2 z powodem na stderr |
| Po edycji | additionalContext dopisany do wyniku narzędzia, najwyżej 10 KB; bez blokady |
jak w CLI | jak w CLI | additionalContext albo decision: "block" |
| Koniec tury | agentStop: decision: "block" i reason zaczynają kolejną turę; ustawione jest stop_hook_active; CLI kończy turę po 8 blokadach z rzędu |
jak w CLI; blokada zużywa limit czasu zadania | jak w CLI | Stop: decision: "block" i reason albo kod wyjścia 2 |
| Start sesji | sessionStart, tylko additionalContext, source to startup, resume albo new |
raz na zadanie | jak w CLI | SessionStart, source zawsze new |
Każda z tych powierzchni potrafi więc odmówić wywołania narzędzia i przedłużyć turę, a tego potrzebują config guard i Stop gate. O szczegółach decydują dwie rzeczy, których dokumentacja nie podaje: nazwy argumentów edit, create i apply_patch (oraz to, czy toolArgs przychodzi jako obiekt, czy jako napis z JSON-em; poradnik CLI pokazuje napis) i nazwy narzędzi harnessu Local.
inwards hook claude-code w obecnej postaci nie obsłuży tych powierzchni, nawet tam, gdzie Copilot czyta pliki Claude Code. Copilot CLI czyta .claude/settings.local.json, który zapisuje inwards init --agent claude-code, więc w projekcie podłączonym do Claude Code już teraz uruchamia ten hook. Hook działa tam źle na trzy sposoby:
- Stop gate i sprawdzenie po edycji odpowiadają kodem wyjścia 2 i tekstem na stderr, a Copilot traktuje to jako ostrzeżenie dla użytkownika, więc tura się kończy, a model nigdy nie widzi diagnostyki;
- opis hooków dokumentuje tylko płaskie odpowiedzi, więc odmowa opakowana w
hookSpecificOutputmoże zostać zignorowana; - config guard czyta
tool_input.file_pathi przepuszcza wywołanie, gdy go nie ma (config-config guard.ts), więc jeślieditCopilota nazywa swój plikpath, edycja[tool.inwards]przechodzi niesprawdzona.
W harnessie Local w VS Code kody wyjścia znaczą to samo co dla Claude Code, ale nazwy narzędzi są inne, więc config guard widzi wywołania, których nie rozpoznaje, i je przepuszcza.
Decyzja.
- Najpierw nagranie. Hook zapisujący dane wejściowe na każdej z czterech powierzchni nagrywa
sessionStart,preToolUseipostToolUsedlaedit,create,bashiapply_patchorazagentStop, a nagrania stają się fixture'ami testów (#320). Adapter Claude Code powstał tak samo, na nagranych danych wejściowych. - Jeden punkt wejścia dla dialektów Copilota, w CLI.
inwards hook copilot(#321) czyta dane wejściowe w camelCase, w PascalCase i te z harnessu Local, rozróżniając je po samych danych: tylko te w snake_case mająhook_event_name. Wariant PascalCase Copilota i dane z harnessu Local wyglądają tak samo; co je odróżnia, ustali #320. Do tego czasu plik hooków używa nazw zdarzeń w camelCase, więc Copilot wysyła camelCase, a snake_case przychodzi tylko z harnessu Local. Każde zamienia na wywołanie, które handlery przyjmują dziś (nazwy narzędzi i argumentów Claude'a), i odpowiada w dialekcie wywołującego: odmowa to kod wyjścia 2 zpermissionDecisionna stdout i powodem na stderr, co i Copilot, i harness Local czytają jako odmowę; diagnostyka po edycji toadditionalContext; blokada Stop gate todecision: "block"z powodami bramki albo, dla harnessu Local, kod wyjścia 2 i stderr. Handlery zachowują swoją politykę i zwracają odpowiedź zamiast ją drukować, a drukuje ją punkt wejścia danego hosta. - Zacommitowany plik hooków.
inwards init --agent copilot(#322) zapisuje.github/hooks/inwards.jsonw formacie camelCase Copilota, z poleceniamibashipowershell,timeoutSec: 60iINWARDS_HOOK_HOST=copilotwenv. Agent w chmurze czyta tylko zacommitowane pliki z gałęzi domyślnej, więc plik nie zawiera ścieżki z żadnej maszyny: uruchamiainwardszPATHalbo przez launcher wskazany w--launcher(uv run). Agent w chmurze dostaje Inwards zcopilot-setup-steps.yml, jak pokazuje przewodnik. Narzędzie, którego adapter nie rozpoznaje, przechodzi, tak jak w Claude Code. - Stop gate sprawdza plik hooków, gdy
INWARDS_HOOK_HOST=copilot: bramka blokuje, gdy.github/hooks/inwards.jsonzniknął albo nie uruchamia jużinwards hook copilotdla czterech zdarzeń, tak jak robi to dla pluginu OpenCode. - Czego config guard nie umie odczytać, tego adapter odmawia. Wywołanie
apply_patch, które dotykapyproject.toml,.github/hooks/,.inwards/albo baseline'u, dostaje odmowę, tak jak w pluginie OpenCode, bo config guard ocenia edycję po jej starym i nowym tekście. inwards hook claude-codeprzestaje udawać pod Copilotem (#323): gdy nagrane dane wejściowe Copilota pokażą, że wywołującym nie jest Claude Code, hook przepuszcza i raz, na starcie sesji, mówi, żeby uruchomićinwards init --agent copilot. Dzięki temu projekt podłączony do obu nie uruchamia dwóch hooków, z których jeden działa połowicznie.
Konsekwencje.
- Sprawdzenie po edycji, config guard i Stop gate docierają do Copilot CLI i agenta w chmurze w tej samej jednej implementacji, której używają hooki Claude Code i OpenCode. W przeciwieństwie do OpenCode Copilot potrafi odmówić zakończenia tury, więc Stop gate zatrzymuje agenta przy pracy tak jak w Claude Code, także w uruchomieniu nieinteraktywnym.
- Jeden zacommitowany plik obsługuje agenta w chmurze, Copilot CLI każdej osoby w projekcie i oba harnessy VS Code.
- Plik uruchamia się na maszynie każdej osoby w projekcie. Tam, gdzie
inwardsnie jest zainstalowany, powłoka kończy się kodem 127, a Copilot odmawia każdego wywołania narzędzia (fail-closed). Polecenie najpierw sprawdza, czy plik binarny jest, i przepuszcza, gdy go nie ma, więc na takiej maszynie config guarda nie ma, a bramką zostaje CI. - Przekroczenie czasu przepuszcza wywołanie. Domyślnie to 30 s; plik ustawia 60 s, tak jak w OpenCode, a daemon hooków (ADR-039) trzyma ciepłe sprawdzenie po edycji wyraźnie poniżej tego.
- Copilot nie może blokować po edycji. Naruszenie wraca jako kontekst do wyniku narzędzia, najwyżej 10 KB, więc długi raport jest przycinany do pierwszych diagnostyk i wskazówki, żeby uruchomić
inwards check. - W agencie w chmurze blokada Stop gate zużywa czas zadania, a
sessionStartprzychodzi raz na zadanie, więc zapis sesji obejmuje całe zadanie. Limit CLI, 8 blokad z rzędu, kończy turę, której wcześniej nie zakończyłoescalate-after. - Hooki VS Code są w wersji preview, a nazwy narzędzi harnessu Local nie są udokumentowane. Dopóki #320 ich nie nagra, harness Local dostaje sprawdzenie po edycji tylko dla nazw, które nagranie obejmie, a bramką zostaje CI.
- Drugi kontrakt danych wejściowych do utrzymania, w trzech dialektach, dla API, które zmieniło się między ogólną dostępnością Copilot CLI (2026-02-25, tylko
preToolUseipostToolUse) a opisem hooków z października 2026.
Alternatywy.
- Zostać przy
AGENTS.md,inwards mcpi CI: nic do budowania, ale bez config guarda i bez bramki tam, gdzie oba są już możliwe. Zostaje to konfiguracją dla powierzchni Copilota bez hooków. - Polegać na tym, że Copilot czyta ustawienia Claude Code: bez nowego kodu, ale kody wyjścia znaczą co innego, odpowiedzi mogą zostać zignorowane, agent w chmurze nie czyta
.claude/, a config guard przepuszczałby edycje bez śladu. - Skrypt powłoki, który tłumaczy dane wejściowe Copilota na dane Claude Code i uruchamia
inwards hook claude-code, tak jak plugin OpenCode (ADR-033): tłumaczenie wymagałobyjqalbo PowerShella na każdej maszynie, a odpowiedzi i tak trzeba by tłumaczyć z powrotem. OpenCode miał do tego środowisko JavaScriptu; hook Copilota to zwykłe polecenie. - Hooki z nazwami zdarzeń w PascalCase, żeby Copilot wysyłał nazwy narzędzi Claude'a: bliżej tego, co czytają handlery, ale dokumentacja nie mówi, że zmieniane są też nazwy argumentów, a dokumentacja agenta w chmurze pokazuje tylko camelCase. Czy to prostsze, rozstrzygnie #320.
- Hooki HTTP do daemona hooków: bez procesu na każde zdarzenie, ale
preToolUsewymagahttps, lokalny adreshttpwymagaCOPILOT_HOOK_ALLOW_LOCALHOST=1na każdej maszynie, a agent w chmurze nie ma daemona, z którym mógłby rozmawiać.
ADR-045: Diagramy architektury są sprawdzane względem [tool.inwards], a nigdy nie są czytane jako konfiguracja
Stan: Przyjęty · 2026-10-11 · #332 · pierwszy etap #344 · drugi etap #345 · PlantUML #346 · hook, edytor i MCP #348 · eksport #349 · brakujące importy #347
Kontekst. Zespoły już rysują swoją architekturę: bloki Mermaid w Markdownie, które renderują GitHub, Zensical i większość edytorów, oraz diagramy komponentów w PlantUML. Rysunek rozjeżdża się z kodem i z [tool.inwards], i nikt tego nie zauważa; agenci, którzy czytają dokumentację przed pisaniem kodu, idą wtedy za błędną mapą. ArchUnitPython pokazuje, że jest zapotrzebowanie na sprawdzanie kodu względem diagramu PlantUML. Spike #332 pytał, czy diagram ma sterować sprawdzeniami, iść za nimi, czy jedno i drugie. Zdecydowały dwa niezależne spike'i i koordynator, przy zgodzie co najmniej dwóch z trzech.
Decyzja.
[tool.inwards]pozostaje jedynym źródłem prawdy. Diagram nigdy nie jest czytany jako konfiguracja w czasie sprawdzania: reguły, baseline, opis architektury (brief), edytor i MCP potrzebowałyby drugiego wejścia, a Mermaid nie wyrazi list bibliotek, selektorów, kształtów ani opcji reguł. ADR-036 ustalił ten sam wzorzec dla szablonów.- Oba kierunki. Dokumentacja idzie za kodem: inwards sprawdza oznaczone diagramy względem konfiguracji i kodu (INW017, potem INW018 i INW019). Dokumentacja steruje kodem:
inwards import-diagram FILE [--write]zamienia diagram w[tool.inwards]jeden raz, tak jakimport-config, a potem sprawdzanie trzyma oba w zgodzie. - Liczą się tylko wymienione i oznaczone diagramy. Nowy klucz
diagramswymienia pliki (ścieżki względem pliku konfiguracji, z globami). W nichflowchartalbographw Mermaid liczy się tylko wtedy, gdy zaczyna się od%% inwards: layersalbo%% inwards: contexts, więc nieoznaczony diagram procesu w zwykłej dokumentacji nie daje zgłoszeń (2 z 3). - Co znaczy diagram. Identyfikator węzła to nazwa warstwy albo kontekstu; etykieta w cudzysłowie to prefiks modułu; węzeł z klasą
externaljest pomijany; ciągła strzałka (-->) znaczy „może importować”;&i łańcuchy się rozwijają. W diagramie kontekstów subgraph to kontekst, krawędź między subgraphami todepends-on, a węzeł:::publicto wpispublic. Miejsce warstwy w kolejności to najdłuższa ścieżka do ujścia, warstwy na tym samym miejscu bez krawędzi to warstwy sąsiednie, a cykl to błąd. - Reguły. INW017
diagram-unknown-name(nazwa, której nie zna konfiguracja albo kod), INW018diagram-forbidden-edgei INW019diagram-missing-dependency(sprawdzenie całego projektu). Wszystkie są opt-in, a po włączeniu dają ostrzeżenie, więc rozjazd dokumentacji nie blokuje Stop gate, chyba że projekt podniesie poziom (2 z 3). - Miejsce w silniku. Bez nowego portu: CLI czyta pliki, które wymienia klucz
diagrams, i przekazuje{path, text}do czystego sprawdzenia, tak jak sprawdzenie prefiksów w INW006 dostaje listę modułów. Czytnik to ręcznie napisany parser linii wsrc/core/src/diagram/; parser samego Mermaida potrzebuje DOM i jison. Uruchomienie, które nie włącza tych reguł, nie czyta żadnego diagramu. - Drugi etap (#345). INW018 ocenia tylko ciągłe albo pogrubione strzałki w jedną stronę, raz na zabronioną parę i diagram. Węzeł w diagramie kontekstów należy do subgraphu najwyższego poziomu, w którym został zapisany po raz pierwszy. Warstwę albo kontekst, którego nazwa nie może być identyfikatorem Mermaid (
slices.domainz szablonu, nazwa ze spacją), nazywa węzeł, którego etykieta w cudzysłowie jest jednym z jej wpisówmodules; nazwa, która może być identyfikatorem, musi nim być, więc INW017 dalej wyłapuje w niej literówkę.import-diagramczyta najwyżej jeden diagram warstw i jeden diagram kontekstów na plik. Węzeł warstwy bez etykiety w cudzysłowie dostajemodules = []i uwagę; kontekst albo węzeł:::publicbez niej jest odrzucany, bo[[tool.inwards.contexts]]wymaga modułów. Plik tylko z diagramem kontekstów dostaje jedną warstwę,app, która obejmuje każdy kontekst. Tabela wymienia plik wdiagramsi włącza INW017 oraz INW018, więc test w obie strony (import, potem sprawdzenie) przechodzi z założenia i diagram dalej jest sprawdzany. - ArchUnitPython. „Zgodność” znaczy, że inwards czyta te same diagramy komponentów PlantUML (
component [x],[a] --> [b],..>, aliasy,package) przez ten sam model, więc przyjmą je iimport-diagram, i sprawdzanie. Bez eksportu do testów ArchUnitPython i bez metryk (3 z 3). Jego znaczenie krawędzi (bezpośrednie, nie przechodnie) zgadza się zdepends-on. - PlantUML (#346). Znacznikiem jest komentarz PlantUML,
' inwards: layersalbo' inwards: contexts, wśród linii komentarzy tuż po@startuml; liczy się każde@startuml...@endumlw pliku.puml,.plantuml,.pualbo.iumloraz blok koduplantumlalbopuml, z@startumlalbo bez. Komponent to węzeł, a pakiet (albo grupanode,folder,frame,cloudczyrectangle) to subgraph. Przy[pkg.module] as namenazwą jest alias, a modułem tekst w nawiasach, tak jak etykieta w cudzysłowie w Mermaid; komponent bez aliasu nie ma modułu. Stereotypy są klasami:<<external>>,<<public>>. Ciągła strzałka z jednym zwykłym grotem (-->,->,-up->,-[#red]->) znaczy „może importować”, a zapisana od prawej do lewej (b <-- a) jest odwracana; strzałki przerywane, bez grotu, dwukierunkowe,-[dashed]->i strzałki dziedziczenia nic nie znaczą. Wskazówki naprawy są pisane w notacji samego diagramu. Inwards czyta wszystko, co czyta parser ArchUnitPython (component [x],[a] --> [b],[a] -> [b]), co sprawdzają testy na diagramach z jego testów i README, i różni się tam, gdzie ArchUnitPython pomija linię:packagejest kontekstem, a ciągła strzałka ze stylem jest strzałką. ArchUnitPython nie ma modułów publicznych, więc przeniesiony komponent dostaje<<public>>. - Eksport (#349).
inwards diagram [--layers|--contexts] [--format mermaid|plantuml]wypisuje konfigurację jako oznaczony diagram, który INW017 i INW018 akceptują, aimport-diagramodczytuje z powrotem. Diagram warstw rysuje strzałkę z każdej warstwy do każdej warstwy o jedno miejsce głębiej: najdłuższe ścieżki oddają miejsca, a strzałka dla każdego dozwolonego importu dodałaby linie bez nowego znaczenia, bo warstwa może importować wszystko wewnątrz niej. Diagram kontekstów rysuje kontekst z modułamipublicjako grupę węzłówpublic, a kontekst bez nich jako węzeł. Warstwa z kilkoma modułami jest zapisana jako jedna linia węzła na moduł, aimport-diagramczyta każdą etykietę węzła w cudzysłowie jako jeden z jego modułów, czyli tę samą regułę co dla jednej etykiety, zastosowaną do każdego wystąpienia. Mermaid rysuje taki węzeł tylko z ostatnią etykietą; etykieta z modułami po przecinku pokazałaby wszystkie, ale zmieniłaby znaczenie etykiety w cudzysłowie dla INW017 i INW018. Alias PlantUML nazywa jeden komponent, więc eksport do PlantUML zostawia pierwszy moduł i o tym informuje.inwards contextnie dostaje diagramu: powtarzałby listę warstw z opisu architektury i wypchnąłby opis presetu fastapi ponad jego limit tokenów. -
Sprawdzanie przy edycji (#348). Sprawdzenie podanych ścieżek sprawdza podany plik, który wymienia klucz
diagrams, z listą modułów projektu dla etykiet INW017; hook PostToolUse podaje plik zmieniony przez agenta,inwards serverotwarty dokument (z niezapisanego tekstu, przy każdej zmianie), a MCPcheck_filesścieżkę albo tekst wcontents. To, czy plik jest wymieniony, rozstrzyga się na tekście ścieżki, zanim cokolwiek zostanie przeczytane, więc edycja Pythona nie czyta żadnego diagramu, a edycja innego pliku czyta tylko konfigurację. Podany plik z rozszerzeniem Markdown, Mermaid albo PlantUML, którego klucz nie wymienia, nigdy nie jest parsowany jako Python; trafia donotChecked. Domyślny zakres Stop gate (stop-gate = "changed") nie sprawdza diagramów: reguły domyślnie dają ostrzeżenia, więc nie ma czego pilnować, a gdy podniesie się je do błędów, hook PostToolUse zablokował już edycję, która zepsuła diagram.stop-gate = "project"sprawdza je wszystkie, jak dotąd. Wpis, do którego nie pasuje żaden plik, nadal zgłasza tylko sprawdzenie całego projektu, w pyproject.toml. -
Brakujące importy (#347). INW019 porównuje diagram z importami, które uruchomienie dla całego projektu zbiera dla INW004, więc uruchamia ją silnik, a nie CLI: CLI czyta pliki z
diagramsprzed sprawdzeniem i przekazuje je doEngine.check, a plik, na którym stoi zgłoszenie, a który przeczytał tylko szkielet importów, jest najpierw potwierdzany pełnym parsowaniem. Import trafia do warstwy albo kontekstu, do którego należy jego cel. W diagramie warstw rysuje go ścieżka strzałek, bo warstwa może importować każdą warstwę pod sobą; w diagramie kontekstów potrzebna jest bezpośrednia strzałka, bodepends-onnie jest przechodnie. Import podif TYPE_CHECKING:się liczy, inaczej niż dla INW004 (#375): oceniają go INW001 do INW003, a strzałka w diagramie znaczy „może importować” w ich sensie. Każda brakująca para jest zgłaszana raz na diagram, w pierwszej linii węzła, który importuje, z pierwszym importem, który za nią stoi.import-diagramnie włącza INW019, bo diagram narysowany przed kodem nie może rysować importów, których jeszcze nie ma.
Konsekwencje.
- Diagram w README jest sprawdzany jak kod: przemianowana warstwa albo przeniesiony pakiet pokazuje się jako ostrzeżenie w linii samego diagramu.
- W projekcie, który nie wymienia diagramów, sprawdzenia nie zmieniają się wcale, a projekt, który je wymienia, płaci tylko za czytanie tych plików przy sprawdzaniu całego projektu.
- Czytnik jest mały i czysty, więc silnik dalej działa na Bunie i na Node bez przeglądarki i generatora parserów.
- Czytniki obejmują podzbiór flowchartów Mermaid i podzbiór diagramów komponentów PlantUML, linia po linii; instrukcja, której nie umie śledzić, jest pomijana, więc nietypowy diagram może przejść niesprawdzony, zamiast się wywrócić.
- Warstwę albo kontekst, którego nazwa nie jest poprawnym identyfikatorem Mermaid (
slices.domainz szablonu), węzeł nazywa tylko przez etykietę w cudzysłowie równą jednemu z jej wpisówmodules. - Agent dowiaduje się o zepsutym rysunku zaraz po edycji, a edytor pokazuje zgłoszenie już w trakcie pisania diagramu.
- Edycja kodu nie sprawdza diagramów ponownie: przemianowany pakiet dociera do rysunku przy następnym sprawdzeniu całego projektu, a nie przy edycji, która zmieniła nazwę.
- Hook i edytor porównują wpisy
diagramsze ścieżką taką, jaką dostały, z wielkością liter włącznie, więc na systemie plików bez rozróżniania wielkości liter ścieżka zapisana inną wielkością liter nie jest sprawdzana przy edycji. - INW019 działa tylko przy sprawdzaniu całego projektu: jeden edytowany plik nie pokazuje importów reszty projektu, więc brakująca strzałka dociera do rysunku przy następnym sprawdzeniu całego projektu.
Alternatywy.
- Czytać diagram jako konfigurację, obok
[tool.inwards]albo zamiast niej: dwa źródła prawdy, a każdy, kto czyta konfigurację (baseline, opis architektury, edytor, MCP), potrzebowałby też diagramu. - Sprawdzać każdy blok Mermaid w repozytorium: diagramy procesów i sekwencji dawałyby fałszywe zgłoszenia, a projekt nie mógłby trzymać diagramu poglądowego.
- Użyć parsera samego Mermaida: potrzebuje DOM i środowiska jison, czyli więcej niż wszystkie zależności silnika razem.
- Domyślnie błędy: literówka w dokumentacji blokowałaby Stop gate agenta przy kodzie, który jest w porządku.
ADR-046: Porty strukturalne, linie zgodności i moduły prywatne to reguły opt-in, a wycinki CQRS to szablon
Stan: Przyjęty · 2026-10-11 · #407 · scaffoldy #406
Kontekst. Konwencje właściciela (2026-10-11) dla projektu w Pythonie: pionowe wycinki podzielone według domen, z pakietem shared/; te same nazwy modułów w każdym wycinku (models.py, api.py, services/, którego __init__.py reeksportuje z modułów prywatnych, takich jak _user.py, oraz commands/ i queries/ dla CQRS); porty to klasy typing.Protocol, nigdy ABC i nigdy dziedziczone; każdy moduł adaptera kończy się blokiem if TYPE_CHECKING: z linią _: Port = Adapter(...), żeby type checker sprawdził adapter względem jego portu. #406 wprowadza je do scaffoldów. Spike miał ustalić, których z nich inwards może pilnować i jak.
Co mówią Python i narzędzia (stan na 2026-10-11):
- Protokoły są strukturalne. Klasa implementuje protokół, gdy ma jego składowe; dziedziczenie po nim jest dozwolone, ale niepotrzebne do sprawdzania typów, a jawna podklasa dziedziczy domyślne ciała metod protokołu (specyfikacja typowania, Protocols). Podklasa protokołu jest protokołem tylko wtedy, gdy sama wymienia
Protocolwśród swoich baz; inaczej zostaje „zdegradowana” do zwykłej klasy (Merging and extending protocols). TYPE_CHECKINGma w czasie działania wartośćFalse, a statyczne type checkery przyjmująTrue(typing.TYPE_CHECKING), więc_: Port = Adapter(...)pod nim niczego nie buduje, a mimo to jest sprawdzane.- Zgodność sprawdza type checker, nie Ruff. ty zgłasza wartość, której nie da się przypisać do zadeklarowanego typu, jako
invalid-assignment; mypy i pyright mają to samo sprawdzenie. Zmienna z adnotacjątype[Proto]przyjmuje konkretną klasę, której instancje implementują protokół (type[] and class objects vs protocols). Ruff nie sprawdza typów; w tej linii zgłasza tylko niezdefiniowaną nazwę (F821). - Reguła Ruffa o prywatnych importach pomija własne moduły projektu. PLC2701
import-private-namejest w trybie preview, pomija importy względne i importy używane tylko w adnotacjach, a także każdy import, którego pakiet najwyższego poziomu jest pakietem importującego pliku (źródło). W obrębie jednego projektufrom app.users.services._user import Xwapp.ordersnigdy nie jest zgłaszane. - INW014 już sprawdza, że moduł portu zawiera tylko ABC i Protocol z metodami bez ciała, a warstwy sąsiednie INW001 (ADR-036) już zabraniają importów między rolami
a | bszablonu.
Pomiar na pięciu repozytoriach z bench/corpus.json, skryptem w Pythonie na ast (2026-10-11):
| Sprawdzenie | fastapi-clean-example | polar | full-stack-fastapi-template, python-ddd, saleor |
|---|---|---|---|
ABC w modułach ports |
0 (każdy port to Protocol) | brak modułów ports |
brak |
| Klasy poza modułami portów dziedziczące po porcie | 9 baz w 8 klasach adapterów i 1 atrapa w testach | 57 podklas Protocol, żadna z modułu portu | 0 |
Linie _: Port = Adapter(...) pod TYPE_CHECKING |
0 | 0 | 0 |
Publiczne, niewyłączone klasy w modułach adapters |
8, wszystkie to adaptery | 4: 1 adapter, 2 dataclassy, 1 model Pydantic na własnej bazie projektu | 0 |
Importy modułu _private spoza jego pakietu |
0 | 42: 32 w testach, 2 w skryptach, 8 w polar |
0 (brak modułów prywatnych) |
Moduły queries importujące commands |
0 | 0 | 0 |
Żaden projekt z korpusu nie stosuje konwencji linii zgodności, a moduły prywatne ma tylko polar; te konwencje to wybór zespołu, więc każde sprawdzenie poniżej jest opt-in.
Decyzja.
- Porty: dwie opcje INW014, bez nowego kodu.
interface = "any"(domyślnie, tak jak dziś) albo"protocol"w[tool.inwards.rules.ports-abstract]mówi, czym musi być klasa portu. Przy"protocol"ABC w module portu jest zgłaszana na swojej nazwie, podobnie jak klasa, która rozszerza port, ale sama nie wymieniaProtocol, bo type checker traktuje ją jak zwykłą klasę.allow-subclassing = false(domyślnietrue) zgłasza klasę w dowolnym miejscu poza modułami portów, która wśród swoich baz ma klasę z modułu portu; diagnostyka stoi na tej bazie. Bazy są rozwiązywane przez importy samego pliku, jak dziś w INW014, więc sprawdzenie dalej działa na jednym pliku naraz, a plik jest parsowany tylko wtedy, gdy jego szkielet importów importuje moduł portu. Moduły testów są pomijane, jak w każdej regule treści (ADR-037), więc atrapa w testach dziedzicząca po porcie przechodzi.- Komunikaty:
`OrderRepository` in port module `shop.application.ports.orders` is an ABC; ports here are `typing.Protocol` classes (`interface = "protocol"`), which adapters implement by their shape.oraz`SqlOrderRepository` in `shop.infrastructure.orders` subclasses the port `OrderRepository` from `shop.application.ports.orders`. Ports here are implemented by shape (`allow-subclassing = false`): a subclass inherits the port's default bodies, and a missing method shows up only when the adapter is built. - Poprawka: dla ABC zamienić
ABCnaProtocolwśród baz i usunąć@abstractmethod, które ma znaczenie tylko dla podklas; dla podklasy usunąć port z baz i dodać_: OrderRepository = SqlOrderRepository(...)podif TYPE_CHECKING:na końcu modułu. - Opis architektury (brief): linia INW014 mówi
`ports` modules hold only `typing.Protocol` classes whose methods have no body, a przyallow-subclassing = falsedodaje; adapters never subclass them.
- Komunikaty:
- Zgodność: nowa reguła INW020
adapter-conformance. Kategoria roles, opt-in, błąd po włączeniu. Każda publiczna klasa najwyższego poziomu (jej nazwa nie zaczyna się od_) w module adaptera potrzebuje co najmniej jednej linii zgodności w blokuif TYPE_CHECKING:(alboif typing.TYPE_CHECKING:) na poziomie modułu: przypisania z adnotacją, którego wartością jest wywołanie klasy (Adapter(...)z dowolnymi argumentami, takżeAdapter[T](...)) albo sama klasa przy adnotacjitype[Port]. Nazwa celu jest dowolna; konwencją jest_. Trzy diagnostyki:- Brak linii zgodności, na nazwie klasy:
`SqlOrderRepository` in adapter module `shop.infrastructure.orders` declares no port it implements. Add `_: OrderRepository = SqlOrderRepository(...)` under `if TYPE_CHECKING:` at the end of the module, so the type checker checks the class against its port.Port w komunikacie to jedyna klasa, którą moduł importuje z modułu portu, jeśli jest dokładnie jedna; w przeciwnym razie<Port>. Kroki poprawki: zaimportować port podif TYPE_CHECKING:; dodać linię; jeśli klasa jest pomocnicza, a nie adapterem, zmienić jej nazwę na_Namealbo przenieść ją poza moduł adaptera. - Linia zgodności, która się wykonuje, na tej linii: to samo przypisanie z adnotacją na poziomie modułu poza
if TYPE_CHECKING:buduje adapter przy imporcie. - Adnotacja, która nie wskazuje portu, na adnotacji, tylko gdy ustawiono
ports: adnotacja nie rozwiązuje się przez importy pliku do klasy w jednym z tych modułów. Bezportsliczy się każda adnotacja opróczAnyiobject. - Opcje w
[tool.inwards.rules.adapter-conformance]:modules, moduły adapterów (domyślnie moduły z segmentemadapters, tak jak INW014 domyślnie bierze segmentports);ports, selektory modułów portów;allow-bases,extend-allow-basesiallow-decoratorsz domyślnymi wartościami INW014, więc wyjątki, enumy, modele Pydantic, typed dicty, named tuple i dataclassy nie potrzebują linii;check-tests. - Czego nie sprawdza: czy klasa pasuje do portu. To zadanie type checkera i powód, dla którego linia istnieje. Klasa może implementować kilka portów, po jednej linii na każdy; INW020 wymaga co najmniej jednej.
- Koszt: jedno parsowanie na plik adaptera, którego tekst zawiera
class; żaden inny plik nie jest czytany, więc działa w hooku po każdej edycji i w edytorze. - Opis architektury:
- INW020 in `shop.infrastructure`: every adapter class ends its module with `_: Port = Adapter(...)` under `if TYPE_CHECKING:`.
- Brak linii zgodności, na nazwie klasy:
- Moduły prywatne: nowa reguła INW021
private-module. Kategoria imports, opt-in (pierwsza reguła opt-in w tej kategorii, więc zdanie „domyślnie włączone” w jej opisie dostaje wyjątek), błąd po włączeniu. Własna ścieżka modułu, której segment poniżej pakietu najwyższego poziomu zaczyna się od jednego podkreślenia (app.users.services._useralbo cokolwiek podapp.users._internal), jest prywatna dla pakietu, który ten segment zawiera (app.users.services,app.users). INW021 zgłasza jej import z każdego modułu spoza tego pakietu;__init__.pypakietu, moduły sąsiednie i podpakiety mogą ją importować. Nazwy dunder (__init__,__main__) nie są prywatne. Zbiór importów jest taki jak w INW003: zwykłe,from, względne i z gwiazdką, importy w funkcjach i podTYPE_CHECKING(taki import też wiąże importującego z prywatną ścieżką) orazfrom pkg import _x, gdypkg._xjest modułem. Import, który INW003 już zgłasza w tej samej linii, nie jest zgłaszany drugi raz.- Komunikat:
`app.orders.api` imports `app.users.services._user`, a private module of `app.users.services`. A module whose name starts with `_` is for its own package; other code imports what the package's `__init__.py` re-exports. - Poprawka: zaimportować nazwę z
app.users.servicesi reeksportować ją wapp/users/services/__init__.py, jeśli jeszcze jej tam nie ma; jeśli moduł ma służyć innym pakietom, zmienić jego nazwę na taką bez podkreślenia. - Opcje:
modules(gdzie reguła zgłasza) icheck-tests. Testy są domyślnie pomijane: 32 z 42 diagnostyk w polar to testy sięgające do prywatnych modułów workera. - Poza zakresem: prywatne nazwy (
from app.users.services import _helper, gdy_helperjest funkcją) zostają Ruffowi. PLC2701 pomija je w obrębie jednego pakietu najwyższego poziomu, a inwards nie czyta nazw modułu docelowego. Prywatne moduły bibliotek zewnętrznych też należą do Ruffa. - #331 (publiczne moduły kontekstów według konwencji podkreślenia) używa tej samej definicji prywatnego segmentu, więc obie zmiany się zgadzają, gdy działają razem.
- Opis architektury:
- INW021: import a `_private` module only from inside its package; elsewhere import what the package's `__init__.py` re-exports.
- Komunikat:
- Wycinki CQRS: szablon w presecie
vertical-slices, bez nowej reguły. Szablonslicepresetu dostajeroles = ["models", "services", "commands | queries", "api"],public = ["api"]jak dotąd irequire = ["__init__", "api"]; wpis warstwyfeaturesgo używa, więc każda rola jest warstwą, acommandsiqueriessą sąsiadami. INW001 zgłasza wtedy importcommandswqueriesi odwrotnie jako import „from sibling layer”, z komunikatem i linią opisu architektury, które INW001 już ma. Preset włącza INW021 jako ostrzeżenie, boservices/__init__.pyreeksportuje moduły prywatne. Tego, czy zapytanie coś zapisuje albo czy komenda zwraca dane, nie da się wyczytać z importów ani nazw, więc żadna reguła tego nie sprawdza. - Zmienione 2026-10-11 (#435): wpis warstwy nazywa się
slice, jak jego szablon, więc warstwy ról toslice.models,slice.services,slice.commands,slice.queriesislice.api, a niefeatures.modelsi tak dalej. Krótsze nazwy utrzymują opis architektury presetu z--scaffoldw budżecie tokenów, a wpis nadal obejmujeapp.features.*. Ten opis może mieć 350 tokenów, a nie 300, bo zawiera też linię INW021. - Presety dla portów i adapterów.
cleanihexagonalustawiają w INW014interface = "protocol"iallow-subclassing = falseoraz włączają INW020 jako ostrzeżenie, zmodulesustawionym na ich adaptery wyjściowe iportsna ich pakiet portów, tak jak dziś INW014 i INW015. Scaffoldy z #406 już stosują te konwencje, więc każdy scaffold dalej przechodzi sprawdzenie własnym presetem bez diagnostyk. - Kody. INW020 i INW021 to kolejne wolne kody (rejestr ma INW000 do INW019). Trafiają do rejestru razem z implementacją, nie wcześniej (ADR-037).
Konsekwencje.
- Każdą konwencję da się włączyć osobno, a każda diagnostyka mówi, z której pochodzi: nazwą opcji w INW014, kodem reguły w pozostałych przypadkach.
- Inwards sprawdza, że linia zgodności istnieje, a type checker sprawdza to, co ona mówi, więc żadne z narzędzi nie powtarza drugiego.
- Każde nowe sprawdzenie działa na jednym pliku naraz, więc hook po edycji, edytor i MCP zgłaszają problem przy edycji, która go wprowadziła.
- INW020 nie odróżni adaptera od klasy pomocniczej w module adaptera; klasa pomocnicza potrzebuje podkreślenia, dozwolonej bazy albo węższego
modules. W korpusie to 1 z 10 klas, które reguła by zgłosiła (model kursora w polar na własnej bazie Pydantic). - Projekt, który celowo dziedziczy po portach, jak fastapi-clean-example we wszystkich 8 adapterach, dostaje 9 diagnostyk INW014 po ustawieniu
allow-subclassing = falsei 8 diagnostyk INW020 po włączeniu INW020; specyfikacja typowania dopuszcza ten styl, więc oba sprawdzenia są domyślnie wyłączone. - INW021 jest surowsza niż praktyka samego polar: 8 importów w jego kodzie i 2 w skryptach sięga do prywatnego modułu innego pakietu.
- Gdy role wycinka stają się warstwami, komunikaty i opis architektury nazywają je
features.modelsi tak dalej, a rola, której nie ma żaden wycinek, jest pustą warstwą (INW006), jak mówi ADR-036 dla każdego szablonu.
Alternatywy.
- Nowa reguła dla portów tylko z Protocol: sprawdzenie portów, które inaczej niż INW014 rozumie, czym jest port, byłoby mylące; opcja zostawia jedną regułę i jeden zakres.
- Rozpoznawać adaptery przez dopasowanie strukturalne do portów: wymaga typów składowych z innych plików, czyli pracy type checkera; linia przekazuje tę pracę type checkerowi.
- Rozpoznawać adaptery po imporcie portu: w tej konwencji port jest importowany tylko dla linii zgodności, więc brak linii zwykle oznacza też brak importu, a reguła przeoczyłaby dokładnie ten przypadek, dla którego istnieje.
- Liczyć jawne dziedziczenie jako deklarację zgodności: specyfikacja mówi tylko, że type checker może ostrzec o składowej, której jawna podklasa nie ma, a konwencja właściciela i tak zabrania dziedziczenia.
- Moduły prywatne jako opcja INW003: INW003 wymaga kontekstów; prywatność pakietu obowiązuje w każdym projekcie, z kontekstami albo bez.
- Zostawić moduły prywatne Ruffowi: PLC2701 jest w preview i pomija każdy własny import z tego samego pakietu najwyższego poziomu, a to jest właśnie ten przypadek.
- Reguła dla
commands/queries: role sąsiednie już zabraniają tych importów, a reszty CQRS nie widać w importach.
ADR-047: TypeScript w pionowych wycinkach, przenoszony małymi PR-ami
Stan: Przyjęty · 2026-10-11 · #408
Kontekst. Właściciel ustalił konwencje dla projektów w Pythonie w #405–#407: pionowe wycinki według domen, pakiet shared/ na to, co wycinki dzielą, minidomeny wewnątrz wycinka, te same nazwy modułów w każdym wycinku, moduły prywatne za publiczną fasadą, komendy i zapytania tam, gdzie wycinek ma jedno i drugie, oraz fabryki do składania zależności. Własny TypeScript Inwards powinien się ich trzymać. Inwards nie sprawdza TypeScriptu, więc kształtu muszą pilnować strefy fallow, Biome i testy architektury. Część kodu jest już pocięta na wycinki, reszta na poziome warstwy:
| Pakiet | Już wycinek | Poziomo |
|---|---|---|
src/core |
każda reguła w rules/ (13 folderów, 7 pojedynczych plików), diagram/, baseline/, report/ |
contracts/, meta/, python/, lookup/ (używane wszędzie), config/ (opcje każdej reguły), engine/ (fasada i runner dla każdej rodziny reguł) |
src/cli |
claude-code/, session/, daemon/, lsp/, mcp/, runlog/, init/, project/ |
commands/ (17 modułów, po jednym na komendę, z każdej domeny), adapters/ (27 modułów, I/O każdej domeny), platform/, json/, paths/ |
src/vscode-extension |
src/client/ (3 pliki) |
brak |
Jedna funkcja CLI leży więc w trzech folderach: inwards server to commands/server.ts, lsp/ i adapters/lsp-connection.ts. Żaden folder nie ma też publicznej fasady: moduł może zaimportować dowolny moduł folderu, na który pozwala mu strefa. W CLI granicę folderu przekracza około 260 linii importów, w silniku około 390. Wiele PR-ów zmienia src/ naraz (reguły FastAPI w #401, scaffoldy w #406), więc przeniesienie wszystkiego w jednym PR kłóciłoby się z każdym z nich.
Decyzja.
- Docelowa mapa silnika.
index.tszostaje publicznym API.contracts/,meta/,python/ilookup/przechodzą doshared/, wspólnego jądra, którego może używać każdy wycinek.config/,diagram/,baseline/ireport/są wycinkami. Każda reguła jest folderem wrules/(7 reguł z jednego pliku staje się folderami), arules/shared/zostaje zestawem narzędzi rodziny reguł.engine/zostaje fasadą, razem z runnerami rodzin: kolejność reguł należy do silnika (src/core/AGENTS.md), a runnery używająengine/stages.tsoraz modułów INW000 i INW009, których reguła importować nie może. -
Docelowa mapa CLI.
Folder Zawiera main.ts,compose.ts,deps.ts,usage.tskorzeń: argv i cykl życia procesu, składanie zależności ( compose.tsprzechodzi wyżej zadapters/),AppDepsi tekst pomocy (zcommands/)shared/platform/,json/,paths/orazadapters/z I/O używanym przez kilka wycinków (system plików, git, runtime, stdio, TOML, gramatyki, przechodzenie po plikach, typy.d.ts)check/dzisiejszy project/, komendycheck,check-runsibaseline, adapterybaseline-filesiextraction-*,fingerprint(zsession/) iCheckRunner(zsession/contracts.ts)hook/trzy minidomeny, claude-code/,session/idaemon/, do tego komendyhookidaemonoraz adapterydaemon-*istate-files;claude-code/protocol.tsstaje sięhook/contracts.ts, który importujeeval/runlog/dzisiejszy runlog/, komendastats, adapterexport-filesinit/dzisiejszy init/, komendycontext,import-config,import-diagram,diagramiappend-table, adapteryinit-filesipickerrules/komenda rules,rule-sources,mcp/rule-page.ts, adapterrule-pageslsp/dzisiejszy lsp/, komendaserver, adapterlsp-connectionmcp/dzisiejszy mcp/, komendamcp, adaptermcp-connectionWycinki zależą od siebie w jedną stronę:
sharedpod wszystkim;checkodshared;runlog,rulesilspodcheck;mcpodcheckirules;hookodcheckirunlog;initodcheckihook.commands/iadapters/znikają. - Rozszerzenie zostaje bez zmian.src/client/to już jeden wycinek z trzema plikami. - Nazwy powtarzane w każdym wycinku.Nazwa Znaczy Pilnuje index.tspubliczna fasada wycinka lub minidomeny; tylko reeksporty wzorzec modułów prywatnych niżej; „tylko reeksporty” sprawdza review _name.tsprywatny dla folderu, w którym leży noRestrictedImportsw Biomecontracts.tsporty i rekordy, które wycinek posiada, publiczne (ta nazwa jest już w 6 folderach CLI) test nazw cli.tsobsługa inwards <komenda>w wycinku CLI, zamiastcommands/test nazw adapters/I/O wycinka CLI; importuje je tylko korzeń, a index.tswycinka nigdy ich nie reeksportujestrefy fallow; resztę obejmuje zakaz I/O w Biome <minidomena>/podfolder z własnym index.tsi tymi samymi zasadami poziom niżejtest nazw commands/,queries/zapisy i odczyty tego samego stanu, tylko tam, gdzie wycinek ma jedno i drugie i rozchodzą się: runlog/(recordwobecruns,stats,export) ihook/session/(rekord startu, kopie i świadek wobec starych błędów, wyciszeń i zmian układu); nigdzie indziejBiome: ../commands/**jest odrzucane, więcqueries/nie zaimportujecommands/create*fabryka stanu na jedno wywołanie, eksportowana z index.tswycinka (istniejącreateRunLog,createStartLookupsicreateTools)testy stanu w architecture.test.tscompose.tsjedyne miejsce, gdzie adaptery powstają i są składane ( nodePlatform,nodeDaemon,nodeLsp,nodeMcp)fallow: strefę adaptersmoże importować tylko strefa korzeniashared/to, czego używa kilka wycinków; nie importuje żadnego wycinka krawędzie stref fallow W silniku
index.tsreguły eksportuje to, co wywołujeengine/, a jej moduły prywatne zachowują dzisiejsze powtarzane nazwy (_check.ts,_wording.ts, już w 8 folderach reguł). - Jak pilnują tego narzędzia. - Biome, moduły prywatne. Każde nadpisanie, które ustawianoRestrictedImportsdlasrc/core/src/**albo plików polityki CLI, dostaje ten wzorzec:```jsonc "patterns": [ { "group": ["**/_*", "!./_*", "!../_*", "!../../_*"], "message": "A module named _x.ts is private to its folder; import the slice's index.ts." } ] ``` `./_x.ts` (ten sam folder) i `../_x.ts` (z minidomeny do jej wycinka) przechodzą; `../check/_x.ts`, `./session/_x.ts` i `../../hook/_x.ts` nie. Ten eksperyment uruchomił go na Biome 2.5.15. Biome nie łączy opcji jednej reguły z kilku nadpisań: późniejsze nadpisanie, które ustawia `noRestrictedImports`, zastępuje wcześniejsze opcje dla plików, które obejmuje, więc wzorzec powtarza się w każdym takim nadpisaniu (w dwóch: silnika, które dziś nie ustawia `noRestrictedImports`, i polityki CLI). Testy leżą poza tymi nadpisaniami, więc test jednostkowy może importować moduły prywatne wycinka, któremu odpowiada.- Biome, barrele. Grupa
performancejest na poziomie błędu, więcnoBarrelFileodrzuca każdyindex.ts, który reeksportuje. Dziś jedno nadpisanie wyłącza tę regułę dlasrc/core/src/index.ts; jegoincludesrozszerza się dosrc/*/src/**/index.ts, z uzasadnieniem, że fasada wycinka jest barrelem celowo.noReExportAllzostaje włączone, więcindex.tswymienia to, co eksportuje. - Biome, I/O. Nadpisanie polityki CLI zmienia się z listy folderów na
src/cli/src/**bezsrc/cli/src/*.ts(korzeń) isrc/cli/src/**/adapters/**, więc nowy folder dostaje zakaz I/O bez dopisywania go do listy. Nadpisanie silnika pod tym względem się nie zmienia. - Biome, komendy i zapytania. Wzorzec
../commands/**dołącza do listy, gdy zniknie własny foldercommands/CLI (ostatni import korzenia z niego przenosi się w tym samym kroku). - fallow. Jedna strefa na wycinek (
src/cli/src/check/**) i, wpisana przed nią, bo wygrywa pierwsza pasująca strefa, jedna na adaptery wycinka (src/cli/src/check/adapters/**). Strefa wycinka pozwala na strefyshared, wycinki pod nim i strefy silnika; strefa adapterów pozwala na własny wycinek,sharedi silnik; strefę adapterów może importować tylko strefa korzenia (src/cli/src/*.ts). fallow nie upilnuje modułów prywatnych: od wersji 3.31 ocenia import przez barrel według strefy modułu, który deklaruje symbol (#262), więc strefa dla plików_*.tsodrzucałaby każdy import przezindex.ts. Strefy zostają na poziomie wycinków, a specyfikator importu sprawdza Biome.requireAllFilesdalej odrzuca plik w folderze bez strefy. W silniku znikają wzorce reguł z jednego pliku (rules/x.ts), a przeniesienie jądra zmienia jego wzorce stref i listę dlaeval/w.fallow-core-api.jsonc. - Testy architektury. Sonda Biome: plik importujący
_x.tsinnego wycinka nie przechodzi, własny_x.tsprzechodzi. Test nazw: w każdym przeniesionym wycinku każdy plik toindex.ts,contracts.ts,cli.ts,_*.tsalbo*.d.ts, a każdy podfolder maindex.tsalbo jestadapters/. Lista przeniesionych wycinków w teście rośnie z każdym krokiem, więc folder jeszcze nieprzeniesiony nie zawodzi, a przeniesiony nie wróci do starego kształtu. Istniejące sondy stref i I/O dostają nowe ścieżki. check:cyclesłapie moduł prywatny, który importujeindex.tswłasnego wycinka.- Co się nie zmienia. Eksporty
@inwards/core(test/api.test.tsprzechodzi bez zmian w każdym kroku);inwards/diagnostics@1,inwards-daemon/1, kody wyjścia, flagi CLI i treść snapshotów E2E; typy kontraktów (zmieniają się tylko ich pliki); osobne chunki dla@clack/prompts, SDK MCP i stron reguł, bocompose.tszachowuje ich dynamicznyimport(), a żadenindex.tsnie reeksportuje adaptera; rozszerzenie; adresy stron reguł (zmienia się tylkoresource:w ich front matter). Zakaz I/O w silniku oraz podział CLI na politykę i adaptery zostają tak samo ścisłe. - Migracja. Piętnaście małych PR-ów, każdy zielony sam w sobie, zgłoszonych jako pod-zadania #7, z których każde czeka na kroki, od których zależy. Najpierw egzekwowanie, które niczego nie zmienia; potem wycinki, których inne PR-y dotykają najmniej; najbardziej ruchliwe foldery (
project/, hook, jądro CLI, jądro silnika) na końcu, każdy w spokojnym momencie, gdy kolejka PR-ów jest prawie pusta. PR z przeniesieniem togit mvplus przepisanie importów skryptem, więc rebase uruchamia skrypt ponownie zamiast ręcznie łączyć importy.
Krok Co się przenosi Ryzyko Rozmiar Zadanie 1 Nic: wzorce Biome, wyjątek dla barreli, nowe includesnadpisania I/O, sonda i test nazw z pustą listąniskie: tylko konfiguracja i testy S #417 2 lsp/w CLI zserverilsp-connection, pierwszycli.tsiadapters/wycinkaniskie S #418 3 mcp/w CLI zmcpimcp-connectionniskie S #419 4 rules/w CLI:rules,rule-sources,rule-page,rule-pagesniskie; po kroku 3 S #420 5 runlog/w CLI zestatsiexport-files, podzielony nacommands/iqueries/; najpierwfingerprintprzechodzi doproject/niskie S #421 6 Silnik: 7 reguł z jednego pliku staje się folderami; resource:ich stron (EN i PL)niskie S #422 7 Silnik: każdy folder reguły poza fastapi/dostajeindex.tsi nazwy z_;engine/importuje fasadyśrednie: każdy otwarty PR z regułą M #423 8 Silnik: config/,diagram/,baseline/,report/dostająindex.tsi nazwy z_średnie: około 100 linii importów M #424 9 init/w CLI z pięcioma komendami i dwoma adapterami; nazwy z_w 34 modułachśrednie; po scaleniu #406 M #425 10 Silnik: rules/fastapi/jako wycinek z minidomenąmodel/średnie; po scaleniu #401 M #426 11 project/w CLI staje sięcheck/z komendami, adapterami iCheckRunnerwysokie: około 50 linii importów, wejście wątku roboczego w main.tsi budowanie binarkiM #427 12 hook/w CLI zclaude-code/isession/(podzielonym nacommands/iqueries/);protocol.tsstaje sięhook/contracts.tswysokie: snapshoty E2E hooka i eval/M #428 13 hook/daemon/w CLI z komendądaemoni adapteramidaemon-*średnie S #429 14 shared/i korzeń CLI; znikającommands/iadapters/; wzorzec../commands/**wysokie: około 120 linii importów M #430 15 Jądro silnika do shared/wysokie: około 240 linii importów; można go pominąć osobno M #431 - Biome, barrele. Grupa
Konsekwencje.
- Funkcja CLI leży w jednym folderze:
inwards servertolsp/(polityka, obsługa komendy i adapter), a jego testy totest/lsp/. - Powierzchnią wycinka jest jego
index.ts, więc moduł prywatny można zmienić bez przeszukiwania innych folderów. - Repozytorium używa tych samych nazw, których uczą scaffoldy (#406).
- Nowy folder CLI dostaje zakaz I/O od razu, a nie dopiero gdy ktoś go dopisze.
- Około 650 linii importów zostaje przepisanych w 15 PR-ach, a otwarty PR, który zmienia przeniesiony plik, robi rebase przez zmianę nazwy.
git log --followśledzi przeniesienia; blame przez mocno zmieniony plik może się zgubić. -
.fallowrc.jsoncdostaje około 8 stref adapterów, a każda lista dozwolonych stref adaptera dalej powtarza strefy silnika. - Wzorzec modułów prywatnych powtarza się w każdym nadpisaniu Biome, które ustawia
noRestrictedImports; nowe nadpisanie bez niego wyłącza sprawdzanie dla swoich plików, a sonda obejmuje tylko foldery, które sprawdza. -
noBarrelFilejest wyłączone dla każdegoindex.ts, więc fasada wycinka kosztuje Buna tyle co barrel: import jednej nazwy ładuje cały wycinek. CLI to jeden bundle, więc liczy się tylko praca przy starcie wewnątrz wycinka, a osobne chunki zostają osobne. - Zasadę „
index.tstylko reeksportuje” sprawdza review; żadne narzędzie jej nie pilnuje. - Każdy krok zmienia też mapę kodu w rozdziale 3, przewodnik pakietu (pliki
AGENTS.mdmają jednego właściciela naraz) i, przy regułach,resource:na maksymalnie 28 stronach reguł w obu językach.
Alternatywy.
- Przenieść wszystko w jednym PR: kłóci się z każdym otwartym PR-em w
src/i wymaga jednego review około 400 plików. - Zostawić
commands/iadapters/i tylko dodać plikiindex.ts: taniej, ale funkcja dalej leży w trzech folderach. - Pilnować modułów prywatnych strefami fallow: fallow rozwiązuje import przez barrel do strefy modułu, który deklaruje symbol, więc nie odróżni barrela od bezpośredniego importu.
- „Importuj tylko
index.ts” zamiast nazw z_: bez zmian nazw, ale wzorzec Biome musiałby wymieniać jako wyjątki każdy folder jądra icontracts.ts, i różniłby się od konwencji dla Pythona. - Przenieść runnery rodzin z silnika do wycinków reguł: potrzebują
engine/stages.tsi modułów dwóch innych reguł, których reguła importować nie może. - Podzielić
meta/registry.tsna wpis w każdym wycinku reguły: rejestr jest jedną tabelą celowo (biome.jsoncmówi dlaczego), a reportery, SARIF i sprawdzanie dokumentacji czytają go w całości. - Zostawić jądro silnika na najwyższym poziomie: oszczędza około 240 linii importów, ale zostawia drugą nazwę dla tej samej idei; to ostatni krok, więc właściciel może go pominąć osobno.