Ograniczenia i jakość
Ten rozdział opisuje reguły, w których projekt musi się zmieścić, cele jakościowe, według których jest oceniany, to, co do tej pory zmierzyliśmy, i znane nam ryzyka.
Ograniczenia
| # | Ograniczenie | Dlaczego | Gdzie uwiera |
|---|---|---|---|
| C1 | Silnik w TypeScripcie | Współdzielony przez CLI, serwer języka i rozszerzenie (ADR-001) | Surowa szybkość parsowania, rozmiar pliku binarnego |
| C2 | Python parsowany tree-sitterem w wersji WASM | Przenośny między Bunem, Node i każdą platformą docelową (ADR-002) | Około 12 ms startu WASM na proces |
| C3 | Dystrybucja jako jednoplikowy program wykonywalny Buna | Bez wymagań co do środowiska; instaluje się jako zależność deweloperska (ADR-003) | Od 66 do 90 MB na plik binarny w zależności od platformy (85 MB dla Linuksa x64), prawie w całości środowisko Buna |
| C4 | Nigdy nie importuj ani nie wykonuj kodu użytkownika | Deterministyczne, bezpieczne w niezaufanych repozytoriach, bez potrzeby venv | Sprawdzić da się tylko importy dynamiczne z dosłownym celem (INW011); wyliczany cel jest w warstwach wewnętrznych zgłaszany jako niesprawdzalny, a nie rozwiązywany |
| C5 | Brak dostępu do sieci w czasie sprawdzenia | Działa offline, w piaskownicach i w zamkniętym CI | Pakiety reguł muszą być dostarczane wewnątrz pliku binarnego albo repozytorium |
| C6 | Konfiguracja w pyproject.toml pod [tool.inwards] |
Konwencja Pythona (ADR-005) | Ochrona konfiguracji wymaga hooków albo CODEOWNERS |
| C7 | Kontrakt wyjścia inwards/diagnostics@1 jest tylko rozszerzany |
Zależą od niego agenci i skrypty (ADR-007) | Zmiany nazw wymagają nowej głównej wersji schematu |
| C8 | Linux, macOS i Windows na x64 i arm64 | Tam działają agenci i CI | Obsługa ścieżek, CRLF, macierz weryfikacji wydań |
Cele jakościowe
Uszeregowane. Gdy dwa cele są w konflikcie, wygrywa wyższy.
| Pozycja | Cel | Scenariusz | Miara |
|---|---|---|---|
| 1 | Żadnych fałszywie negatywnych wyników | Agent chowa zabroniony import w funkcji, pod TYPE_CHECKING, przez ścieżkę względną albo import pakietu |
Każda forma jest zgłaszana, w tym shop . infrastructure ze spacjami, ukośnik wsteczny w nazwie, identyfikatory NFKC i aliasy warstwy przez dowiązania symboliczne. Importy dynamiczne ze stałymi celami (importlib.import_module, __import__, exec) są zgłaszane jako INW011, a wyliczane cele w warstwach wewnętrznych jako niesprawdzalne INW011. Loadery są śledzone przez aliasy, przypisania, atrybuty, functools.partial i nazwy związane wewnątrz exec, a stałe cele są zwijane; znane luki wymienia rozdział 3. Testy jednostkowe i test różnicowy prescanu (0 przeoczeń na 92 448 wygenerowanych plikach i 1921 plikach biblioteki standardowej, łącznie z importami dynamicznymi, a co noc na 6543 plikach z pięciu serwisów open source) |
| 2 | Opóźnienie w pętli agenta | Hook sprawdza jeden edytowany plik | p95 < 100 ms czasu rzeczywistego, łącznie ze startem procesu |
| 3 | Wyniki, na podstawie których agent może działać | Agent dostaje INW001 | Naprawia naruszenie w ramach jednej ponownej próby w ≥ 80 % przypadków (mierzone z design partnerami, zobacz rozdział 2) |
| 4 | Deterministyczność | To samo repozytorium, ta sama konfiguracja, dwa uruchomienia | Identyczne diagnostyki w identycznej kolejności. Zmieniają się tylko pola czasu w podsumowaniu (durationMs) |
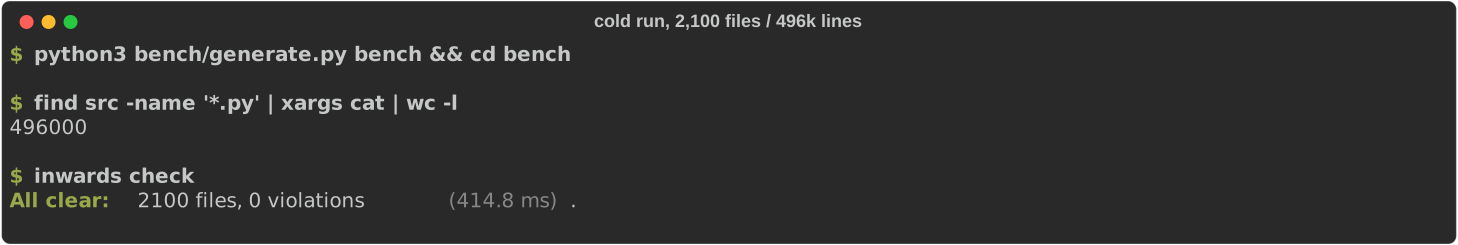
| 5 | Przepustowość dla całego repozytorium | CI sprawdza na zimno repozytorium z 500 tys. linii | 0,33 s dla syntetycznego repozytorium z 496 000 linii i 0,87 s dla 848 000 linii saleora przy czterech wątkach (#61, #281). Cel < 300 ms z wątkami i pamięcią podręczną |
| 6 | Łatwość wdrożenia | Nowy zespół, istniejący kod | Jedno polecenie podłącza agenta (inwards init). Stop gate sprawdza tylko to, co zmieniła sesja, a w zmienionym pliku tylko to, co jest nowe od początku sesji, więc stare naruszenia nie blokują; resztę obejmie baseline (UC6, #33) |
Poprawność celowo stoi wyżej niż szybkość. Zabezpieczenie, które czasem milczy, uczy agenta, że zły ruch jest w porządku, a to gorsze niż brak zabezpieczenia.
Pomiary
Wszystkie liczby pochodzą ze scaffoldu w tym repozytorium. Nic tu nie jest prognozą. Zmierzono je w M0; wyrywkowe sprawdzenie niżej pokazuje, jak się od tego czasu zmieniły.
Środowisko. Laptop, Bun 1.4.2, inwards-linux-x64 zbudowany przez scripts/build-binaries.ts. Wszystko działało w jednym wątku; wątki robocze doszły później (#61). Laptop był w zwykłym użyciu desktopowym (średnie obciążenie około 2–3), więc to liczby realistyczne, a nie najlepszy możliwy przypadek.
Syntetyczne repozytorium. 2100 plików Pythona, 496 000 linii, 8,0 MB, cztery warstwy z ośmioma importami własnego kodu i czterdziestoma małymi funkcjami na moduł. bench/generate.py odtwarza je dokładnie (stałe ziarno losowości). Z --legacy dodaje zewnętrzną warstwę legacy, którą importuje każdy moduł, więc każdy z 2000 modułów ma jedno naruszenie: to starszy kod, dla którego model kosztów z rozdziału 3 mierzy czas z pełnym baseline'em.
Bramka regresji. Każdy pull request uruchamia .github/workflows/bench.yml. Buduje gałąź bazową i PR, uruchamia oba buildy na syntetycznym repozytorium na przemian (40 uruchomień hooka na jednym pliku, 12 pełnych sprawdzeń) i kończy się błędem, gdy PR jest o ponad 20% wolniejszy w którejkolwiek metryce albo gdy którykolwiek build zawiedzie w uruchomieniu (syntetyczne repozytorium jest czyste, więc każde uruchomienie musi skończyć się kodem 0). Każda strona jest budowana z własnym .bun-version, więc mierzona jest też aktualizacja Buna. Zmiana to mediana stosunków w parach, więc obciążenie, które zmienia się w trakcie zadania, znosi się w obrębie pary. Pełne sprawdzenia działają z INWARDS_NO_CACHE=1, więc bramka mierzy samą pracę, a nie pamięć podręczną ekstrakcji. Czwarta metryka objęta bramką mierzy hook PostToolUse na wygenerowanym module z 4482 liniami i dwoma starymi naruszeniami, w osobnym małym projekcie, zmienianym przed każdym uruchomieniem tak, jak robi to edycja agenta (bench/large-file.ts, #122). Jak w pliku z polara, jego docstring wspomina o imporcie, więc prescan go odrzuca i każde sprawdzenie parsuje go w całości. Tabela tylko dla PR mierzy ten sam hook jednorazowo i przez daemona, względem budżetu 100 ms i celu 50 ms. Druga tabela, tylko dla PR i bez bramki, mierzy pełne sprawdzenie bez pamięci podręcznej, z pustą (odsuniętą przed każdym uruchomieniem) i z ciepłą. Trzecia, też tylko dla PR i bez bramki, mierzy na przemian hook PostToolUse jednorazowo i przez inwards daemon i podaje p95 daemona względem celu 50 ms z #60. Wszystkie pozostałe uruchomienia ustawiają INWARDS_DAEMON=0, więc oba buildy działają jednorazowo. Bramka obejmuje tylko czas hooka i pełnego sprawdzenia, nie pamięć, start ani rozmiar pliku binarnego. Podsumowanie zadania pokazuje p50/p95 dla obu buildów (przy 12 pełnych uruchomieniach p95 to najwolniejsze z nich) i runner, na którym działało, a surowe próbki są zachowywane jako artefakt. Lokalnie build spowolniony o 30% nie przechodzi bramki, a dziesięć uruchomień identycznych buildów ani razu jej nie oblało (bench/compare.ts, bench/test/compare.test.ts).
Korpus prawdziwych repozytoriów. Biblioteka standardowa i kod syntetyczny nie wyglądają jak serwis we FastAPI albo Django, więc .github/workflows/corpus.yml uruchamia się co noc (i przy każdym PR, który zmienia korpus albo prescan-diff.ts) na pięciu repozytoriach open source przypiętych do commitów w bench/corpus.json. bench/corpus.ts pobiera każde z nich płytko, tylko przypięty commit, a w trzech przypadkach tylko katalog serwisu (backend/, server/, saleor/; tryb sparse cone przynosi też pliki z najwyższego poziomu repozytorium), łącznie około 40 MB. Uruchamia test różnicowy prescanu na każdym pliku .py w checkoucie i mierzy czas skompilowanego pliku binarnego: 5 pełnych sprawdzeń i 20 uruchomień inwards check --no-cache <file> na jednym pliku w każdym repozytorium, po jednym rozgrzewkowym przebiegu. Uruchomienia na jednym pliku nie czytają pamięci podręcznej, tak jak hooki; do #122 czytały tę, którą właśnie wypełniły pełne sprawdzenia, co ukrywało parsowanie. Żadne z tych repozytoriów nie ma tabeli [tool.inwards], więc manifest nadaje każdemu nasz własny podział na warstwy (zapisany do inwards-corpus.toml w checkoucie i przekazywany przez --config). Liczby naruszeń wynikają z tego podziału i nic nie mówią o samych projektach. Zadanie kończy się błędem, gdy prescan pominie import, gdy liczba plików .py w checkoucie różni się od manifestu (zepsute pobieranie inaczej zmniejszyłoby korpus) albo gdy inwards check zakończy się kodem innym niż 0 lub 1. Repozytorium, którego nie da się pobrać po trzech próbach albo którego uruchomienie zawiedzie, jest odnotowywane w wynikach i oblewa zadanie; pozostałe repozytoria nadal się uruchamiają. Tabela trafia do podsumowania zadania, a surowe próbki do artefaktu corpus-result.
| Repozytorium | Licencja | Dlaczego jest w korpusie | Sprawdzane z warstwami |
|---|---|---|---|
fastapi/full-stack-fastapi-template cb740b6, backend/ |
MIT | Oficjalny szablon FastAPI, układ, od którego zaczyna wiele małych serwisów | core, services, api |
ivan-borovets/fastapi-clean-example 9271723 |
MIT | Czysta architektura na FastAPI | core, outbound, inbound, main |
pgorecki/python-ddd 429cd4b |
MIT | Modularny monolit DDD, trzy konteksty ograniczone | domain, application, infrastructure, interface |
polarsource/polar cfae1ba, server/ |
Apache-2.0 | Duży serwis FastAPI na produkcji, około 70 pakietów funkcjonalnych | kit, models, features, entrypoints |
saleor/saleor 5ff5648, saleor/ |
BSD-3-Clause | Duży serwis w Django, większy niż syntetyczne repozytorium | core, apps, api |
Pierwsze uruchomienie, na laptopie opisanym w sekcji Środowisko (średnie obciążenie 3–4), inwards 0.1.0:
| Repozytorium | Pliki .py |
Linie | Odmowy prescanu | Przeoczenia prescanu | Pełne sprawdzenie p50 / max | Jeden plik p50 / p95 | Naruszenia |
|---|---|---|---|---|---|---|---|
| full-stack-fastapi-template | 40 | 2685 | 0 | 0 | 59 / 60 ms | 46 / 51 ms | 8 |
| fastapi-clean-example | 209 | 6764 | 0 | 0 | 80 / 87 ms | 46 / 49 ms | 2 |
| python-ddd | 139 | 5852 | 0 | 0 | 82 / 87 ms | 43 / 45 ms | 10 |
| polar | 1831 | 435 688 | 22 (1,2 %) | 0 | 1,16 / 1,37 s | 124 / 142 ms | 494 |
| saleor | 4324 | 847 875 | 13 (0,3 %) | 0 | 1,84 / 1,89 s | 59 / 62 ms | 758 |
Kolumna Naruszenia pochodzi z późniejszego uruchomienia (przegląd INW010 w #45), już po dodaniu INW005 i INW010; liczba dla saleor obejmuje cztery zepsute importy znalezione przez INW010.
Dwie rzeczy, których syntetyczne repozytorium nie pokazało. inwards check na pliku subscription/service.py z polara (4482 linie, 175 KB, dwa naruszenia) trwa tu około 125 ms, a na runnerze GitHuba (AMD EPYC 7763, 2 rdzenie) 280 ms, powyżej budżetu 100 ms; mały plik z tego samego repozytorium trwa około 55 ms. Budżet dotyczy hooka Claude Code, który uruchamia to samo sprawdzenie jednego pliku (runCheck na edytowanym pliku) po odczytaniu danych wejściowych, więc hook może być tylko wolniejszy. Śledzone w #122. Ponowne lokalne uruchomienie po kompilacji do bajtkodu (#118) skróciło każde sprawdzenie jednego pliku o 20 do 40 ms: plik z polara trwa teraz 83 / 90 ms (p50 / p95), plik z saleora 27 / 30 ms. Hook na pliku z polara, który sprawdza go dwa razy, przekraczał budżet, dopóki #122 nie zaczęło parsować drugiego sprawdzenia przyrostowo (niżej). Do tego zimne pełne sprawdzenie 848 000 linii saleora trwa 1,8 s na jednym rdzeniu (2,5 s na runnerze GitHuba), podczas gdy syntetyczne repozytorium z 496 000 linii zajmuje 0,4 s.
Wyniki
| Scenariusz | Wynik | Budżet | Stan |
|---|---|---|---|
| Zimne pełne uruchomienie, naiwne pełne parsowanie (pierwsze podejście) | 7,5 s | < 1 s | odrzucone, doprowadziło do ADR-004 |
| Zimne pełne uruchomienie, szkielet importów | 0,63–1,17 s (uruchomienia z dwóch sesji) | < 1 s | na granicy |
| Ciepłe pełne uruchomienie, pamięć podręczna ekstrakcji (#56) | p50 0,46 s, wobec 1,25 s bez pamięci podręcznej w tym samym przebiegu (3,0 raza szybciej, maszyna pod obciążeniem) | nie dotyczy | |
Zimne sprawdzenie całego projektu z szukaniem cykli importów (#54, cycles = ["modules"]), po 8 naprzemiennych uruchomień z INWARDS_NO_CACHE=1, średnie obciążenie około 1,1 |
mediana 1,51 s wobec 1,35 s dla tego samego sprawdzenia bez niego; większość modułów leży w cyklicznych grupach, a każdy plik w nich jest potwierdzany (pełne parsowanie każdego trwałoby około 7 s) | < 1 s | ponad budżetem na tej maszynie, z szukaniem i bez niego; sprawdzenie punktowe poniżej, 0,40 do 0,44 s, było na nieobciążonej maszynie |
| Jeden plik, czas rzeczywisty ze startem procesu (30 uruchomień) | p50 48,6 ms, p95 80,4 ms | p95 < 100 ms | z niewielkim zapasem |
| Jeden plik, czas silnika zgłaszany przez CLI | 16 do 30 ms | nie dotyczy | |
inwards --version (sam start procesu) |
około 10 ms | nie dotyczy | |
| Indeks modułów + moduły importujące jeden moduł, na zimno, jeden rdzeń (2100 plików, świeży proces) | 0,1 s indeks + 0,65 do 0,74 s na moduły importujące (684 pliki wspominają m0: syntetyczne nazwy to najgorszy przypadek dla filtra tekstowego). Od #44 indeks niczego nie czyta z góry: jego zbudowanie trwa od 17 do 21 ms, wypisanie 2100 modułów od 25 do 32 ms, a moduły importujące czytają potrzebne im pliki, łącznie od 0,53 do 0,71 s (od 0,58 do 0,66 s dla zachłannego indeksu, który zastąpił) |
< 1 s | |
| Odmowy prescanu na bibliotece standardowej CPythona 3.14 | 8,3 % z 1921 plików | im mniej, tym szybciej | |
| Importy pominięte przez prescan na tym samym korpusie | 0 | 0 | |
| Importy pominięte przez prescan na korpusie prawdziwych repozytoriów (6543 pliki, pięć serwisów) | 0 | 0 | |
| Szczytowe zużycie pamięci, pełne uruchomienie syntetyczne | około 120 MB RSS | nie dotyczy | |
| Rozmiar pliku binarnego, Linux x64 | 82 MB | nie dotyczy | duży |
Wyrywkowe sprawdzenie na 0.1.0 (2026-09-26)
Ten sam laptop, świeży build inwards-linux-x64, średnie obciążenie około 1, zmierzone dwa razy niezależnie z tym samym wynikiem. Sprawdzenie jednego pliku w przykładowej aplikacji, 30 uruchomień: p50 37 ms, p95 40 ms czasu rzeczywistego, 14 ms czasu silnika. inwards --version: około 19 ms, wcześniej około 10 ms. Zimne pełne uruchomienie na syntetycznym repozytorium, 5 uruchomień: 0,40 do 0,44 s. Szczytowe RSS około 207 MB, wcześniej około 120 MB. Rozmiar pliku binarnego bez zmian, 82 MB (79 MiB). Opisany niżej eksperyment z bajtkodem skrócił start o połowę już po tym sprawdzeniu, a rozkład czasu startu przeliczono z jego użyciem. Benchmark w CI (#29) oblewa teraz każdy PR, który spowalnia hook albo pełne sprawdzenie o ponad 20%; nie śledzi pamięci, startu ani rozmiaru pliku binarnego.
Eksperyment: bajtkod i minifikacja
#39 pytało, czy flagi bun build --compile skracają start albo zmniejszają plik binarny. Od tego czasu scripts/build-binaries.ts buduje z --bytecode --format=esm oprócz --minify --sourcemap=linked.
Metoda. Sześć wariantów inwards-linux-x64 z jednego commitu, Bun 1.4.2, ten sam laptop co wyżej. Start: 200 rund inwards --version, każdy wariant raz na rundę w rotującej kolejności. Hook i pełne sprawdzenie: bench/compare.ts z obecnym buildem jako bazą, 100 uruchomień hooka i 20 pełnych sprawdzeń na stronę, zmiana jako mediana stosunków w parach. Szczytowe RSS: /usr/bin/time -f %M, mediana z 5 uruchomień. MB oznacza wszędzie 10^6 bajtów. Średnie obciążenie wynosiło 2 do 6 w trakcie uruchomień, więc bardziej ufaj stosunkom niż bezwzględnym milisekundom; porównanie bazy z bazą dało różnicę 0,2% (hook) i 0,6% (pełne).
| Wariant | Rozmiar (Linux x64) | inwards --version p50 / p95 |
Hook, jeden plik | Pełne sprawdzenie | Szczytowe RSS, pełne / hook |
|---|---|---|---|---|---|
Przedtem: --minify --sourcemap=linked |
82,4 MB (37,1 MB po gzip) | 22,3 / 30,9 ms | baza | baza | 202 / 54 MB |
Bez --minify |
82,6 MB | +3,0% | +3,7% | +1,5% | 203 MB pełne |
| Bez sourcemapy | 82,2 MB | -0,7% | nie uruchomiono | nie uruchomiono | |
Bez automatycznego wczytywania .env i bunfig.toml |
82,4 MB | -0,8% | -3,0% | +0,6% | 205 MB pełne |
--bytecode (CJS, domyślny w Bunie z tą flagą) |
85,0 MB | 10,0 / 14,6 ms (-56%) | -45,6% | -5,6% | 205 / 55 MB |
--bytecode --format=esm (przyjęty) |
84,9 MB (38,4 MB po gzip) | 10,5 / 14,3 ms (-53%) | -45,4% | -7,0% | 205 / 56 MB |
Powtórka z zacommitowanym buildem i domyślnymi ustawieniami bench/compare.ts (40 uruchomień hooka, 12 pełnych sprawdzeń) dała dla hooka p50 / p95 64,4 / 73,6 ms przedtem i 32,6 / 37,4 ms potem (-48,0%), a dla pełnego sprawdzenia -9,9%. Drugie uruchomienie pomiaru startu dało 25,0 ms przedtem i 10,8 ms potem. Na przykładowej aplikacji, 60 naprzemiennych sprawdzeń jednego pliku: p50 58,7 → 30,3 ms i p95 77,7 → 39,5 ms czasu rzeczywistego, a własny czas silnika spadł z 21,7 do 14,5 ms, bo silnik i klej JS web-tree-sittera też nie są już parsowane przy pierwszym wywołaniu.
- Wygrywa bajtkod. Przenosi parsowanie JS z każdego startu na czas budowania. Kosztuje 2,5 MB na plik binarny (1,3 MB po gzip) i od 1 do 3 MB RSS.
- Rozmiaru nie da się naprawić flagami. Wszystko, co dodaje Inwards, to mniej niż 1 MB (176 KB zminifikowanego JS, 0,67 MB WASM); reszta to środowisko Buna. Minifikacja była już włączona i oszczędza 0,1 MB; sourcemapa kosztuje 0,26 MB i sprawia, że stosy wywołań wskazują źródło w TypeScripcie, więc zostaje.
- ESM, nie CJS. W bezpośrednim porównaniu oba buildy z bajtkodem różnią się o +2,9% (hook) i +2,2% (pełne), w granicach szumu. ESM zachowuje semantykę modułów, którą plik binarny miał wcześniej.
- Sprawdzone. 350 testów przechodzi na skompilowanym pliku binarnym (
INWARDS_BIN=dist/inwards-linux-x64 bun test), podobnie--versioni oba osadzone pliki.wasm(każde sprawdzenie parsuje). Program testowy zbudowany w ten sam sposób wciąż podaje linię w TypeScripcie dla rzuconego błędu przez dołączoną sourcemapę. Wszystkie sześć platform docelowych kompiluje się skrośnie, a build musl sprawdza syntetyczne repozytorium wewnątrz Alpine. Macierz testów w CI buduje i testuje pliki binarne dla macOS i Windows natywnie. - Niewypróbowane. Aktualna dokumentacja Buna wymienia
--compile-jit-policyi--bytecode-order(układ bajtkodu sterowany profilem);bun buildw Bunie 1.4.2 nie ma żadnej z nich.--bytecode-depth, które 1.4.2 ma, nie zostało zmierzone. Warto do tego wrócić po aktualizacji Buna.
Na co idzie czas przy sprawdzeniu jednego pliku
Przeliczone w eksperymencie z bajtkodem, na buildzie z bajtkodem. Start procesu to inwards --version. Liczby dla gramatyki i parsowania pochodzą ze skryptu skompilowanego w ten sam sposób, który mierzy czas odczytu osadzonych plików .wasm, Parser.init, Language.load i jednego parsowania shop/domain/order.py z przykładowej aplikacji, mediana z 30 uruchomień. „Konfiguracja + I/O + reguły” to czas silnika zgłaszany przez CLI (14,5 ms) minus powyższe, a nie pomiar.
---
config:
  theme: base
  themeVariables:
    pieSectionTextColor: "#ffffff"
    pieTitleTextColor: "#6b7580"
    pieStrokeColor: "#ffffff"
    pieOpacity: "1"
    pie1: "#084e65"
    pie2: "#0b6784"
    pie3: "#2f7f99"
    pie4: "#3e4852"
    pie5: "#56616c"
    pie6: "#6b7580"
---
pie showData
    title Sprawdzenie jednego pliku, około 25 ms pracy (silnik + start)
    "Start procesu (środowisko Buna)" : 10.5
    "Inicjalizacja środowiska WASM" : 7.8
    "Wczytanie gramatyki Pythona (447 KB)" : 2.7
    "Parsowanie pliku (pierwsze parsowanie)" : 2
    "Konfiguracja + I/O plików + reguły (reszta)" : 1.5
    "Odczyt osadzonych plików .wasm" : 0.5
W M0 to samo sprawdzenie oznaczało około 30 ms pracy: 10 ms startu procesu, 12 ms inicjalizacji WASM, 3,5 ms wczytywania gramatyki, 1 ms parsowania i 3,5 ms reszty, wszystko bez bajtkodu. Parsowanie pliku to wciąż mały kawałek. Około 85% kosztu to płacenie tej samej ceny za start przy każdym wywołaniu hooka. Mediana czasu rzeczywistego, 30 ms, jest wyższa niż te 25 ms pracy, bo narzędzie pomiarowe uruchamia proces, a mechanizm uruchamiający hooki agenta też za to płaci.
To zmienia plan poprawy wydajności. W pętli agenta szybkość parsowania nie ma dużego znaczenia. Liczy się start.
Eksperyment: stały proces
#59 pytało, czy hooki i serwer języka powinny dzielić jeden stały proces i co hooki by na nim zyskały. Decyzja to ADR-039.
Metoda. Jeden laptop arm64 z macOS, Bun 1.4.2, inwards-darwin-arm64 zbudowany przez scripts/build-binaries.ts z aede2ab. Na maszynie pracowali inni agenci, więc średnie obciążenie wynosiło od 5 do 7; bardziej ufaj różnicom niż wartościom bezwzględnym. Projekt to examples/broken-app z dodanym wygenerowanym shop/domain/big.py: 4492 linie, 114 KB, dwa naruszenia INW001, blisko pliku z polara z #122 (4482 linie, dwa naruszenia). Dane wejściowe hooka to fixture PostToolUse z Claude Code skierowany na każdy z plików, po SessionStart, więc naruszenia obu plików liczą się jako stare. Każdy przypadek uruchomiono 80 razy (60 dla PreToolUse i Stop), w każdej rundzie raz, w zmieniającej się kolejności, po jednym rozgrzewkowym uruchomieniu; sprawdzenia działały z INWARDS_NO_CACHE=1. Stały proces to jednorazowy skrypt Buna uruchamiany ze źródeł, który obsługuje dzisiejsze hookClaudeCode na ciepło za gniazdem uniksowym, z Runtime dla każdego żądania i buforowanymi Streams; klient to 10-liniowy program skompilowany jak plik binarny. „Z pamięciami podręcznymi” dodaje pamięciową pamięć podręczną ekstrakcji z kluczem z treści i zachowuje na czas życia procesu odpowiedzi git cat-file blob, które wskazują commit.
| Scenariusz | p50 | p95 |
|---|---|---|
| Pusty program skompilowany jak plik binarny | 16,6 ms | 17,4 ms |
inwards --version |
15,5 ms | 16,9 ms |
| Klient z eksperymentu, gdy żaden daemon nie nasłuchuje | 13,1 ms | 14,1 ms |
inwards check na 13-liniowym order.py |
27,7 ms | 30,6 ms |
inwards check na big.py |
70,8 ms | 77,3 ms |
Te same dwa sprawdzenia na ciepło, w jednym procesie (runCheck, 200 uruchomień) |
0,8 / 29,8 ms | 1,4 / 31,3 ms |
| PreToolUse, jednorazowo | 16,8 ms | 17,6 ms |
| Stop na obu plikach, jednorazowo | 141,1 ms | 149,6 ms |
PostToolUse order.py: jednorazowo |
46,6 ms | 50,2 ms |
PostToolUse order.py: stały proces |
32,3 ms | 35,2 ms |
PostToolUse order.py: stały proces z pamięciami podręcznymi |
17,2 ms | 19,8 ms |
PostToolUse big.py: jednorazowo |
119,9 ms | 151,6 ms |
PostToolUse big.py: stały proces |
91,1 ms | 97,7 ms |
PostToolUse big.py: stały proces z pamięciami podręcznymi |
18,2 ms | 19,7 ms |
PostToolUse big.py zmieniany przed każdym wywołaniem (40 rund): jednorazowo |
117,5 ms | 122,8 ms |
PostToolUse big.py zmieniany przed każdym wywołaniem: stały proces z pamięciami podręcznymi |
47,6 ms | 50,1 ms |
- Start klienta to podłoga. Każde wywołanie hooka uruchamia proces, tu około 15 ms, zanim w ogóle dotrze do daemona. Wykrycie, że żaden daemon nie nasłuchuje, nie kosztuje nic mierzalnego.
- Jedno wywołanie gita to połowa hooka dla małego pliku. PostToolUse czyta tekst pliku ze startu sesji przez
git cat-file blob, żeby oddzielić stare naruszenia od nowych: na tej maszynie około 15 ms na wywołanie. Daemon czyta go raz na sesję. - PostToolUse sprawdza plik dwa razy, taki, jaki jest teraz, i taki, jaki był na starcie sesji: po 30 ms dla
big.py, na ciepło. Z pamięcią podręczną z kluczem z treści tekst ze startu jest parsowany raz na sesję; edytowany plik nadal kosztuje jedno parsowanie. - Rozgrzany JIT też się liczy. Jednorazowe sprawdzenie kosztuje o 27 ms więcej niż ciepłe dla
order.pyi o 41 ms więcej dlabig.py. Dodatkowe 14 ms to kod parsowania i przechodzenia drzewa, którego świeży proces jeszcze nie zoptymalizował. - PreToolUse nie może zyskać: 16,8 ms wobec podłogi 15,5 ms. Stop trwa 141 ms, ale raz na turę.
- Pamięć. Stałe procesy zajmowały po pomiarach 151 i 212 MB RSS.
- Niezmierzone: nazwane potoki na Windows, skompilowany plik binarny jako stały proces i Linux. Skrypty eksperymentu były jednorazowe i nie ma ich w repozytorium; #60 dodaje daemona do zadania benchmarku.
Daemon hooków
#60 zbudowało stały proces, który mierzył eksperyment powyżej, tak jak zdecydował ADR-039: inwards daemon obsługuje PostToolUse przez gniazdo Unix (na Windows przez nazwany potok), trzyma ekstrakcje według skrótu tekstu i odpowiedzi gita według identyfikatora commita, a wszystko inne czyta od nowa przy każdym żądaniu. Samo polecenie hooka się nie zmieniło, więc każdy PostToolUse nadal uruchamia jeden proces.
Metoda. Ten sam laptop arm64 z macOS co w eksperymencie, skompilowany inwards-darwin-arm64 z bajtkodem, średnie obciążenie 5 do 7 od innych agentów. examples/broken-app w świeżym repozytorium git z wygenerowanym shop/domain/big.py o 4492 liniach z dwoma naruszeniami INW001, po SessionStart, więc każde znalezisko jest stare, a hook czyta tekst każdego pliku ze startu z gita. Uruchomienie jednorazowe (INWARDS_DAEMON=0) i przez daemona na przemian w każdej rundzie, z INWARDS_NO_CACHE=1; 80 rund po 2 rozgrzewkowych, 40, gdy plik zmienia się przed każdym wywołaniem.
| PostToolUse | Jednorazowo p50 / p95 | Przez daemona p50 / p95 |
|---|---|---|
order.py, 13 linii |
38,0 / 39,3 ms | 15,3 / 16,2 ms |
big.py, 4492 linie |
75,7 / 81,8 ms | 16,0 / 19,2 ms |
big.py, zmieniany przed każdym wywołaniem |
76,1 / 79,0 ms | 26,8 / 36,8 ms |
- Cel jest spełniony na tym laptopie. p95 jest poniżej 50 ms w każdym przypadku, także dla dużego pliku zmienianego przed każdym wywołaniem, gdzie prototyp z eksperymentu miał 50,1 ms.
- Syntetyczne repozytorium zadania benchmarku na tym samym laptopie: 23,8 / 25,3 ms jednorazowo, 14,9 / 16,5 ms przez daemona (40 uruchomień; bez sesji, więc bez odczytu z gita).
- Pamięć. Daemon zajmował 188 MB RSS po 206 uruchomieniach hooka na obu plikach.
- Niezmierzone tutaj: nazwane potoki na Windows. CI uruchamia testy daemona na Linuksie w każdym PR; wiersze Windows i macOS uruchamiają je tylko w ręcznej pełnej macierzy przed wydaniem.
Duży plik sprawdzany dwa razy
#122 wykazało, że jednorazowy hook PostToolUse przekracza budżet 100 ms na pliku server/polar/subscription/service.py z polara (4482 linie, dwa naruszenia INW001). Hook sprawdza edytowany plik w obecnej postaci i drugi raz w postaci ze startu sesji, żeby odróżnić stare naruszenia od nowych, a plik z naruszeniem za każdym razem wymaga pełnego parsowania. Profil CPU jednego uruchomienia (95 ms) pokazał 43 ms w dwóch parsowaniach tree-sittera i 14 ms w git cat-file blob, który czyta tekst ze startu.
Co się zmieniło. Silnik przyjmuje opcjonalny TreeReuse (src/core/src/shared/python/reparse.ts), który trzyma ostatnie pełne parsowanie. Gdy następne pełne parsowanie dotyczy tej samej ścieżki, opisuje tree-sitterowi zmianę między dwoma tekstami jako jedną edycję (zakres między ich wspólnym prefiksem i sufiksem, w jednostkach kodu UTF-16) i parsuje od starego drzewa, więc od nowa parsowany jest tylko zmieniony fragment. CLI trzyma jeden taki obiekt na proces, a inwards daemon jeden na cały czas działania, więc jego następne żądanie dla tego samego pliku korzysta z poprzedniego. Jeśli nowe drzewo ma błąd składni, plik jest parsowany jeszcze raz od zera: odtwarzanie po błędzie może pójść inną drogą, gdy zaczyna od starego drzewa, i pierwsza wersja testu złapała taki przypadek. Wynik się nie zmienia: src/core/test/python/reparse.test.ts porównuje każdy węzeł ze świeżym parsowaniem na wybranych ręcznie edycjach i na 12 losowanych z ziarnem łańcuchach po 25 edycji, a jednorazowe uruchomienie na 655 plikach biblioteki standardowej CPythona 3.14, z czterema nałożonymi edycjami na plik i trzema ziarnami (7860 parsowań, około połowa z błędami składni), nie znalazło żadnej różnicy w drzewach, importach ani komentarzach wyciszających.
Metoda. Laptop arm64 z macOS i 10 rdzeniami, plik binarny darwin-arm64 z develop (ec2bd65) wobec tego, oba zbudowane przez scripts/build-binaries.ts. Na maszynie pracowali inni agenci (średnie obciążenie 4 do 10), więc stosunkom warto ufać bardziej niż milisekundom. polar na commicie z korpusu, z podziałem na warstwy z korpusu, po SessionStart, więc oba naruszenia są stare; „zmieniony” oznacza, że przed każdym wywołaniem dodano linię. Oba buildy występują na przemian w każdej rundzie, 60 rund po 2 rozgrzewkowych (40 dla wierszy z daemonem, mierzonych build po buildzie).
polar subscription/service.py |
Przed p50 / p95 | Po p50 / p95 |
|---|---|---|
| PostToolUse jednorazowo, plik niezmieniony od startu sesji | 99,8 / 101,8 ms | 84,6 / 87,5 ms |
| PostToolUse jednorazowo, plik zmieniony | 99,7 / 103,9 ms | 86,5 / 88,4 ms |
| PostToolUse przez daemona, plik zmieniony | 44,3 / 62,9 ms | 28,3 / 31,9 ms |
inwards check --no-cache na tym pliku |
60,0 / 61,6 ms | 59,2 / 61,5 ms |
- Budżet jest dotrzymany na tym laptopie na każdej ścieżce: p95 jest poniżej 100 ms jednorazowo i poniżej 50 ms przez daemona.
- Drugie parsowanie kosztuje około 3 ms zamiast około 16 ms przy edycji kilku linii, mierzone w procesie na tym samym pliku.
inwards checkjednego pliku się nie zmienia, bo parsuje raz. Pełne sprawdzenie też nie: tam żaden plik nie jest parsowany dwa razy.- Zadanie benchmarku mierzy teraz hook na module z 4482 liniami podobnym do pliku z polara (
bench/large-file.ts). Na tym samym laptopie, po 20 uruchomień: 102,0 / 104,1 ms przed, 84,1 / 89,1 ms po jednorazowo i 23,0 / 26,2 ms przez daemona. - Na runnerze CI z Linuksem arm64 (4 rdzenie), z zadań PR #299:
inwards check --no-cachena pliku z polara trwał 62 i 65 ms p50 w dwóch uruchomieniach korpusu i 128 ms w trzecim, w którym każde repozytorium działało mniej więcej dwa razy wolniej. Hook z zadania benchmarku na module z 4482 liniami przyspieszył z 117 do 101 ms p50 jednorazowo (mediana par -17%), a przez daemona trwał 19,3 / 27,4 ms. Na tym runnerze jednorazowy hook na pliku tej wielkości nadal przekracza 100 ms; przez daemona mieści się w obu celach. - Co zostaje z jednorazowego hooka: około 15 ms startu procesu, 14 ms na odczyt tekstu ze startu z gita i pierwsze pełne parsowanie.
Wątki robocze dla pełnego uruchomienia
#61 rozłożyło zimne pełne sprawdzenie na kilka wątków. Decyzję i odrzucone możliwości opisuje ADR-040.
Co działa gdzie. inwards check i inwards baseline uruchamiają wątki robocze, gdy czytają 1000 plików lub więcej: jeden wątek na 500 plików, do INWARDS_THREADS, a bez niej do połowy rdzeni ponad dwa, najwyżej 4 (o Linuksie niżej). Wątek główny liczy się jako jeden z nich. Workery robią tylko to, o czym decyduje tekst pliku: test na loader, szkielet importów oraz importy i komentarze wyciszające z pełnego parsowania. Wątek główny przechodzi drzewo, czyta pliki, uruchamia wszystkie reguły w kolejności plików i sam parsuje nieliczne pliki z importami dynamicznymi. Wynik jest identyczny co do bajtu przy dowolnej liczbie wątków, a INWARDS_THREADS=1 trzyma całe sprawdzenie w jednym wątku.
Metoda. Plik binarny darwin-arm64 zbudowany przez scripts/build-binaries.ts, bazowa kompilacja z develop (73936df) wobec tej, na laptopie arm64 z macOS i 10 rdzeniami. Na maszynie pracowali inni agenci, więc średnie obciążenie wynosiło od 4 do 7: bardziej ufaj proporcjom niż milisekundom. Każdy przypadek uruchomiono 11 razy po jednej rozgrzewce, każdy raz na rundę w zmiennej kolejności, z INWARDS_NO_CACHE=1; JSON z każdego uruchomienia musiał się zgadzać z bazową kompilacją. Prawdziwe repozytoria są sprawdzane z warstwami z korpusu (bench/corpus.json). Szczytowe RSS to /usr/bin/time -l, po trzy uruchomienia.
| Repozytorium | Pliki | Baza | Jeden wątek | Cztery wątki (domyślnie) | Osiem wątków |
|---|---|---|---|---|---|
| saleor | 4324 | 1,48 s | 1,43 s | 0,98 s (1,51×) | 1,04 s |
| polar | 1831 | 0,80 s | 0,76 s | 0,55 s (1,45×) | 0,55 s |
Syntetyczne (bench/generate.py) |
2100 | 0,52 s | 0,49 s | 0,44 s (1,17×) | 0,48 s |
Syntetyczne w trybie starszego kodu (--legacy, każdy moduł wymaga potwierdzenia) |
2101 | 2,34 s | 2,31 s | 1,14 s (2,04×) | 1,03 s |
- Jeden wątek też przyspieszył, o 2% do 5%: sprawdzenie ustala teraz rzeczywistą ścieżkę każdego pliku raz zamiast dwa razy.
- Parsowanie się skaluje, reszta nie. Przy czterech wątkach saleor spędza mniej więcej jedną trzecią czasu na przejściu drzewa, ustalaniu rzeczywistych ścieżek i czytaniu plików, zanim ruszy silnik, potem około 120 ms na regułach i 100 ms na potwierdzeniach i raporcie, wszystko w wątku głównym. Najwięcej zyskuje repozytorium w trybie starszego kodu, w którym każdy moduł wymaga pełnego parsowania.
- Więcej wątków szybko przestaje się opłacać. Każdy worker sam kompiluje gramatykę i rozgrzewa swój JIT, a obciążona maszyna ma mniej wolnych rdzeni, niż podaje. Poniżej 1000 plików wątki kosztują mniej więcej tyle, ile oszczędzają: 537 plików saleora trwało 207 ms w jednym wątku i 218 ms w trzech.
- Pamięć. Szczytowe RSS saleora wzrosło z około 360 MB w jednym wątku do około 520 MB przy czterech i 615 MB przy ośmiu.
- Pamięć podręczna i hooki. Sprawdzenie z ciepłą pamięcią podręczną się nie zmieniło (0,95 → 0,91 s na saleorze), uruchomienie, które wypełnia pustą pamięć podręczną, przyspieszyło (2,6 → 2,05 s), a
bench/compare.tszmierzył hook i sprawdzenie PreToolUse nowego pliku w granicach 3% od bazy, pełne sprawdzenie o 20,5% szybsze. -
Linux, i dlaczego domyślnie zostają wolne rdzenie. Pierwsze uruchomienie zadania benchmarku w CI, na runnerze Linux arm64, który podaje 4 rdzenie, zmierzyło pełne sprawdzenie repozytorium syntetycznego o 59% wolniejsze przy czterech wątkach. Plik binarny linux-arm64 w kontenerze Ubuntu 24.04 na tym samym laptopie, przypięty do czterech albo ośmiu rdzeni (
--cpuset-cpus), po pięć uruchomień, dał takie mediany:Rdzenie Repozytorium 1 wątek 2 3 4 4 syntetyczne 0,42 s 0,44 s 0,53 s 0,67 s 4 syntetyczne w trybie starszego kodu 2,28 s 2,33 s (1,67 do 2,34) 1,54 s 1,77 s 8 syntetyczne 0,42 s 0,38 s 0,40 s 0,44 s 8 syntetyczne w trybie starszego kodu 2,30 s 1,68 s 1,38 s 1,23 s Każdy wątek uruchamia własną maszynę wirtualną JavaScriptu, a jej kompilator JIT i odśmiecacz działają w osobnych wątkach, więc wątek na rdzeń głodzi wątek główny. Przy dwóch wątkach domyślnie na tym runnerze zadanie benchmarku nadal mierzyło pełne sprawdzenie repozytorium syntetycznego o 19% wolniejsze. Teraz domyślnie jest połowa rdzeni ponad dwa, najwyżej 4: jeden wątek na 4 rdzeniach, trzy na 8 i cztery od 10, jak na laptopie wyżej. - Niezmierzone: hostowany 4-rdzeniowy runner
ubuntu-latestGitHuba i Windows.
Szeregowa część pełnego uruchomienia
Przy czterech wątkach saleor spędzał mniej więcej jedną trzecią zimnego sprawdzenia w wątku głównym, zanim ruszył silnik: na przejściu drzewa, ustalaniu rzeczywistych ścieżek i czytaniu plików. #281 skróciło tę część. Wynik jest identyczny co do bajtu, a przejście drzewa znajduje te same pliki pod tymi samymi nazwami modułów.
Co się zmieniło.
- Jedna rzeczywista ścieżka na katalog, nie dwie na plik. Przejście drzewa ustala
realpathkażdego katalogu i każdego dowiązania symbolicznego. Zwykły plik dostaje rzeczywistą ścieżkę swojego katalogu i nazwę, którą zwróciłreaddir: plik, który nie jest dowiązaniem, nie dokłada żadnego dowiązania, więcrealpathpowtórzyłby tylko to, co przejście już ustaliło. Sprawdzenie używa potem tych ścieżek zamiast ustalać każdy plik jeszcze raz. Na saleorze przejście drzewa skróciło się z około 114 ms do 30 ms, a druga rundarealpath(około 75 ms) zniknęła. - Pliki są czytane jedną partią. Sprawdzenie 1000 plików lub więcej prosi o wszystkie pliki naraz (
fs.promises.readFile), więc odczyty czekają na dysk razem: 4324 pliki saleora w około 55 ms zamiast 90 ms. Mniejsze sprawdzenie i każdy hook czytają pliki po kolei, jak dotąd. - Workery startują przed czytaniem. Sprawdzenie liczy pliki, zanim je przeczyta, więc pula startuje pierwsza i workery ładują gramatykę, gdy wątek główny czyta.
- Każdy worker trzyma dwie partie. Worker, który skończył partię, czekał dotąd, aż wątek główny, zajęty własną partią, wróci do pętli zdarzeń i wyśle mu następną. Teraz następna już czeka w jego kolejce.
Metoda. Jak dla wątków roboczych wyżej: plik binarny darwin-arm64, 11 uruchomień na kompilację po jednej rozgrzewce, w rotacyjnej kolejności, z INWARDS_NO_CACHE=1, a JSON każdego uruchomienia porównany z pozostałymi. Bazy to jednowątkowa baza z #61 (73936df) i develop przed tą zmianą (3dc5489, cztery wątki). Na tym samym laptopie pracowali inni agenci (średnie obciążenie od 5 do 11).
| Repozytorium | Pliki | Baza #61 (jeden wątek) | develop (cztery wątki) |
Teraz (cztery wątki) | Teraz (jeden wątek) |
|---|---|---|---|---|---|
| saleor | 4324 | 1,59 s | 1,09 s | 0,87 s | 1,31 s |
| polar | 1831 | 0,79 s | 0,57 s | 0,47 s | 0,67 s |
Syntetyczne (bench/generate.py) |
2100 | 0,51 s | 0,43 s | 0,33 s | 0,40 s |
Syntetyczne w trybie starszego kodu (--legacy) |
2101 | 2,47 s | 1,23 s | 1,03 s | 2,34 s |
Baza z #61 mierzyła na saleorze od 1,48 do 1,62 s w sześciu sesjach tego dnia, a ta zmiana od 0,74 do 0,87 s przy czterech wątkach: od 1,83× do 2,00×, z medianą 1,93×. Dwukrotne przyspieszenie, o które prosiło #281, jest więc na granicy, a nie wyraźnie osiągnięte. Wszystkie uruchomienia każdej kompilacji dały ten sam JSON.
Każda zmiana osobno. Kompilacje, z których każda pomija jedną zmianę, na saleorze, po 11 uruchomień (średnie obciążenie od 7 do 16): wszystkie cztery 744 ms; bez rzeczywistych ścieżek z przejścia drzewa 861 ms, bez czytania partią 812 ms, z pulą startowaną po czytaniu 776 ms, z jedną partią na workera 794 ms.
Co się nie opłaciło i zostało usunięte.
- Listowanie dowiązań w warstwach, gdy odczyty czekają. macOS szereguje wywołania systemu plików: przejście po dowiązaniach trwało w trakcie odczytów od 76 do 102 ms zamiast 21 ms po nich, a suma się nie zmieniła.
- Uruchamianie workerów na plikach w miarę ich czytania. Wolne workery liczyły szkielety każdej porcji 256 plików zaraz po jej przeczytaniu, a wywołanie silnika używało odpowiedzi na identyczne zadania. Saleor 775 → 792 ms, polar 475 → 478 ms, repozytoria syntetyczne w granicach 1%: żaden zysk wart drugiej kolejki w puli.
- Mniej wywołań
realpathna katalogach. Przejście drzewa ograniczareaddir: 23 ms z nimi i bez nich.
Linux. Plik binarny linux-arm64 w kontenerze Ubuntu 24.04 na tym samym laptopie, po siedem uruchomień. Przypięty do czterech rdzeni, gdzie domyślnie działa jeden wątek, nic się nie zmieniło: saleor 1,24 s przed i po, polar 0,68 s, repozytorium syntetyczne 0,42 s, w trybie starszego kodu 2,27 s. Linux tanio odpowiada na realpath i odczyty plików ze swoich pamięci podręcznych, więc usunięta szeregowa część była kosztem macOS. Przypięty do ośmiu rdzeni (trzy wątki) saleor przyspieszył z 0,92 do 0,87 s, a repozytorium w trybie starszego kodu z 1,43 do 1,37 s. Trzykrotne przyspieszenie na 4 vCPU, o które prosiło #61, pozostaje poza zasięgiem: maszyna z 4 rdzeniami zostaje przy jednym wątku, a ten wątek spędza czas na parsowaniu i regułach.
Co zostaje w wątku głównym. Zmierzone ze źródeł na saleorze przy czterech wątkach: około 45 ms na przejście drzewa i nazwanie plików, 70 ms na ich przeczytanie, potem silnik: 260 ms na partię szkieletów (dzieloną z workerami), 127 ms na skany, 135 ms na partię pełnych parsowań (dzieloną), 60 ms na potwierdzenia i raport oraz 33 ms na kontrole całego uruchomienia. Skany i potwierdzenia to reguły, które z założenia zostają w jednym wątku (ADR-040).
Precyzja reguł opt-in
Reguły treści opt-in (od INW012 do INW016, od FAPI001 do FAPI009) weszły z testami tylko na przykładach. #182 włączyło je na pięciu repozytoriach korpusu w przypiętych commitach, ręcznie oceniło zgłoszenia, poprawiło największe klasy fałszywych alarmów i zmierzyło czas każdej reguły.
Metoda. Każde repozytorium działało z warstwami z manifestu i select wszystkich reguł opt-in. INW015 potrzebuje roli, więc fastapi-clean-example dostało role = ["app.outbound"], allowed-in = ["app.main"], a python-ddd role = ["modules.*.infrastructure", "seedwork.infrastructure"], allowed-in = ["config", "api.main", "cli"]. Routery Polara pochodzą z klasy budowanej w czasie działania (#358), więc INW012 widziało jeden z jego 450 endpointów, dopóki drugie uruchomienie nie dodało decorators = ["polar.*.router.get", "polar.*.router.post", "polar.*.router.patch", "polar.*.router.put", "polar.*.router.delete"]. Zgłoszenie jest trafne, gdy to, co twierdzi, jest prawdą i czytelnik strony reguły chciałby je poprawić; zgłoszenie prawdziwe co do litery, ale niewarte poprawki, takie jak health check, który pinguje bazę, liczy się jako fałszywe. Gdy reguła miała więcej zgłoszeń, niż dało się przeczytać, obejrzane zostało co piąte.
| Reguła | Zgłoszenia przed → po | Obejrzane | Precyzja przed → po | Poprawka w #182 |
|---|---|---|---|---|
INW012, Polar z decorators |
108 → 73 | 22 przed, 25 po | 36 % → 68 % | każde raise to warunek ochronny; opcje ładowania nie są zabronionymi wywołaniami |
| INW012, pozostałe repozytoria | 4 → 4 | wszystkie | 3 z 4 | niepotrzebna |
| INW013 | 1 → 1 | wszystkie | 1 z 1 | niepotrzebna |
| INW014 | 0 → 0 | n/d | n/d | niepotrzebna |
| INW015 | 48 → 17 | wszystkie | 31 % → 88 % | klasy wyjątków z roli nie są zgłaszane |
| INW016 | 173 → 152 (55 po #361) | każde zgłoszenie kolumny i nazwa tabeli | 88 % → 100 % względem domyślnego schematu | migracje Alembica nie są czytane |
| FAPI001 | 22 → 21 | wszystkie | 86 % → 90 % | aplikacja z openapi_url=None nie ma schematu |
| FAPI002 | 18 → 17 | 8 | wszystkie trafne | ta sama |
| FAPI007 | 4 → 0 | wszystkie | 0 % → brak zgłoszeń | generator z dwoma yield albo yield w pętli to strumień |
| FAPI003, FAPI005, FAPI006, FAPI008, FAPI009 | 0 → 0 | n/d | n/d | niepotrzebna |
Czym były fałszywe alarmy i co zostało:
- INW012. 8 z 14 fałszywych alarmów pierwszej próby to warunki ochronne, które rzucają błędy samego projektu (
raise ResourceNotFound(), mapowane na 404 przez handler wyjątków całej aplikacji); liczenie ich jako warunków ochronnych kosztowało jedno trafne zgłoszenie, regułę biznesową zapisaną jako dwa warunki. 3 w obu próbach to pojedynczejoinedload(...)przekazane repozytorium. Zostały: HTML renderowany na serwerze w zagnieżdżonych blokachwith(46 z 73 zgłoszeń leży w back office Polara), handlery formularzy HTMX, health checki i webhook (#360). Domyślne progi się sprawdziły: tylko 3 z 73 zgłoszeń przekraczają jeden sygnał o najwyżej 2 instrukcje, 1 gałąź albo 1 poziom. #360 zaczęło potem liczyć drzewo blokówwithze znacznikami jako jedną instrukcję,ifalboexcept, który pokazuje jeden komunikat i zwraca, jako warunek ochronny, i pomijać health checki. Przy rozpoznanym każdym routerze Polara (#358) zmniejszyło to liczbę zgłoszeń w Polarze ze 135 do 109, a w próbie co piątego z 10 trafnych z 27 (37 %) do 10 z 22 (45 %), bez utraty trafnego zgłoszenia; Saleor zachował swoje 2 (strona INW012 podaje każdą zmianę osobno). Progi zostają: z 12 pozostałych fałszywych alarmów 2 przekraczają limit o najwyżej 2 instrukcje, a podniesieniemax-statementsdo 12 usunęłoby te 2 i żadnego trafnego zgłoszenia z próby, czyli za mało, żeby zmieniać wartość domyślną. - INW015. 31 z 48 zgłoszeń to import klasy wyjątku z adaptera, żeby zmapować go na status HTTP. Została stała importowana z adaptera. Drugim fałszywym zgłoszeniem był moduł testów; od #362 reguły treści pomijają moduły testowe, więc zostaje 16 zgłoszeń, z czego 15 trafnych.
- INW016. 21 zgłoszeń powtarzało kolumnę modelu w migracji Alembica. Pozostałe 152 są poprawne względem domyślnego schematu, ale 98 z nich to mnogie nazwy tabel Polara, 94% z jego 104. #361 zgłasza taki schemat raz przy uruchomieniu dla całego projektu i podaje
table-name = "snake": Polar spadł ze 121 zgłoszeń do 24, a korpus ze 152 do 55. 26 zgłoszeń Saleora zostaje: 46 z jego 72 kolumn z datą i czasem kończy się na_at, więc jegodate_joinedistart_dateto mieszanka, a nie schemat. 13 zgłoszeń kolumn nie podpowiada już nazwy złożonej tylko ze słów o czasie (date_at,timestamp_at), adate_of_birthdostaje terazbirth_date. - FAPI001, FAPI002. Back office Polara to aplikacja
FastAPI(openapi_url=None). Dwóch zgłoszeń FAPI001 na aplikacjach testowych w Polarze nie ma od #362, więc zostaje 19, wszystkie trafne. Obie reguły widziały w korpusie około 40 endpointów, bo routery Polara i fastapi-clean-example nie były rozpoznawane (zob. niżej). - FAPI007. Wszystkie 4 zgłoszenia to strumienie (zdarzenia wysyłane przez serwer w Polarze, iterator rabatów w Saleorze), nie zależności.
Routery budowane w czasie działania. #358 nauczyło model FastAPI i INW012 routerów, których powyższe uruchomienie nie widziało: APIRouter = get_api_router_class(APIRoute) i BackofficeRouter = get_api_router_class(TransactionalAPIRoute) w Polarze oraz tras zadeklarowanych w fabrykach make_*_router() -> APIRouter w fastapi-clean-example. Nazwa jest rozwiązywana przez importy projektu, zamiast ufać każdemu wywołaniu czegoś o nazwie APIRouter, bo projekty OpenStack tak nazywają swoje routery WSGI (strony reguł wymieniają, co się liczy). Ta sama metoda, ponowione 11 października 2026 względem develop w a8c282a, który pomija moduły testowe (#362); operacje ścieżki są liczone poza testami:
| Reguła, repozytorium | Widoczne operacje ścieżki | Zgłoszenia przed → po | Obejrzane | Precyzja po |
|---|---|---|---|---|
| FAPI001, Polar | 1 → 526 | 0 → 131 | wszystkie sklasyfikowane; 35 na trasach publicznych przeczytane | 25 ze 131 (19 %); 25 z 35 na trasach publicznych (71 %) |
| FAPI001, fastapi-clean-example | 4 → 15 | 0 → 0 (11, zanim description= zaczęło się liczyć jak docstring) |
wszystkie | brak zgłoszeń |
| FAPI002, Polar i fastapi-clean-example | jak wyżej | 0 → 0 | n/d | n/d |
INW012, Polar (bez decorators) |
1 → 526 | 1 → 135 | 27, co piąte | 10 z 27 (37 %) |
| INW012, fastapi-clean-example | 4 → 15 | 0 → 0 | n/d | brak zgłoszeń |
| FAPI003, Polar | jak wyżej | 0 → 0 (72 ostrzeżenia przed poprawką opisaną niżej) | wszystkie | n/d |
| FAPI005, Polar | jak wyżej | 0 → 0 (2 przed poprawką opisaną niżej) | wszystkie | n/d |
full-stack-fastapi-template i python-ddd się nie zmieniły, a Saleora nie uruchamiano ponownie. Czym są nowe zgłoszenia:
- FAPI001. 96 ze 131 zgłoszeń w Polarze dotyczy tras z tagiem
APITag.private, które klasa tras Polara trzyma poza schematem produkcyjnym (czytane od #392, niżej). Z 35 na trasach publicznych 10 to fałszywe alarmy: 4 eksporty CSV i 6 endpointów OAuth2, których treść odpowiedzi definiują RFC. 11 zgłoszeń w fastapi-clean-example to trasy zdescription=getdoc(...); FastAPI czyta docstring tylko wtedy, gdy nie madescription=(Path Operation Configuration), więcdescription=liczy się teraz jak docstring. Router, który każde śledzone dołączenie umieszcza pod aplikacjąFastAPI(openapi_url=None), pozostaje ukryty, gdy innego dołączenia nie da się prześledzić; bez tego back office Polara dodałby 115 fałszywych alarmów. - FAPI002. Nadal milczy w obu: Polar dołącza swój router API przez parametr
add_versioned_routers(app, api_router, ...), a część routerów przez wywołania fabryk, fastapi-clean-example zaś dołącza każdy router przez wywołanie fabryki, więc dołączenia nad ich trasami są nieznane. #391 je śledzi (niżej). - INW012. 107 ze 135 zgłoszeń w Polarze leży w back office; 17 fałszywych alarmów w próbie to 15 stron renderowanych na serwerze i handlerów formularzy HTMX w back office, strumień zdarzeń wysyłanych przez serwer i webhook (#360).
- FAPI003, FAPI005. Rozpoznanie większej liczby routerów najpierw dodało fałszywe alarmy: FAPI003 ostrzegało, że 72 routery Polara są niepodpięte, bo te same nieznane dołączenia ukrywają, jak są podpięte (śledzone od #391, niżej), a FAPI005 zgłaszało 2 trasy, które klasa tras Polara rozdziela według wersji API (#392). Router zbudowany przez własną klasę albo fabrykę jest teraz dla obu reguł nieznany: FAPI003 go pomija, dopóki dołączenie, którego nie umie prześledzić, mogłoby dołączyć jego albo router nad nim (wywołanie fabryki tylko routery, które ta fabryka zwraca, każdy inny cel dowolny router), a FAPI005 nie czyta kolejności jego tras. Routery z konstruktora FastAPI zachowują wcześniejsze odpowiedzi.
Koszt, ze źródeł na laptopie opisanym wyżej, mediana 3 zimnych uruchomień na Polarze z jedną regułą: INW012 1118 → 1401 ms, FAPI001 1195 → 1457 ms, FAPI002 1188 → 1725 ms (baza: develop w c38c5ae), za 525 operacji ścieżki więcej, które każda reguła teraz czyta.
Dołączenia przez parametry i fabryki. #391 śledzi jeden krok własnego kodu: app.include_router(api_router) wewnątrz funkcji, do tego, co przekazuje każde wywołanie tej funkcji, oraz include_router(make_router()), do routera zwracanego przez fabrykę (strona FAPI003 opisuje zasady). Ta sama metoda; Polar, fastapi-clean-example i full-stack-fastapi-template uruchomione ponownie 2026-10-11 na develop w cf127b7 z włączonymi FAPI001 do FAPI009:
| Repozytorium | Nieśledzone dołączenia, przed → po | Routery z trasami, których nie osiąga żadna aplikacja | Zgłoszenia przed → po |
|---|---|---|---|
| Polar | 6 → 0 | 0 | FAPI001 131 → 131, FAPI002 0 → 1, FAPI003 i FAPI005 0 → 0 |
| fastapi-clean-example | 16 → 0 | 0 | brak przed i po |
| full-stack-fastapi-template | 0 → 0 | 0 | bez zmian (FAPI001 13, FAPI002 16) |
- FAPI003. Gdy każde dołączenie jest śledzone, FAPI003 ocenia 72 routery Polara, zamiast pomijać je jako nieznane, i każdy osiąga jakaś aplikacja: żadnego zgłoszenia i żadnego z 72 fałszywych ostrzeżeń „niepodpięty”, które przebieg #358 pokazywał przed swoją poprawką.
- FAPI001. Śledzenie
add_versioned_routers(app, api_router)umieszcza trasy API Polara podFastAPI(openapi_url=None)zcreate_app(), co ukryło wszystkie 131 zgłoszeń.openapi_url=Nonewyłącza tylko serwowanie schematu przez FastAPI; Polar sam serwuje/{version}/openapi.jsonz tych samych tras. Aplikacja, która dodaje własną trasę kończącą się naopenapi.json, liczy się teraz jako serwująca schemat, co przywraca tych samych 131 zgłoszeń, a back office Polara (bez takiej trasy) pozostaje ukryte. - FAPI002. Jedyne zgłoszenie w Polarze jest trafne: OAuth2
authorizerzuca 401 i nie deklaruje żadnych odpowiedzi. Większość pozostałych jego tras rzuca podklasyPolarError, obsługiwane przez handlery rejestrowane wadd_exception_handlers(app), na parametrze, którego FAPI002 nie śledzi, i odpowiadająceexc.status_code(#400). Routery fastapi-clean-example buduje fabryka wokół zewnętrznegoErrorAwareRouter, którego argumenty kluczowe są nieznane, a więc i deklarowane odpowiedzi.
Koszt: 9 zimnych uruchomień na Polarze ze wszystkimi regułami FAPI, na przemian z develop w 9ac26f7 (po #402): mediana 1565 ms przed i 1619 ms po, najszybsze uruchomienie 1466 i 1487 ms, w granicach szumu tego laptopa. Szukanie wywołań funkcji w projekcie parsuje tylko pliki, które zawierają jej nazwę.
Klasy tras. #392 czyta, co robi klasa tras routera, z route_class= albo z własnej klasy routera, która ją ustawia (zasady opisują strona FAPI001 i FAPI005). Zgłoszenie rozważało trzy opcje: opcję reguły z tagami, które wykluczają trasę ze schematu, traktowanie każdej własnej klasy tras jako nieznanej albo zostawienie tego modules i wyciszeniom. Czytanie kodu samej klasy nie wymaga konfiguracji i milczy wszędzie tam, gdzie klasy nie da się odczytać, więc to weszło. Ta sama metoda, Polar z #391:
| Reguła, Polar | Zgłoszenia przed → po | Obejrzane | Precyzja przed → po |
|---|---|---|---|
| FAPI001 | 131 → 30 | wszystkie | 19 % → 67 % (20 z 30) |
| FAPI002 | 1 → 1 | wszystkie | 1 z 1 |
| FAPI005 | 0 → 0 | nie dotyczy | nie dotyczy |
- FAPI001.
IncludedInSchemaAPIRoutePolara ustawiainclude_in_schemanasettings.is_development()dla trasy z tagiemAPITag.private, naTruedlaAPITag.publici naFalsew pozostałych przypadkach, sprawdzając najpierw tag prywatny. Wszystkie 101 zgłoszeń, które zniknęły, dotyczy tras prywatnych: 96 policzonych wyżej i 5, które przebieg #358 zaliczył do publicznych, a które majątags=[APITag.private]w dekoratorze pod publicznym routerem. Pozostałe 10 fałszywych alarmów to te same 4 eksporty CSV i 6 endpointów OAuth2, których treść odpowiedzi definiują RFC. 77 routerów API Polara czyta się jako „schemat według tagów”; pozostałe 22 aplikacje i routery używają ustawień domyślnych FastAPI. - FAPI005. Klasa tras 77 routerów API zawiera
VersionedAPIRoute, która nadpisujematches, więc ich kolejność nadal nie jest czytana, a 2 pary rozdzielone według wersji wwebhook/endpoints.pypozostają ciche. Wcześniej nie czytano kolejności żadnego routera zbudowanego przez własną klasę (#358). Teraz czytane są też routery back office, których klasą tras jestTransactionalAPIRoute(tylko opakowuje handler), bez zgłoszeń. 3 pary ztests/kit/test_versioning.pyleżą w module testowym, który warstwy korpusu pomijają. - fastapi-clean-example i full-stack-fastapi-template się nie zmieniły: ich routery używają klasy tras FastAPI albo pochodzą z fabryk.
Koszt. Każda reguła osobno, oprócz warstw z manifestu, zimne (--no-cache) i ciepłe uruchomienie, mediana z 5 uruchomień (3 dla polara i saleora), plik binarny darwin-arm64 na opisanym wyżej laptopie, przy pracujących równolegle innych agentach (load average 5 do 11). Milisekundy, zimne / ciepłe:
| Reguła | template | clean-example | python-ddd | polar | saleor |
|---|---|---|---|---|---|
| żadna | 44 / 34 | 75 / 55 | 82 / 77 | 603 / 501 | 931 / 1 034 |
| INW012 | 79 / 79 | 93 / 84 | 91 / 83 | 1 119 / 955 | 1 284 / 1 117 |
| INW013 | 43 / 38 | 115 / 116 | 113 / 113 | 7 826 / 7 246 | 954 / 924 |
| INW014 | 42 / 34 | 77 / 60 | 82 / 80 | 592 / 499 | 923 / 907 |
| INW015 | n/d | 105 / 106 | 113 / 125 | n/d | n/d |
| INW016 | 49 / 44 | 80 / 61 | 90 / 88 | 778 / 619 | 1 187 / 1 251 |
| FAPI001 | 79 / 79 | 81 / 88 | 109 / 105 | 1 299 / 1 173 | 1 357 / 1 319 |
| FAPI002 | 89 / 89 | 88 / 81 | 109 / 108 | 1 426 / 1 180 | 1 481 / 1 475 |
| FAPI007 | 65 / 64 | 81 / 75 | 91 / 91 | 1 326 / 1 197 | 1 362 / 1 490 |
| wszystkie reguły opt-in | 130 / 130 | 175 / 189 | 178 / 171 | 9 299 / 9 157 | 2 089 / 2 189 |
Pozostałe reguły FAPI kosztują mniej więcej tyle co FAPI001. Kolumna ciepła prawie się nie różni, bo pamięć podręczna ekstrakcji trzyma importy, a nie drzewa, które parsują reguły treści. Wyróżniły się trzy koszty:
- INW012 na Saleorze trwało 8,0 s, wobec 1,1 s bez niego (oba uruchomione ze źródeł): prawie każdy plik wspomina Django, więc każdy dostawał pełne parsowanie, a każda klasa z bazą z kodu projektu czytała moduł tej bazy. Plik Django potrzebuje teraz kształtu widoku przed parsowaniem (
@api_view,@action,path(...),re_path(...)albo metody handlera w rodzajudef get(, chyba żemoduleszawęża regułę), a bazy rozwiązuje tylko klasa z metodą handlera. Saleor z INW012 zszedł do 1,3 s, z tymi samymi 2 zgłoszeniami. - INW013 na Polarze trwało 7,8 s, około 13 razy dłużej niż sprawdzenie bez niego: krok do innego modułu parsował ten moduł od nowa dla każdego pliku, który do niego wołał. Od #359 każdy moduł odczytany w kroku jest parsowany i czytany raz na uruchomienie, wywołanie metody obiektu z poziomu modułu (
service.create(...)) niczego nie czyta, sprawdzany plik, który krok już sparsował, nie jest parsowany ponownie, a przejścia po ciele funkcji działają wewnątrz WASM. Pomiar przed i po w jednej sesji, naprzemiennie oba pliki binarne, mediana z 5, zimne / ciepłe: Polar z INW013 zszedł z 7 238 / 6 971 ms do 3 526 / 3 182 ms, a ze wszystkimi regułami opt-in z 8 790 / 9 068 ms do 4 984 / 5 052 ms, wobec 454 / 321 ms bez żadnej. Pozostałe cztery repozytoria zmieniły się o mniej niż 10 ms, a zgłoszenia w JSON są identyczne. Zostawały około 3 s: 865 z 1 831 plików Polara maasync defi każdy dostawał pełne parsowanie. Od #369 uruchomienie, w którym co najmniej 200 plików, i co dwudziesty, maasync def, czyta raz tekst każdego modułu z listingu, parsuje tylko moduły, których importy mogą złożyć nazwę blokującego typu (22 w Polarze), i pomija sprawdzany plik, który nie wymienia ani blokującego typu, ani żadnej z ich blokujących funkcji pomocniczych czy jej aliasu. Ta sama metoda, bazadevelopw 06c400d, zimne / ciepłe: Polar z INW013 zszedł z 3 643 / 3 507 ms do 729 / 549 ms, wobec 548 / 353 ms bez niego (+33 %), a ze wszystkimi regułami opt-in z 5 270 / 4 963 ms do 2 329 / 2 105 ms. Saleor (12 plików zasync def) i trzy małe repozytoria zostają poniżej progu i zmieniły się mniej niż szum, a sprawdzenie jednego plikusubscription/service.pyzostało przy 153 ms. Zgłoszenia w JSON są identyczne we wszystkich pięciu repozytoriach i na kopii Polara z blokującymi funkcjami pomocniczymi wołanymi przez reeksporty ze zmianą nazwy, aliasy modułów, importy względne i przekazanąSession. - Wszystkie reguły opt-in na Polarze nadal trwały 2,3 s po #369, około 5 razy dłużej niż sprawdzenie bez nich: INW012, INW014, INW015, INW016, FAPI007 i model FastAPI parsowały czytane pliki każdy osobno, 848 parsowań 450 różnych plików. Od #387 uruchomienie parsuje każdy tekst raz (
ModuleTrees.treeOf), niezależnie od tego, która z tych reguł albo który krok do innego modułu poprosi pierwszy, i zwalnia wszystkie drzewa na końcu uruchomienia. Polar robi teraz 450 pełnych parsowań w wątku głównym (około 490 ms samego parsowania). Ta sama metoda, bazadevelopw 0596d16, mediana z 7, zimne / ciepłe: Polar ze wszystkimi regułami opt-in zszedł z 2 343 / 2 256 ms do 1 925 / 1 789 ms, wobec 455 / 322 ms bez żadnej, czyli 4,2 razy dłużej niż sprawdzenie bez nich, a nie 2 razy, do których dążyło #387. Samo parsowanie tych 450 plików kosztuje mniej więcej tyle co sprawdzenie bez reguł, a większość reszty to praca samych reguł (model i graf FastAPI, widoki INW012); dalszy zysk wymaga wyniesienia reguł treści z wątku głównego albo tańszego kodu reguł. Szczytowe RSS zmieniło się w granicach szumu (567 do 574 MB). Saleor (2 102 do 2 067 ms na zimno) i trzy małe repozytoria (10 do 15 ms szybciej) zmieniły się niewiele, a sprawdzenia jednego plikusubscription/service.py(176 do 158 ms) isubscription/endpoints.py(84 do 78 ms) przyspieszyły. Zgłoszenia w JSON są identyczne we wszystkich pięciu repozytoriach, bez reguł opt-in i ze wszystkimi. - Wszystkie reguły opt-in na Polarze znów trwały 2,4 s po tym, jak #394 nauczyło model klasy routera, którą Polar buduje w czasie działania: reguły czytają 525 operacji ścieżek więcej, a FAPI001 buduje dla nich graf routerów. Profil CPU tego uruchomienia (
bun --cpu-prof) pokazał około 0,65 s parsowania w wątku głównym, a resztę rozłożoną na reguły. Od #395 cztery koszty zniknęły. FAPI002 szło za prawie każdym wywołaniem w endpoincie do modułu, który definiuje jego odbiorcę (items.load(...)do modułu serwisu), i parsowało ten moduł tylko po to, żeby się dowiedzieć, że nazwa nie jest w nim importowana; model czyta teraz importy takiego modułu z jego szkieletu importów i parsuje go tylko wtedy, gdy któryś import wiąże tę nazwę, co na Polarze pomija 123 z 329 parsowań modelu. Adnotacja zwracanego typu funkcji jest rozwiązywana tylko wtedy, gdy funkcja zwraca nazwę, której plik używa jako routera, bo-> Subscriptionparsowało modele. INW012 budowało widoki innych modułów raz na każdy sprawdzany plik, a teraz raz na uruchomienie (ThinEndpointRun). Model FastAPI, INW012, INW016 i FAPI007 przechodziły każde współdzielone drzewo po wywołania, przypisania i definicje kilka razy;moduleNodesprzechodzi drzewo raz dla wszystkich pięciu typów węzłów i trzyma listy, dopóki drzewo żyje. Binaria darwin-arm64, bazadevelopw cf127b7, na przemian, mediana z 7, zimne / ciepłe: Polar ze wszystkimi regułami opt-in zszedł z 2 443 / 2 352 ms do 1 901 / 1 795 ms, wobec 474 / 319 ms bez żadnej, czyli 4,0 razy dłużej niż sprawdzenie bez nich, nadal daleko od 2 razy, których chce #395. Parsowanie plików potrzebnych regułom kosztuje około 0,5 s w wątku głównym, więcej niż budżet 2 razy zostawia na całą pracę reguł, więc dalszy zysk wymaga reguł treści w wątkach roboczych. Saleor zszedł z 1 286 do 1 167 ms na zimno (770 ms bez żadnej), a trzy małe repozytoria przyspieszyły o 11 do 14 ms. Szczytowe RSS zmieniło się w granicach szumu (670 do 647 MB na Polarze). Sprawdzenie jednego plikusubscription/endpoints.pyzeszło z 831 do 658 ms, a jego hook PostToolUse z 1 608 do 1 256 ms; oba nadal są daleko ponad budżetem hooka, bo FAPI001 buduje dla tego pliku cały graf routerów.subscription/service.pyzostało na 156 ms. Zgłoszenia w JSON są identyczne we wszystkich pięciu repozytoriach, bez reguł opt-in i ze wszystkimi.
Hook. #182 wymagało braku mierzalnego spowolnienia hooka na plikach bez endpointów i najwyżej jednego pełnego parsowania na plikach z nimi. inwards check --no-cache <plik>, po 21 naprzemiennych uruchomień, milisekundy p50 / p95:
| Plik | Endpointy | INW012 wyłączone | INW012 włączone |
|---|---|---|---|
saleor order/actions.py (2 110 linii, wspomina Django) |
brak | 33 / 35 | 33 / 35 |
polar subscription/service.py (4 482 linie) |
brak | 60 / 61 | 61 / 64 |
saleor thumbnail/views.py |
brak (jego 2 widoki rejestruje urls.py) |
32 / 33 | 33 / 34 |
polar subscription/endpoints.py (z decorators) |
9 | 29 / 31 | 43 / 50 |
template api/routes/items.py |
5 | 26 / 27 | 32 / 34 |
Przed filtrem dla Django order/actions.py z włączonym INW012 trwało 53 / 54 ms. Plik z endpointami płaci jedno pełne parsowanie, które prescan w innym razie pomija.
Plan poprawy wydajności
| Krok | Oczekiwany efekt | Na co wpływa |
|---|---|---|
inwards daemon: stały proces dla każdego projektu, z którym PostToolUse łączy się przez lokalne gniazdo, z powrotem do jednorazowego uruchomienia; serwer języka zostaje osobnym procesem, inwards server (ADR-039, #60), zrobione |
Zmierzone (wyżej): p95 PostToolUse 39,3 → 16,2 ms dla pliku z 13 liniami, 79,0 → 36,8 ms dla pliku z 4492 liniami edytowanego przed każdym wywołaniem | p95 dla jednego pliku |
| Przyrostowe parsowanie pliku sprawdzanego dwa razy: sprawdzenie hooka teraz i w stanie ze startu sesji, następna edycja w daemonie (#122), zrobione | Zmierzone (wyżej) na pliku z polara z 4482 liniami: p95 PostToolUse 103,9 → 88,4 ms jednorazowo, 62,9 → 31,9 ms przez daemona | p95 dla jednego pliku |
bun build --bytecode (#39), zrobione |
Zmierzone: start 22 → 10 ms, wywołanie hooka około 45% szybsze, 2,5 MB więcej na plik binarny (zobacz eksperyment wyżej) | p95 dla jednego pliku |
| Wątki robocze dla zimnego pełnego uruchomienia (#61, ADR-040), zrobione | Zmierzone przy czterech wątkach (zobacz sekcję wyżej): saleor 1,48 → 0,98 s, polar 0,80 → 0,55 s, repozytorium syntetyczne 0,52 → 0,44 s, syntetyczne w trybie starszego kodu 2,34 → 1,14 s. Daleko do oczekiwanego trzykrotnego przyspieszenia, bo czytanie plików i reguły zostają w jednym wątku | Zimne pełne uruchomienie |
| Tańsza szeregowa część pełnego uruchomienia: rzeczywiste ścieżki per katalog, czytanie jedną partią, workery startowane przed czytaniem, dwie partie na workera (#281), zrobione | Zmierzone przy czterech wątkach (wyżej): saleor 1,09 → 0,87 s, od 1,8 do 2,0× szybciej niż jeden wątek przed #61. Bez zmian na Linuksie z czterema rdzeniami | Zimne pełne uruchomienie |
Pamięć podręczna list importów po hashu zawartości (.inwards/cache, #56), zrobione dla inwards check i inwards baseline |
Zmierzone: ciepłe pełne sprawdzenie 3,0 raza szybsze (0,46 s wobec 1,25 s p50, po 12 uruchomień na tym laptopie pod obciążeniem), o 27% wolniejsze, gdy pamięć podręczna się wypełnia. Hooki z niej nie korzystają (ADR-031) | Ciepłe pełne uruchomienie |
Przejście kursorem po drzewie zamiast descendantsOfType na ścieżce pełnego parsowania (#62), zrobione |
Zmierzone na 2100 syntetycznych plikach, na zimno, po 10 naprzemiennych uruchomień: o 13% szybciej, gdy każdy plik wymaga potwierdzenia (3,34 → 2,90 s p50), o 10% szybciej, gdy prescan odrzuca każdy plik (3,13 → 2,80 s). Odczyt importów i komentarzy wyciszających z 1059 plików biblioteki standardowej spadł z około 560 ms do 125 ms. Hook dla jednego pliku i czyste pełne sprawdzenie się nie zmieniają | Odrzucone pliki i potwierdzenia |
Odtworzenie
bun install
bun test                                                    # 2,500+ tests: unit, CLI, hook, Stop gate, baseline, stats, E2E snapshots, doc snippets, bench
bun run scripts/build-binaries.ts bun-linux-x64
python3 bench/generate.py /tmp/inwards-bench
(cd /tmp/inwards-bench && "$OLDPWD/dist/inwards-linux-x64" check)  # 2100 files, 0 violations, ms
bun run src/core/scripts/prescan-diff.ts "$(python3 -c 'import sysconfig; print(sysconfig.get_paths()["stdlib"])')"
bun run bench/corpus.ts --bin dist/inwards-linux-x64 --dir ~/.cache/inwards-corpus  # real-repo corpus, about 90 s
bench/corpus.ts ponownie używa checkoutu, który jest już na przypiętym commicie, więc kolejne uruchomienia niczego nie pobierają. Żeby dodać repozytorium, dopisz je do bench/corpus.json z pełnym SHA commitu, liczbą plików .py i podziałem na warstwy; PR uruchomi workflow korpusu.
Dwa sprawdzenia pilnują, żeby testy dotyczące agentów były wiarygodne. Blok kodu w docs/chapters/guides albo docs/chapters/rules, który następuje po linii <!-- e2e --> i jednej pustej linii (bez niej komentarz psuje element listy), uruchamia się jako przypadek E2E w świeżym projekcie, w CI na skompilowanym pliku binarnym (src/cli/test/integration/docs.test.ts); nieoznaczone bloki nigdy się nie uruchamiają. Bloki działają w systemowym bashu, który na macOS jest w wersji 3.2, więc test nigdy nie umieszcza heredoca wewnątrz $(...): bash 3.2 dopasowuje przez niego cudzysłowy i jeden apostrof w udokumentowanym komunikacie psuje skrypt. Co noc .github/workflows/nightly-e2e.yml nagrywa ponownie dane wejściowe hooków Claude Code w nieinteraktywnej sesji (headless) claude -p i otwiera zgłoszenie, gdy jakieś pole zostanie dodane, usunięte albo zmieni typ względem nagranych fixture'ów.
Zrzuty ekranu w tej dokumentacji pochodzą ze scripts/screenshots.py, który naprawdę uruchamia każde polecenie i renderuje wyjście terminala za pomocą Rich.
Ryzyka
| Ryzyko | Prawdopodobieństwo | Wpływ | Środki zaradcze |
|---|---|---|---|
| Astral dodaje kontrakty warstw do ty albo Ruffa | Średnie | Wysoki | Konkurować integracją z agentami i jakością poprawek, na których Astral się nie skupia. Utrzymywać format reguł na tyle prosty, żeby dało się go wyeksportować |
| import-linter dodaje wyjście JSON i hooki dla agentów | Średnie | Średni | Utrzymać przewagę w opóźnieniu, samodzielnym pliku binarnym i poprawkach dla każdego naruszenia. Utrzymać przejście na jedno polecenie: inwards import-config przenosi kontrakty import-linter (przewodnik) |
| Prawdziwe repozytoria przekraczają 100 ms p95 | Wydarzyło się: plik z polara z 4482 liniami i naruszeniami trwał 125 do 280 ms przed kompilacją do bajtkodu, a jego jednorazowy hook lokalnie około 104 ms p95 po niej. Teraz 88 ms jednorazowo i 32 ms przez daemona (#122) | Wysoki | inwards daemon (ADR-039) i przyrostowe drugie parsowanie, oba zrobione; zadanie benchmarku mierzy plik tej wielkości w każdym PR. Potem prescan w WASM napisany w Ruście albo Zigu (plan awaryjny z ADR-001) |
| Prescan pomija import w jakimś nietypowym pliku | Niskie | Wysoki | Test różnicowy w CI na bibliotece standardowej, co noc na pięciu prawdziwych serwisach; poszerzać ten korpus o repozytoria design partnerów |
Agenci edytują [tool.inwards], żeby przejść sprawdzenie |
Wysokie bez zabezpieczenia | Wysoki | Config guard w PreToolUse, porównanie konfiguracji w Stop gate, reguły permissions.deny z init, CODEOWNERS (rozdział 4). Bash wciąż może ominąć config guard; odtworzony start sesji wykrywa kopia zapisu startu poza projektem, chyba że agent usunie też ją, a hook Stop usunięty przez Bash jest zgłaszany dopiero przy starcie następnej sesji (#88) |
Regresje albo niekompatybilne zmiany w --compile Buna |
Niskie | Średni | Wersja przypięta przez .bun-version; macierz weryfikacji w CD uruchamia każdy plik binarny |
| Plik binarny po cichu ignoruje swój bajtkod (Bun wraca do parsowania źródła) i start wydłuża się dwukrotnie | Niskie | Niski | Testy w takim przypadku nadal przechodzą; benchmark w PR wyłapuje to tylko na Linuksie. Bajtkod jest związany z wersją Buna, która go zbudowała, a każdy plik binarny osadza tę samą wersję |
| Część CI działająca na infrastrukturze self-hosted jest niedostępna, a zadania PR, które tam trafiają, czekają w kolejce | Średnie | Średni | Dla oszczędności limitów i kosztów GitHub Actions część automatycznych zadań CI działa na infrastrukturze self-hosted; gdy jest niedostępna, te zadania mogą działać na runnerach GitHuba |
| Zensical (0.0.x) zmienia format konfiguracji | Średnie | Niski | Build dokumentacji działa w CI przy każdym PR; konfiguracja jest mała |
| Kroki naprawy są błędne dla nietypowych układów (brak oczywistego miejsca na port) | Średnie | Średni | Mierzyć naprawę w ramach jednej ponownej próby dla każdej reguły; pozwolić konfiguracji wskazać moduł portów |